
Diffusers documentation
Hiểu về pipelines, models và schedulers
Hiểu về pipelines, models và schedulers
🧨 Diffusers được thiết kế như một bộ công cụ thân thiện với người dùng và linh hoạt để xây dựng các hệ thống diffusion phù hợp với nhu cầu sử dụng của bạn. Nền tảng cốt lõi của bộ công cụ là các model và scheduler. Trong khi DiffusionPipeline đóng gói các thành phần này lại với nhau để tiện lợi, bạn cũng có thể tách pipeline ra và sử dụng các model và scheduler riêng biệt để tạo ra các hệ thống diffusion mới.
Trong hướng dẫn này, bạn sẽ học cách sử dụng các mô hình và trình lập lịch để lắp ráp một hệ thống khuếch tán cho suy luận, bắt đầu từ một pipeline cơ bản và sau đó tiến tới pipeline Stable Diffusion.
Phân tích một pipeline cơ bản
Pipeline là cách nhanh chóng và dễ dàng để chạy mô hình suy luận, chỉ cần không quá bốn dòng mã để tạo ra một hình ảnh:
>>> from diffusers import DDPMPipeline

>>> ddpm = DDPMPipeline.from_pretrained("google/ddpm-cat-256", use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
>>> image = ddpm(num_inference_steps=25).images[0]
>>> image
Điều đó thật dễ dàng, nhưng pipeline đã thực hiện điều đó như thế nào? Hãy phân tích pipeline và xem những gì đang diễn ra bên trong.
Trong ví dụ trên, pipeline chứa một mô hình UNet2DModel và một DDPMScheduler. Pipeline khử nhiễu một hình ảnh bằng cách lấy nhiễu ngẫu nhiên có kích thước của đầu ra mong muốn và đưa nó qua mô hình nhiều lần. Tại mỗi bước thời gian, mô hình dự đoán phần dư nhiễu và trình lập lịch sử dụng nó để dự đoán một hình ảnh ít nhiễu hơn. Pipeline lặp lại quá trình này cho đến khi đạt đến cuối số bước suy luận được chỉ định.
Để tạo lại pipeline với model và scheduler riêng biệt, hãy viết quy trình khử nhiễu của riêng chúng ta.
- Tải mô hình và trình lập lịch:
>>> from diffusers import DDPMScheduler, UNet2DModel

>>> scheduler = DDPMScheduler.from_pretrained("google/ddpm-cat-256")
>>> model = UNet2DModel.from_pretrained("google/ddpm-cat-256", use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"- Đặt số bước thời gian để chạy quá trình khử nhiễu:
>>> scheduler.set_timesteps(50)- Việc thiết lập các bước thời gian (timesteps) của trình lập lịch tạo ra một tensor chứa các phần tử cách đều nhau, trong ví dụ này là 50 phần tử. Mỗi phần tử tương ứng với một bước thời gian mà mô hình khử nhiễu một hình ảnh. Khi bạn tạo vòng lặp khử nhiễu sau đó, bạn sẽ lặp qua tensor này để khử nhiễu hình ảnh:
>>> scheduler.timesteps
tensor([980, 960, 940, 920, 900, 880, 860, 840, 820, 800, 780, 760, 740, 720,
    700, 680, 660, 640, 620, 600, 580, 560, 540, 520, 500, 480, 460, 440,
    420, 400, 380, 360, 340, 320, 300, 280, 260, 240, 220, 200, 180, 160,
140, 120, 100, 80, 60, 40, 20, 0])- Tạo một số nhiễu ngẫu nhiên có cùng hình dạng với đầu ra mong muốn:
>>> import torch

>>> sample_size = model.config.sample_size
>>> noise = torch.randn((1, 3, sample_size, sample_size), device="cuda") # or "mps", "xpu", "cpu"- Bây giờ hãy viết một vòng lặp để lặp qua các bước thời gian (timesteps). Tại mỗi bước thời gian, mô hình thực hiện một lượt UNet2DModel.forward() và trả về phần dư nhiễu (noisy residual). Phương thức step() của trình lập lịch (scheduler) nhận phần dư nhiễu, bước thời gian và đầu vào, sau đó dự đoán ảnh tại bước thời gian trước. Đầu ra này trở thành đầu vào tiếp theo cho mô hình trong vòng lặp khử nhiễu, và quá trình sẽ lặp lại cho đến khi hết mảng
timesteps.
>>> input = noise

>>> for t in scheduler.timesteps:
...     with torch.no_grad():
...         noisy_residual = model(input, t).sample
...     previous_noisy_sample = scheduler.step(noisy_residual, t, input).prev_sample
...     input = previous_noisy_sample
Đây là toàn bộ quá trình khử nhiễu, và bạn có thể sử dụng cùng một mẫu này để viết bất kỳ hệ thống khuếch tán nào.
- Bước cuối cùng là chuyển đổi đầu ra đã khử nhiễu thành một hình ảnh:
>>> from PIL import Image
>>> import numpy as np

>>> image = (input / 2 + 0.5).clamp(0, 1).squeeze()
>>> image = (image.permute(1, 2, 0) * 255).round().to(torch.uint8).cpu().numpy()
>>> image = Image.fromarray(image)
>>> image
Trong phần tiếp theo, bạn sẽ thử thách kỹ năng của mình và phân tích chi tiết pipeline Stable Diffusion phức tạp hơn. Các bước về cơ bản là giống nhau. Bạn sẽ khởi tạo các thành phần cần thiết và đặt số lượng bước thời gian để tạo mảng timestep. Mảng timestep được sử dụng trong vòng lặp khử nhiễu, và với mỗi phần tử trong mảng này, mô hình dự đoán một hình ảnh ít nhiễu hơn. Vòng lặp khử nhiễu lặp qua các timestep, và ở mỗi bước thời gian, nó xuất ra một phần dư có nhiễu và trình lập lịch sử dụng nó để dự đoán một hình ảnh ít nhiễu hơn ở bước thời gian trước đó. Quá trình này được lặp lại cho đến khi bạn đến cuối mảng timestep.
Hãy thử ngay!
Phân rã pipeline Stable Diffusion
Stable Diffusion là một mô hình latent diffusion từ văn bản sang hình ảnh. Nó được gọi là mô hình latent diffusion vì nó hoạt động với một biểu diễn có số chiều thấp hơn của hình ảnh thay vì không gian pixel thực tế, giúp tiết kiệm bộ nhớ hơn. Encoder nén hình ảnh thành một biểu diễn nhỏ hơn, và decoder chuyển đổi biểu diễn đã nén đó trở lại thành hình ảnh. Đối với các mô hình từ văn bản sang hình ảnh, bạn sẽ cần một tokenizer và một encoder để tạo ra các text embeddings. Từ ví dụ trước, bạn đã biết rằng cần một mô hình UNet và một scheduler.
Như bạn có thể thấy, điều này đã phức tạp hơn so với pipeline DDPM chỉ chứa một mô hình UNet. Mô hình Stable Diffusion có ba mô hình được huấn luyện trước riêng biệt.
💡 Đọc blog Stable Diffusion hoạt động như thế nào? để biết thêm chi tiết về cách các mô hình VAE, UNet và text encoder hoạt động.
Bây giờ bạn đã biết những gì cần thiết cho pipeline Stable Diffusion, hãy tải tất cả các thành phần này bằng phương thức from_pretrained(). Bạn có thể tìm thấy chúng trong checkpoint stable-diffusion-v1-5/stable-diffusion-v1-5 đã được huấn luyện trước, và mỗi thành phần được lưu trữ trong một thư mục con riêng biệt:
>>> from PIL import Image
>>> import torch
>>> from transformers import CLIPTextModel, CLIPTokenizer
>>> from diffusers import AutoencoderKL, UNet2DConditionModel, PNDMScheduler

>>> vae = AutoencoderKL.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="vae", use_safetensors=True)
>>> tokenizer = CLIPTokenizer.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="tokenizer")
>>> text_encoder = CLIPTextModel.from_pretrained(
...     "CompVis/stable-diffusion-v1-4", subfolder="text_encoder", use_safetensors=True
... )
>>> unet = UNet2DConditionModel.from_pretrained(
...     "CompVis/stable-diffusion-v1-4", subfolder="unet", use_safetensors=True
... )
Thay vì PNDMScheduler mặc định, hãy thay thế bằng UniPCMultistepScheduler để thấy việc gắn một scheduler khác vào dễ dàng đến mức nào:
>>> from diffusers import UniPCMultistepScheduler

>>> scheduler = UniPCMultistepScheduler.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="scheduler")
Để tăng tốc suy luận, hãy chuyển các mô hình sang GPU vì, khác với trình lập lịch, chúng có trọng số có thể huấn luyện:
>>> torch_device = "cuda"  # or "mps", "xpu", "cpu"
>>> vae.to(torch_device)
>>> text_encoder.to(torch_device)
>>> unet.to(torch_device)
Tạo nhúng văn bản
Bước tiếp theo là thực hiện tokenize văn bản để tạo ra các embedding. Văn bản được sử dụng để điều kiện hóa mô hình UNet và định hướng quá trình khuếch tán hướng đến kết quả giống với prompt đầu vào.
💡 Tham số
guidance_scalexác định mức độ ưu tiên cần dành cho prompt khi tạo ảnh.
Hãy tự do chọn bất kỳ prompt nào bạn thích nếu muốn tạo ra nội dung khác!
>>> prompt = ["a photograph of an astronaut riding a horse"]
>>> height = 512  # default height of Stable Diffusion
>>> width = 512  # default width of Stable Diffusion
>>> num_inference_steps = 25  # Number of denoising steps
>>> guidance_scale = 7.5  # Scale for classifier-free guidance
>>> generator = torch.manual_seed(0)  # Seed generator to create the initial latent noise
>>> batch_size = len(prompt)
Tokenize văn bản và tạo các embeddings từ prompt:
>>> text_input = tokenizer(
...     prompt, padding="max_length", max_length=tokenizer.model_max_length, truncation=True, return_tensors="pt"
... )

>>> with torch.no_grad():
...     text_embeddings = text_encoder(text_input.input_ids.to(torch_device))[0]
Bạn cũng cần tạo unconditional text embeddings, tức là các embedding cho token padding. Chúng cần có cùng hình dạng (batch_size và seq_length) với text_embeddings có điều kiện:
>>> max_length = text_input.input_ids.shape[-1]
>>> uncond_input = tokenizer([""] * batch_size, padding="max_length", max_length=max_length, return_tensors="pt")
>>> uncond_embeddings = text_encoder(uncond_input.input_ids.to(torch_device))[0]
Hãy nối các embedding có điều kiện và không có điều kiện thành một batch để tránh thực hiện hai lần truyền tiến:
>>> text_embeddings = torch.cat([uncond_embeddings, text_embeddings])Tạo nhiễu ngẫu nhiên
Tiếp theo, hãy tạo một số nhiễu ngẫu nhiên ban đầu làm điểm khởi đầu cho quá trình khuếch tán. Đây là biểu diễn ẩn của hình ảnh, và nó sẽ được khử nhiễu dần dần. Ở thời điểm này, hình ảnh latent có kích thước nhỏ hơn kích thước hình ảnh cuối cùng, nhưng điều đó không sao vì mô hình sẽ biến đổi nó thành kích thước hình ảnh 512x512 cuối cùng sau đó.
💡 Chiều cao và chiều rộng được chia cho 8 vì mô hình
vaecó 3 lớp hạ mẫu. Bạn có thể kiểm tra bằng cách chạy lệnh sau:2 ** (len(vae.config.block_out_channels) - 1) == 8
>>> latents = torch.randn(
...     (batch_size, unet.config.in_channels, height // 8, width // 8),
...     generator=generator,
...     device=torch_device,
... )
Loại bỏ nhiễu khỏi hình ảnh
Bắt đầu bằng cách chuẩn hóa đầu vào theo phân phối nhiễu ban đầu, sigma, giá trị tỷ lệ nhiễu, cần thiết cho các trình lập lịch cải tiến như UniPCMultistepScheduler:
>>> latents = latents * scheduler.init_noise_sigmaBước cuối cùng là tạo vòng lặp khử nhiễu sẽ dần biến đổi nhiễu thuần túy trong latents thành một hình ảnh được mô tả bởi prompt của bạn. Hãy nhớ rằng, vòng lặp khử nhiễu cần thực hiện ba việc:
- Đặt các bước thời gian (timesteps) của trình lập lịch (scheduler) để sử dụng trong quá trình khử nhiễu (denoising).
- Lặp qua các bước thời gian.
- Tại mỗi bước thời gian, gọi mô hình UNet để dự đoán phần dư nhiễu và truyền nó cho trình lập lịch để tính toán mẫu nhiễu trước đó.
>>> from tqdm.auto import tqdm

>>> scheduler.set_timesteps(num_inference_steps)

>>> for t in tqdm(scheduler.timesteps):
...     # expand the latents if we are doing classifier-free guidance to avoid doing two forward passes.
...     latent_model_input = torch.cat([latents] * 2)

...     latent_model_input = scheduler.scale_model_input(latent_model_input, timestep=t)

...     # predict the noise residual
...     with torch.no_grad():
...         noise_pred = unet(latent_model_input, t, encoder_hidden_states=text_embeddings).sample

...     # perform guidance
...     noise_pred_uncond, noise_pred_text = noise_pred.chunk(2)
...     noise_pred = noise_pred_uncond + guidance_scale * (noise_pred_text - noise_pred_uncond)

...     # compute the previous noisy sample x_t -> x_t-1
...     latents = scheduler.step(noise_pred, t, latents).prev_sample
Giải mã hình ảnh
Bước cuối cùng là sử dụng vae để giải mã biểu diễn ẩn thành hình ảnh và lấy đầu ra đã giải mã bằng sample:
# scale and decode the image latents with vae
latents = 1 / 0.18215 * latents
with torch.no_grad():
    image = vae.decode(latents).sample
Cuối cùng, chuyển đổi hình ảnh sang PIL.Image để xem hình ảnh bạn đã tạo!
>>> image = (image / 2 + 0.5).clamp(0, 1).squeeze()
>>> image = (image.permute(1, 2, 0) * 255).to(torch.uint8).cpu().numpy()
>>> image = Image.fromarray(image)
>>> image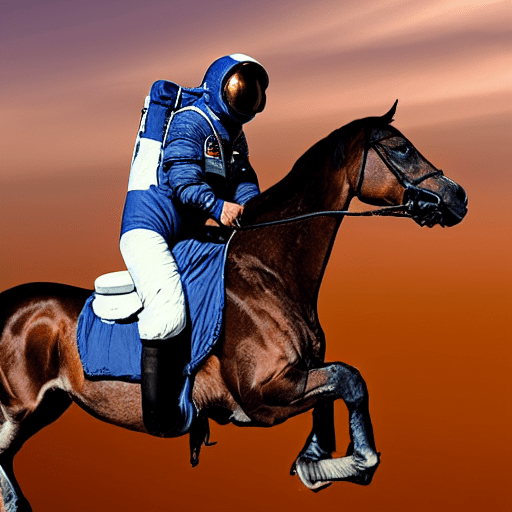
Các bước tiếp theo
Từ các pipeline cơ bản đến phức tạp, bạn đã thấy rằng điều duy nhất thực sự cần để viết hệ thống diffusion của riêng mình là một vòng lặp khử nhiễu. Vòng lặp này nên thiết lập các bước thời gian (timesteps) của scheduler, lặp qua chúng, và luân phiên giữa việc gọi mô hình UNet để dự đoán phần dư nhiễu và truyền nó cho scheduler để tính toán mẫu nhiễu trước đó.
Đây chính là mục đích mà 🧨 Diffusers được thiết kế: giúp việc tự viết hệ thống khuếch tán của bạn bằng cách sử dụng các mô hình và trình lập lịch trở nên trực quan và dễ dàng.
Các bước tiếp theo, bạn có thể:
- Tìm hiểu cách xây dựng và đóng góp một pipeline cho 🧨 Diffusers. Chúng tôi rất mong chờ xem bạn sẽ tạo ra điều gì!
- Khám phá các pipeline có sẵn trong thư viện và xem liệu bạn có thể phân rã và xây dựng một pipeline từ đầu bằng cách sử dụng các model và scheduler riêng biệt hay không.