
Diffusers documentation
Kandinsky 2.1
Kandinsky 2.1
Kandinsky 2.1 создан Арсением Шахматовым, Антоном Разжигаевым, Александром Николичем, Владимиром Архипкиным, Игорем Павловым, Андреем Кузнецовым и Денисом Димитровым.
Описание с его страницы на GitHub:
Kandinsky 2.1 наследует лучшие практики от Dall-E 2 и Latent diffusion, одновременно вводя ряд новых идей. В качестве текстового и изображенийого энкодера используется модель CLIP, а также диффузионный априорный (mapping) между латентными пространствами модальностей CLIP. Такой подход повышает визуальное качество модели и открывает новые возможности для смешивания изображений и манипуляций с изображениями по текстовому руководству.
Исходный код можно найти в репозитории ai-forever/Kandinsky-2.
Ознакомьтесь с организацией Kandinsky Community на Hub, где размещены официальные контрольные точки моделей для таких задач, как генерация изображений по тексту, преобразование изображения в изображение и инпейнтинг.
Обязательно ознакомьтесь с руководством по планировщикам, чтобы узнать, как исследовать баланс между скоростью и качеством планировщика, а также с разделом повторное использование компонентов в разных конвейерах, чтобы узнать, как эффективно загружать одни и те же компоненты в несколько конвейеров.
Убедитесь, что у вас установлены следующие библиотеки.
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate
Использование Kandinsky 2.1 и 2.2 очень похоже! Единственное отличие состоит в том, что Kandinsky 2.2 не принимает
promptв качестве входного параметра при декодировании латентов. Вместо этого Kandinsky 2.2 принимает толькоimage_embedsво время декодирования.
Архитектура Kandinsky 3 более компактная, и для её работы не требуется предварительная модель. Это означает, что её использование идентично другим диффузионным моделям, таким как Stable Diffusion XL.
Текст в изображение
Чтобы использовать модели Kandinsky для любой задачи, всегда начинайте с настройки prior-пайплайна для кодирования промпта и генерации эмбеддингов изображения. Prior-пайплайн также генерирует negative_image_embeds, соответствующие негативному промпту "". Для лучших результатов вы можете передать в prior-пайплайн реальный negative_prompt, но это увеличит эффективный размер батча prior-пайплайна в 2 раза.
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt, guidance_scale=1.0).to_tuple()
Теперь передайте все промпты и эмбеддинги в KandinskyPipeline для генерации изображения:
image = pipeline(prompt, image_embeds=image_embeds, negative_prompt=negative_prompt, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
import torch

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, guidance_scale=1.0).to_tuple()
Передайте image_embeds и negative_image_embeds в KandinskyV22Pipeline, чтобы сгенерировать изображение:
image = pipeline(image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
Kandinsky 3 не требует предварительной загрузки модели, поэтому можно напрямую загрузить Kandinsky3Pipeline и передать промпт для генерации изображения:
from diffusers import Kandinsky3Pipeline
import torch

pipeline = Kandinsky3Pipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
image = pipeline(prompt).images[0]
image
🤗 Diffusers также предоставляет сквозной API с KandinskyCombinedPipeline и KandinskyV22CombinedPipeline, что означает, что вам не нужно отдельно загружать prior и text-to-image pipeline. Комбинированный pipeline автоматически загружает как prior-модель, так и декодер. При необходимости вы по-прежнему можете задавать разные значения для prior pipeline с помощью параметров prior_guidance_scale и prior_num_inference_steps.
Используйте AutoPipelineForText2Image, чтобы автоматически вызывать объединённые пайплайны под капотом:
from diffusers import AutoPipelineForText2Image
import torch

pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
imagefrom diffusers import AutoPipelineForText2Image
import torch
pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
imageИзображение в изображение
Для задачи image-to-image передайте начальное изображение и текстовый промпт, задающий условия для изображения, в пайплайн. Начните с загрузки пайплайна prior:
import torch
from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyImg2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")import torch
from diffusers import KandinskyV22Img2ImgPipeline, KandinskyPriorPipeline
prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")Kandinsky 3 не требует предварительной модели, поэтому вы можете напрямую загрузить пайплайн image-to-image:
from diffusers import Kandinsky3Img2ImgPipeline
from diffusers.utils import load_image
import torch

pipeline = Kandinsky3Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
Скачайте изображение для использования в качестве условия:
from diffusers.utils import load_image

# download image
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image = original_image.resize((768, 512))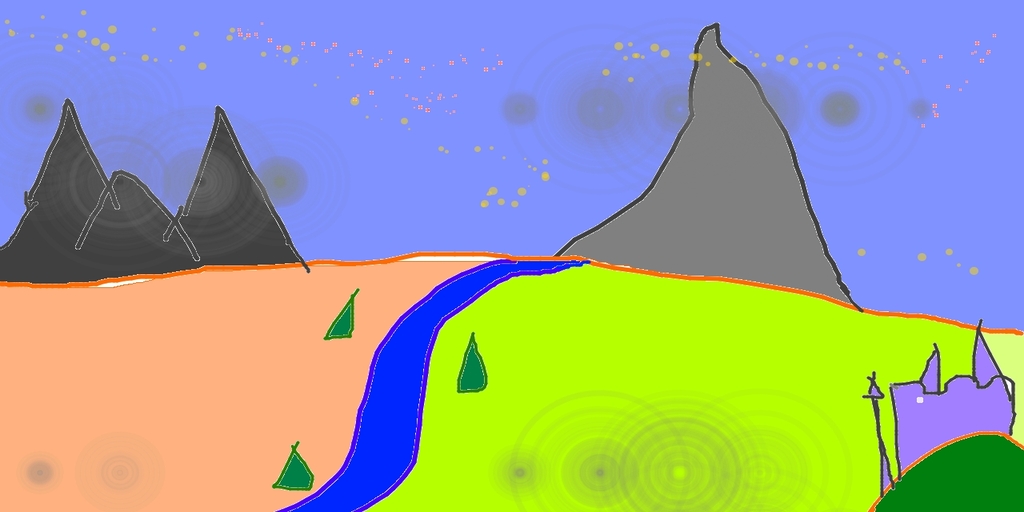
Сгенерируйте image_embeds и negative_image_embeds с помощью предыдущего конвейера:
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt).to_tuple()
Теперь передайте исходное изображение, а также все промпты и эмбеддинги в конвейер для генерации изображения:
from diffusers.utils import make_image_grid

image = pipeline(prompt, negative_prompt=negative_prompt, image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
from diffusers.utils import make_image_grid

image = pipeline(image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
image = pipeline(prompt, negative_prompt=negative_prompt, image=image, strength=0.75, num_inference_steps=25).images[0]
image
🤗 Diffusers также предоставляет API для сквозной работы с KandinskyImg2ImgCombinedPipeline и KandinskyV22Img2ImgCombinedPipeline, что означает, что вам не нужно отдельно загружать prior и image-to-image pipeline. Комбинированный pipeline автоматически загружает как prior-модель, так и декодер. При необходимости вы по-прежнему можете задавать разные значения для prior pipeline с помощью параметров prior_guidance_scale и prior_num_inference_steps.
Используйте AutoPipelineForImage2Image, чтобы автоматически вызывать объединённые пайплайны под капотом:
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch

pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True)
pipeline.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)

original_image.thumbnail((768, 768))

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch
pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image.thumbnail((768, 768))
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)Инпейнтинг
⚠️ Модели Kandinsky теперь используют ⬜️ белые пиксели для представления маскированной области вместо чёрных пикселей. Если вы используете KandinskyInpaintPipeline в продакшене, вам необходимо изменить маску, чтобы использовать белые пиксели:
# For PIL input
import PIL.ImageOps
mask = PIL.ImageOps.invert(mask)

# For PyTorch and NumPy input
mask = 1 - mask
Для инпейнтинга вам понадобятся исходное изображение, маска области, которую нужно заменить в исходном изображении, и текстовый промпт с описанием того, что нужно инпейнтить. Загрузите ранее созданный пайплайн:
from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyInpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")from diffusers import KandinskyV22InpaintPipeline, KandinskyV22PriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22InpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")Загрузите исходное изображение и создайте маску:
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
Сгенерируйте эмбеддинги с помощью предыдущего конвейера:
prompt = "a hat"
prior_output = prior_pipeline(prompt)
Теперь передайте начальное изображение, маску, промпт и эмбеддинги в конвейер для генерации изображения:
output_image = pipeline(prompt, image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
output_image = pipeline(image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
Вы также можете использовать конвейеры KandinskyInpaintCombinedPipeline и KandinskyV22InpaintCombinedPipeline, которые под капотом объединяют вызовы конвейеров prior и decoder. Для этого используйте AutoPipelineForInpainting:
import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid

pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()

init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"

output_image = pipe(prompt=prompt, image=init_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid
pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"
output_image = pipe(prompt=prompt, image=original_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)Интерполяция
Интерполяция позволяет исследовать латентное пространство между эмбеддингами изображения и текста, что является удобным способом увидеть некоторые промежуточные выводы модели-предшественника. Загрузите пайплайн предшественника и два изображения, которые вы хотите интерполировать:
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
from diffusers.utils import load_image, make_image_grid
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
from diffusers.utils import load_image, make_image_grid
import torch
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)

Укажите текст или изображения для интерполяции и задайте веса для каждого текста или изображения. Экспериментируйте с весами, чтобы увидеть, как они влияют на интерполяцию!
images_texts = ["a cat", img_1, img_2]
weights = [0.3, 0.3, 0.4]
Вызовите функцию interpolate, чтобы сгенерировать эмбеддинги, а затем передайте их в пайплайн для генерации изображения:
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
ControlNet
⚠️ ControlNet поддерживается только для Kandinsky 2.2!
ControlNet позволяет использовать дополнительные входные данные, такие как карта глубины или результат детекции границ, для управления крупными предобученными диффузионными моделями. Например, вы можете задать Kandinsky 2.2 карту глубины в качестве условия, чтобы модель понимала и сохраняла структуру изображения глубины.
Загрузим изображение и извлечём карту глубины:
from diffusers.utils import load_image

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))
img
Затем можно использовать Pipeline depth-estimation из 🤗 Transformers для обработки изображения и получения карты глубины:
import torch
import numpy as np

from transformers import pipeline

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
Текст в изображение
Загрузите предыдущий конвейер и KandinskyV22ControlnetPipeline:
from diffusers import KandinskyV22PriorPipeline, KandinskyV22ControlnetPipeline

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
Сгенерируйте эмбеддинги изображений из промпта и негативного промпта:
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

image_emb, zero_image_emb = prior_pipeline(
    prompt=prompt, negative_prompt=negative_prior_prompt, generator=generator
).to_tuple()
Наконец, передайте эмбеддинги изображения и изображение глубины в KandinskyV22ControlnetPipeline для генерации изображения:
image = pipeline(image_embeds=image_emb, negative_image_embeds=zero_image_emb, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
image
Изображение в изображение
Для image-to-image с ControlNet вам нужно использовать:
- KandinskyV22PriorEmb2EmbPipeline для генерации эмбеддингов изображений на основе текстового промпта и изображения
- KandinskyV22ControlnetImg2ImgPipeline для генерации изображения на основе исходного изображения и эмбеддингов изображения
Обработайте и извлеките карту глубины исходного изображения кошки с помощью Pipeline depth-estimation из 🤗 Transformers:
import torch
import numpy as np

from diffusers import KandinskyV22PriorEmb2EmbPipeline, KandinskyV22ControlnetImg2ImgPipeline
from diffusers.utils import load_image
from transformers import pipeline

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
Загрузите предыдущий конвейер и KandinskyV22ControlnetImg2ImgPipeline:
prior_pipeline = KandinskyV22PriorEmb2EmbPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetImg2ImgPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
Передайте текстовый промпт и исходное изображение в конвейер prior для генерации эмбеддингов изображения:
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

img_emb = prior_pipeline(prompt=prompt, image=img, strength=0.85, generator=generator)
negative_emb = prior_pipeline(prompt=negative_prior_prompt, image=img, strength=1, generator=generator)
Теперь вы можете запустить KandinskyV22ControlnetImg2ImgPipeline, чтобы сгенерировать изображение на основе исходного изображения и эмбеддингов изображения:
image = pipeline(image=img, strength=0.5, image_embeds=img_emb.image_embeds, negative_image_embeds=negative_emb.image_embeds, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
make_image_grid([img.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
Оптимизации
Kandinsky уникален тем, что для генерации соответствий требуется предварительный конвейер, а для декодирования латентов в изображение — второй конвейер. Усилия по оптимизации следует сосредоточить на втором конвейере, поскольку именно там выполняется основная часть вычислений. Ниже приведены несколько советов по улучшению Kandinsky на этапе инференса.
- Включите xFormers, если вы используете PyTorch < 2.0:
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_xformers_memory_efficient_attention()- Включите
torch.compile, если вы используете PyTorch >= 2.0, чтобы автоматически применять масштабированное внимание на основе скалярного произведения (SDPA):
  pipe.unet.to(memory_format=torch.channels_last)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
Это то же самое, что и явное указание процессора внимания AttnAddedKVProcessor2_0:
from diffusers.models.attention_processor import AttnAddedKVProcessor2_0

pipe.unet.set_attn_processor(AttnAddedKVProcessor2_0())- Перенесите модель на CPU с помощью enable_model_cpu_offload(), чтобы избежать ошибок нехватки памяти:
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_model_cpu_offload()- По умолчанию конвейер text-to-image использует DDIMScheduler, но вы можете заменить его на другой планировщик, например DDPMScheduler, чтобы оценить влияние на баланс между скоростью инференса и качеством изображения:
from diffusers import DDPMScheduler
from diffusers import DiffusionPipeline

scheduler = DDPMScheduler.from_pretrained("kandinsky-community/kandinsky-2-1", subfolder="ddpm_scheduler")
pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", scheduler=scheduler, dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
KandinskyPriorPipeline
класс diffusers.KandinskyPriorPipeline
< source >( prior: PriorTransformerimage_encoder: CLIPVisionModelWithProjectiontext_encoder: CLIPTextModelWithProjectiontokenizer: CLIPTokenizerscheduler: UnCLIPSchedulerimage_processor: CLIPImageProcessorPil )
Параметры
- prior (PriorTransformer) — канонический prior unCLIP для приближения эмбеддинга изображения по эмбеддингу текста.
- image_encoder (
CLIPVisionModelWithProjection) — Замороженный кодировщик изображений. - text_encoder (
CLIPTextModelWithProjection) — Замороженный текстовый энкодер. - tokenizer (
CLIPTokenizer) — токенизатор класса CLIPTokenizer. - scheduler (
UnCLIPScheduler) — планировщик, используемый в сочетании сpriorдля генерации эмбеддинга изображения.
Пайплайн для генерации image prior для Kandinsky
Эта модель наследуется от DiffusionPipeline. См. документацию родительского класса для общих методов, которые библиотека реализует для всех пайплайнов (например, загрузка или сохранение, запуск на конкретном устройстве и т. д.)
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneguidance_scale: float = 4.0output_type: str | None = 'pt'return_dict: bool = True ) → KandinskyPriorPipelineOutput or tuple
Параметры
- prompt (
strилиlist[str]) — Промпт или промпты для управления генерацией изображения. - negative_prompt (
strилиlist[str], необязательный) — Промпт или промпты, которые не должны направлять генерацию изображения. Игнорируется, если не используется направляющее влияние (то есть игнорируется, еслиguidance_scaleменьше1). - num_images_per_prompt (
int, необязательный, по умолчанию 1) — Количество изображений, генерируемых для каждого промпта. - num_inference_steps (
int, необязательный, по умолчанию 25) — Количество шагов денойзинга. Как правило, большее число шагов денойзинга приводит к изображению более высокого качества, но за счёт более медленного вывода. - generator (
torch.Generatorилиlist[torch.Generator], необязательный) — Один или список генераторов torch для обеспечения детерминированности генерации. - latents (
torch.Tensor, необязательный) — Предварительно сгенерированные зашумлённые латенты, выбранные из гауссова распределения, которые используются в качестве входных данных для генерации изображений. Позволяет корректировать один и тот же процесс генерации с помощью различных промптов. Если не заданы, тензор латентов будет сгенерирован путём выборки с использованием переданного случайногоgenerator. - guidance_scale (
float, необязательный, по умолчанию 4.0) — Масштаб руководства, как определено в Classifier-Free Diffusion Guidance.guidance_scaleопределяется какwиз уравнения 2 статьи Imagen Paper. Масштаб руководства включается при установкеguidance_scale > 1. Более высокий масштаб руководства способствует генерации изображений, тесно связанных с текстомprompt, обычно за счёт снижения качества изображения. - output_type (
str, необязательный, по умолчанию"pt") — Формат вывода сгенерированного изображения. Выберите один из вариантов:"np"(np.array) или"pt"(torch.Tensor). - return_dict (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли возвращать ImagePipelineOutput вместо обычного кортежа.
Возвращает
KandinskyPriorPipelineOutput или tuple
Функция, вызываемая при обращении к конвейеру для генерации.
Примеры:
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
interpolate
< source >( images_and_prompts: listweights: listnum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Nonenegative_prior_prompt: str | None = Nonenegative_prompt: str = ''guidance_scale: float = 4.0device = None ) → KandinskyPriorPipelineOutput or tuple
Параметры
- images_and_prompts (
list[str | PIL.Image.Image | torch.Tensor]) — список промптов и изображений для управления генерацией изображения. - weights — (
list[float]): список весов для каждого условия вimages_and_prompts - num_images_per_prompt (
int, необязательный, по умолчанию 1) — Количество изображений, генерируемых для каждого промпта. - num_inference_steps (
int, необязательный, по умолчанию 25) — Количество шагов денойзинга. Как правило, большее число шагов денойзинга приводит к изображению более высокого качества, но за счёт более медленного вывода. - generator (
torch.Generatorилиlist[torch.Generator], необязательный) — Один или список генераторов torch для обеспечения детерминированности генерации. - latents (
torch.Tensor, необязательный) — Предварительно сгенерированные зашумлённые латенты, выбранные из гауссова распределения, которые используются в качестве входных данных для генерации изображений. Позволяет корректировать один и тот же процесс генерации с помощью различных промптов. Если не заданы, тензор латентов будет сгенерирован путём выборки с использованием переданного случайногоgenerator. - negative_prior_prompt (
str, необязательный) — Промпт, не направляющий процесс предварительного диффузионного синтеза. Игнорируется, если направляющее управление не используется (то есть игнорируется, еслиguidance_scaleменьше1). - negative_prompt (
strилиlist[str], необязательный) — Промпт, который не следует использовать для управления генерацией изображения. Игнорируется, если управление не используется (то есть игнорируется, еслиguidance_scaleменьше1). - guidance_scale (
float, необязательный, по умолчанию 4.0) — Масштаб руководства, как определено в Classifier-Free Diffusion Guidance.guidance_scaleопределяется какwиз уравнения 2 статьи Imagen Paper. Масштаб руководства включается при установкеguidance_scale > 1. Более высокий масштаб руководства способствует генерации изображений, тесно связанных с текстомprompt, обычно за счёт снижения качества изображения.
Возвращает
KandinskyPriorPipelineOutput или tuple
Функция, вызываемая при использовании предыдущего конвейера для интерполяции.
Примеры:
>>> from diffusers import KandinskyPriorPipeline, KandinskyPipeline
>>> from diffusers.utils import load_image
>>> import PIL

>>> import torch
>>> from torchvision import transforms

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> img1 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/cat.png"
... )

>>> img2 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/starry_night.jpeg"
... )

>>> images_texts = ["a cat", img1, img2]
>>> weights = [0.3, 0.3, 0.4]
>>> image_emb, zero_image_emb = pipe_prior.interpolate(images_texts, weights)

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16)
>>> pipe.to("cuda")

>>> image = pipe(
...     "",
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=150,
... ).images[0]

>>> image.save("starry_cat.png")
KandinskyPipeline
класс diffusers.KandinskyPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModel )
Параметры
- text_encoder (
MultilingualCLIP) — Замороженный текстовый энкодер. - tokenizer (
XLMRobertaTokenizer) — токенизатор класса - scheduler (
DDIMScheduler|DDPMScheduler) — планировщик, используемый в связке сunetдля генерации латентов изображения. - unet (UNet2DConditionModel) — Условная архитектура U-Net для удаления шума из эмбеддинга изображения.
- movq (VQModel) — декодер MoVQ для генерации изображения из латентов.
Пайплайн для генерации изображений по тексту с использованием Kandinsky
Эта модель наследуется от DiffusionPipeline. См. документацию родительского класса для общих методов, которые библиотека реализует для всех пайплайнов (например, загрузка или сохранение, запуск на конкретном устройстве и т. д.)
__call__
< source >( prompt: str | list[str]image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Параметры
- prompt (
strилиlist[str]) — Промпт или промпты для управления генерацией изображения. - image_embeds (
torch.Tensororlist[torch.Tensor]) — Векторы изображений CLIP для текстового промпта, которые будут использоваться для управления генерацией изображения. - negative_image_embeds (
torch.Tensorилиlist[torch.Tensor]) — Векторы изображений CLIP для отрицательного текстового промпта, которые будут использоваться для управления генерацией изображения. - negative_prompt (
strилиlist[str], необязательный) — Промпт или промпты, которые не должны направлять генерацию изображения. Игнорируется, если не используется направляющее влияние (то есть игнорируется, еслиguidance_scaleменьше1). - height (
int, необязательный, по умолчанию 512) — Высота генерируемого изображения в пикселях. - width (
int, необязательный, по умолчанию 512) — Ширина генерируемого изображения в пикселях. - num_inference_steps (
int, необязательный, по умолчанию 100) — Количество шагов денойзинга. Как правило, большее число шагов денойзинга приводит к изображению более высокого качества, но за счет более медленного вывода. - guidance_scale (
float, необязательный, по умолчанию 4.0) — Масштаб руководства, как определено в Classifier-Free Diffusion Guidance.guidance_scaleопределяется какwиз уравнения 2 статьи Imagen Paper. Масштаб руководства включается при установкеguidance_scale > 1. Более высокий масштаб руководства способствует генерации изображений, тесно связанных с текстомprompt, обычно за счёт снижения качества изображения. - num_images_per_prompt (
int, необязательный, по умолчанию 1) — Количество изображений, генерируемых для каждого промпта. - generator (
torch.Generatorилиlist[torch.Generator], необязательный) — Один или список генераторов torch для обеспечения детерминированности генерации. - latents (
torch.Tensor, необязательный) — Предварительно сгенерированные зашумлённые латенты, выбранные из гауссова распределения, которые используются в качестве входных данных для генерации изображений. Позволяет корректировать один и тот же процесс генерации с помощью различных промптов. Если не заданы, тензор латентов будет сгенерирован путём выборки с использованием переданного случайногоgenerator. - output_type (
str, необязательный, по умолчанию"pil") — Формат вывода сгенерированного изображения. Выберите один из вариантов:"pil"(PIL.Image.Image),"np"(np.array) или"pt"(torch.Tensor). - callback (
Callable, необязательный) — Функция, вызываемая каждыеcallback_stepsшагов во время инференса. Функция вызывается со следующими аргументами:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, необязательный, по умолчанию 1) — Частота вызова функцииcallback. Если не указано, callback вызывается на каждом шаге. - return_dict (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли возвращать ImagePipelineOutput вместо обычного кортежа.
Возвращает
ImagePipelineOutput или tuple
Функция, вызываемая при обращении к конвейеру для генерации.
Примеры:
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/Kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
KandinskyCombinedPipeline
класс diffusers.KandinskyCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Параметры
- text_encoder (
MultilingualCLIP) — Замороженный текстовый энкодер. - tokenizer (
XLMRobertaTokenizer) — токенизатор класса - scheduler (
DDIMScheduler|DDPMScheduler) — планировщик, используемый в связке сunetдля генерации латентов изображения. - unet (UNet2DConditionModel) — Условная архитектура U-Net для удаления шума из эмбеддинга изображения.
- movq (VQModel) — декодер MoVQ для генерации изображения из латентов.
- prior_prior (PriorTransformer) — Канонический unCLIP prior для приближения встраивания изображения по встраиванию текста.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Замороженный энкодер изображений. - prior_text_encoder (
CLIPTextModelWithProjection) — Замороженный текстовый энкодер. - prior_tokenizer (
CLIPTokenizer) — токенизатор класса CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — планировщик, используемый в сочетании сpriorдля генерации эмбеддинга изображения.
Совместный конвейер для генерации изображений по тексту с использованием Kandinsky
Эта модель наследуется от DiffusionPipeline. См. документацию родительского класса для общих методов, которые библиотека реализует для всех пайплайнов (например, загрузка или сохранение, запуск на конкретном устройстве и т. д.)
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Параметры
- prompt (
strилиlist[str]) — Промпт или промпты для управления генерацией изображения. - negative_prompt (
strилиlist[str], необязательный) — Промпт или промпты, которые не должны направлять генерацию изображения. Игнорируется, если не используется направляющее влияние (то есть игнорируется, еслиguidance_scaleменьше1). - num_images_per_prompt (
int, необязательный, по умолчанию 1) — Количество изображений, генерируемых для каждого промпта. - num_inference_steps (
int, необязательный, по умолчанию 100) — Количество шагов денойзинга. Как правило, большее число шагов денойзинга приводит к изображению более высокого качества, но за счет более медленного вывода. - height (
int, необязательный, по умолчанию 512) — Высота генерируемого изображения в пикселях. - width (
int, необязательный, по умолчанию 512) — Ширина генерируемого изображения в пикселях. - prior_guidance_scale (
float, необязательный, по умолчанию 4.0) — Масштаб направленного генерирования, как определено в Classifier-Free Diffusion Guidance.guidance_scaleопределяется какwиз уравнения 2 статьи Imagen Paper. Масштаб направленного генерирования включается при установкеguidance_scale > 1. Более высокое значение масштаба направленного генерирования способствует созданию изображений, тесно связанных с текстомprompt, обычно за счёт снижения качества изображения. - prior_num_inference_steps (
int, необязательный, по умолчанию 100) — Количество шагов денойзинга. Как правило, большее число шагов денойзинга приводит к изображению более высокого качества, но за счет более медленного вывода. - guidance_scale (
float, необязательный, по умолчанию 4.0) — Масштаб руководства, как определено в Classifier-Free Diffusion Guidance.guidance_scaleопределяется какwиз уравнения 2 статьи Imagen Paper. Масштаб руководства включается при установкеguidance_scale > 1. Более высокий масштаб руководства способствует генерации изображений, тесно связанных с текстомprompt, обычно за счёт снижения качества изображения. - generator (
torch.Generatorилиlist[torch.Generator], необязательный) — Один или список генераторов torch для обеспечения детерминированности генерации. - latents (
torch.Tensor, необязательный) — Предварительно сгенерированные зашумлённые латенты, выбранные из гауссова распределения, которые используются в качестве входных данных для генерации изображений. Позволяет корректировать один и тот же процесс генерации с помощью различных промптов. Если не заданы, тензор латентов будет сгенерирован путём выборки с использованием переданного случайногоgenerator. - output_type (
str, необязательный, по умолчанию"pil") — Формат вывода сгенерированного изображения. Выберите один из вариантов:"pil"(PIL.Image.Image),"np"(np.array) или"pt"(torch.Tensor). - callback (
Callable, необязательный) — Функция, вызываемая каждыеcallback_stepsшагов во время инференса. Функция вызывается со следующими аргументами:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, необязательный, по умолчанию 1) — Частота вызова функцииcallback. Если не указано, callback вызывается на каждом шаге. - return_dict (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли возвращать ImagePipelineOutput вместо обычного кортежа.
Возвращает
ImagePipelineOutput или tuple
Функция, вызываемая при обращении к конвейеру для генерации.
Примеры:
from diffusers import AutoPipelineForText2Image
import torch

pipe = AutoPipelineForText2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A lion in galaxies, spirals, nebulae, stars, smoke, iridescent, intricate detail, octane render, 8k"

image = pipe(prompt=prompt, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Разгружает все модели (state dicts unet, text_encoder, vae и safety checker) на CPU с помощью 🤗
Accelerate, что значительно снижает потребление памяти. Модели перемещаются на torch.device('meta') и загружаются на
GPU только при вызове метода forward конкретного подмодуля. Разгрузка выполняется на уровне подмодулей.
Экономия памяти выше, чем при использовании enable_model_cpu_offload, но производительность ниже.
KandinskyImg2ImgPipeline
класс diffusers.KandinskyImg2ImgPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
Параметры
- text_encoder (
MultilingualCLIP) — Замороженный текстовый энкодер. - tokenizer (
XLMRobertaTokenizer) — токенизатор класса - scheduler (DDIMScheduler) —
планировщик, используемый в связке с
unetдля генерации латентов изображения. - unet (UNet2DConditionModel) — Условная архитектура U-Net для удаления шума из эмбеддинга изображения.
- movq (VQModel) — кодировщик и декодировщик изображений MoVQ
Пайплайн для генерации изображений из изображений с использованием Kandinsky
Эта модель наследуется от DiffusionPipeline. См. документацию родительского класса для общих методов, которые библиотека реализует для всех пайплайнов (например, загрузка или сохранение, запуск на конкретном устройстве и т. д.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100strength: float = 0.3guidance_scale: float = 7.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Параметры
- prompt (
strилиlist[str]) — Промпт или промпты для управления генерацией изображения. - image (
torch.Tensor,PIL.Image.Image) —Imageили тензор, представляющий пакет изображений, который будет использоваться как отправная точка для процесса. - image_embeds (
torch.Tensororlist[torch.Tensor]) — Векторы изображений CLIP для текстового промпта, которые будут использоваться для управления генерацией изображения. - negative_image_embeds (
torch.Tensorилиlist[torch.Tensor]) — Векторы изображений CLIP для отрицательного текстового промпта, которые будут использоваться для управления генерацией изображения. - negative_prompt (
strилиlist[str], необязательный) — Промпт или промпты, которые не должны направлять генерацию изображения. Игнорируется, если не используется направляющее влияние (то есть игнорируется, еслиguidance_scaleменьше1). - height (
int, необязательный, по умолчанию 512) — Высота генерируемого изображения в пикселях. - width (
int, необязательный, по умолчанию 512) — Ширина генерируемого изображения в пикселях. - num_inference_steps (
int, необязательный, по умолчанию 100) — Количество шагов денойзинга. Как правило, большее число шагов денойзинга приводит к изображению более высокого качества, но за счет более медленного вывода. - strength (
float, необязательный, по умолчанию 0.3) — Концептуально указывает, насколько сильно трансформировать исходноеimage. Значение должно находиться в диапазоне от 0 до 1.imageиспользуется как отправная точка, при этом чем большеstrength, тем больше шума добавляется к изображению. Количество шагов денойзинга зависит от количества шума, добавленного изначально. Еслиstrengthравно 1, добавленный шум будет максимальным, и процесс денойзинга будет выполняться в течение полного числа итераций, указанного вnum_inference_steps. Таким образом, значение 1 фактически игнорируетimage. - guidance_scale (
float, необязательный, по умолчанию 4.0) — Масштаб руководства, как определено в Classifier-Free Diffusion Guidance.guidance_scaleопределяется какwиз уравнения 2 статьи Imagen Paper. Масштаб руководства включается при установкеguidance_scale > 1. Более высокий масштаб руководства способствует генерации изображений, тесно связанных с текстомprompt, обычно за счёт снижения качества изображения. - num_images_per_prompt (
int, необязательный, по умолчанию 1) — Количество изображений, генерируемых для каждого промпта. - generator (
torch.Generatorилиlist[torch.Generator], необязательный) — Один или список генераторов torch для обеспечения детерминированности генерации. - output_type (
str, необязательный, по умолчанию"pil") — Формат вывода сгенерированного изображения. Выберите один из вариантов:"pil"(PIL.Image.Image),"np"(np.array) или"pt"(torch.Tensor). - callback (
Callable, необязательный) — Функция, вызываемая каждыеcallback_stepsшагов во время инференса. Функция вызывается со следующими аргументами:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, необязательный, по умолчанию 1) — Частота вызова функцииcallback. Если не указано, callback вызывается на каждом шаге. - return_dict (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли возвращать ImagePipelineOutput вместо обычного кортежа.
Возвращает
ImagePipelineOutput или tuple
Функция, вызываемая при обращении к конвейеру для генерации.
Примеры:
>>> from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "A red cartoon frog, 4k"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyImg2ImgPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/frog.png"
... )

>>> image = pipe(
...     prompt,
...     image=init_image,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
...     strength=0.2,
... ).images

>>> image[0].save("red_frog.png")
KandinskyImg2ImgCombinedPipeline
класс diffusers.KandinskyImg2ImgCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Параметры
- text_encoder (
MultilingualCLIP) — Замороженный текстовый энкодер. - tokenizer (
XLMRobertaTokenizer) — токенизатор класса - scheduler (
DDIMScheduler|DDPMScheduler) — планировщик, используемый в связке сunetдля генерации латентов изображения. - unet (UNet2DConditionModel) — Условная архитектура U-Net для удаления шума из эмбеддинга изображения.
- movq (VQModel) — декодер MoVQ для генерации изображения из латентов.
- prior_prior (PriorTransformer) — Канонический unCLIP prior для приближения встраивания изображения по встраиванию текста.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Замороженный энкодер изображений. - prior_text_encoder (
CLIPTextModelWithProjection) — Замороженный текстовый энкодер. - prior_tokenizer (
CLIPTokenizer) — токенизатор класса CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — планировщик, используемый в сочетании сpriorдля генерации эмбеддинга изображения.
Совместный конвейер для генерации изображений из изображений с использованием Kandinsky
Эта модель наследуется от DiffusionPipeline. См. документацию родительского класса для общих методов, которые библиотека реализует для всех пайплайнов (например, загрузка или сохранение, запуск на конкретном устройстве и т. д.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1strength: float = 0.3height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Параметры
- prompt (
strилиlist[str]) — Промпт или промпты для управления генерацией изображения. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]илиlist[np.ndarray]) —Imageили тензор, представляющий пакет изображений, который будет использоваться как отправная точка для процесса. Также можно передавать латенты изображений в качествеimage; если латенты передаются напрямую, они не будут кодироваться повторно. - negative_prompt (
strилиlist[str], необязательный) — Промпт или промпты, которые не должны направлять генерацию изображения. Игнорируется, если не используется направляющее влияние (то есть игнорируется, еслиguidance_scaleменьше1). - num_images_per_prompt (
int, необязательный, по умолчанию 1) — Количество изображений, генерируемых для каждого промпта. - num_inference_steps (
int, необязательный, по умолчанию 100) — Количество шагов денойзинга. Как правило, большее число шагов денойзинга приводит к изображению более высокого качества, но за счет более медленного вывода. - height (
int, необязательный, по умолчанию 512) — Высота генерируемого изображения в пикселях. - width (
int, необязательный, по умолчанию 512) — Ширина генерируемого изображения в пикселях. - strength (
float, необязательный, по умолчанию 0.3) — Концептуально указывает, насколько сильно трансформировать исходноеimage. Значение должно находиться в диапазоне от 0 до 1.imageиспользуется как отправная точка, при этом чем большеstrength, тем больше шума добавляется к изображению. Количество шагов денойзинга зависит от количества шума, добавленного изначально. Еслиstrengthравно 1, добавленный шум будет максимальным, и процесс денойзинга будет выполняться в течение полного числа итераций, указанного вnum_inference_steps. Таким образом, значение 1 фактически игнорируетimage. - prior_guidance_scale (
float, необязательный, по умолчанию 4.0) — Масштаб направленного генерирования, как определено в Classifier-Free Diffusion Guidance.guidance_scaleопределяется какwиз уравнения 2 статьи Imagen Paper. Масштаб направленного генерирования включается при установкеguidance_scale > 1. Более высокое значение масштаба направленного генерирования способствует созданию изображений, тесно связанных с текстомprompt, обычно за счёт снижения качества изображения. - prior_num_inference_steps (
int, необязательный, по умолчанию 100) — Количество шагов денойзинга. Как правило, большее число шагов денойзинга приводит к изображению более высокого качества, но за счет более медленного вывода. - guidance_scale (
float, необязательный, по умолчанию 4.0) — Масштаб руководства, как определено в Classifier-Free Diffusion Guidance.guidance_scaleопределяется какwиз уравнения 2 статьи Imagen Paper. Масштаб руководства включается при установкеguidance_scale > 1. Более высокий масштаб руководства способствует генерации изображений, тесно связанных с текстомprompt, обычно за счёт снижения качества изображения. - generator (
torch.Generatorилиlist[torch.Generator], необязательный) — Один или список генераторов torch для обеспечения детерминированности генерации. - latents (
torch.Tensor, необязательный) — Предварительно сгенерированные зашумлённые латенты, выбранные из гауссова распределения, которые используются в качестве входных данных для генерации изображений. Позволяет корректировать один и тот же процесс генерации с помощью различных промптов. Если не заданы, тензор латентов будет сгенерирован путём выборки с использованием переданного случайногоgenerator. - output_type (
str, необязательный, по умолчанию"pil") — Формат вывода сгенерированного изображения. Выберите один из вариантов:"pil"(PIL.Image.Image),"np"(np.array) или"pt"(torch.Tensor). - callback (
Callable, необязательный) — Функция, вызываемая каждыеcallback_stepsшагов во время инференса. Функция вызывается со следующими аргументами:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, необязательный, по умолчанию 1) — Частота вызова функцииcallback. Если не указано, callback вызывается на каждом шаге. - return_dict (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли возвращать ImagePipelineOutput вместо обычного кортежа.
Возвращает
ImagePipelineOutput или tuple
Функция, вызываемая при обращении к конвейеру для генерации.
Примеры:
from diffusers import AutoPipelineForImage2Image
import torch
import requests
from io import BytesIO
from PIL import Image
import os

pipe = AutoPipelineForImage2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"

response = requests.get(url)
image = Image.open(BytesIO(response.content)).convert("RGB")
image.thumbnail((768, 768))

image = pipe(prompt=prompt, image=original_image, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Offloads all models to CPU using accelerate, significantly reducing memory usage. When called, unet,
text_encoder, vae and safety checker have their state dicts saved to CPU and then are moved to a torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, but performance is lower.
KandinskyInpaintPipeline
класс diffusers.KandinskyInpaintPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
Параметры
- text_encoder (
MultilingualCLIP) — Замороженный текстовый энкодер. - tokenizer (
XLMRobertaTokenizer) — токенизатор класса - scheduler (DDIMScheduler) —
планировщик, используемый в связке с
unetдля генерации латентов изображения. - unet (UNet2DConditionModel) — Условная архитектура U-Net для удаления шума из эмбеддинга изображения.
- movq (VQModel) — кодировщик и декодировщик изображений MoVQ
Пайплайн для текстового управления восстановлением изображений с использованием Kandinsky2.1
Эта модель наследуется от DiffusionPipeline. См. документацию родительского класса для общих методов, которые библиотека реализует для всех пайплайнов (например, загрузка или сохранение, запуск на конкретном устройстве и т. д.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, PIL.Image.Image]mask_image: typing.Union[PIL.Image.Image, torch.Tensor, numpy.ndarray]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Параметры
- prompt (
strилиlist[str]) — Промпт или промпты для управления генерацией изображения. - image (
torch.Tensor,PIL.Image.Imageornp.ndarray) —Imageили тензор, представляющий пакет изображений, который будет использоваться как отправная точка для процесса. - mask_image (
PIL.Image.Image,torch.Tensorornp.ndarray) —Imageили тензор, представляющий пакет изображений, для маскированияimage. Белые пиксели в маске будут перекрашены, а чёрные — сохранены. Передавать тензор pytorch в качестве маски можно только в том случае, если переданное вами изображение является тензором pytorch, и он должен содержать один цветовой канал (L) вместо трёх, поэтому ожидаемая форма будет либо(B, 1, H, W,),(B, H, W),(1, H, W)или(H, W)Если изображение — это PIL image или массив numpy, маска также должна быть либо PIL image, либо массивом numpy. Если это PIL image, он будет преобразован в один канал (яркость) перед использованием. Если это массив nummpy, ожидаемая форма —(H, W). - image_embeds (
torch.Tensororlist[torch.Tensor]) — Векторы изображений CLIP для текстового промпта, которые будут использоваться для управления генерацией изображения. - negative_image_embeds (
torch.Tensorилиlist[torch.Tensor]) — Векторы изображений CLIP для отрицательного текстового промпта, которые будут использоваться для управления генерацией изображения. - negative_prompt (
strилиlist[str], необязательный) — Промпт или промпты, которые не должны направлять генерацию изображения. Игнорируется, если не используется направляющее влияние (то есть игнорируется, еслиguidance_scaleменьше1). - height (
int, необязательный, по умолчанию 512) — Высота генерируемого изображения в пикселях. - width (
int, необязательный, по умолчанию 512) — Ширина генерируемого изображения в пикселях. - num_inference_steps (
int, необязательный, по умолчанию 100) — Количество шагов денойзинга. Как правило, большее число шагов денойзинга приводит к изображению более высокого качества, но за счет более медленного вывода. - guidance_scale (
float, необязательный, по умолчанию 4.0) — Масштаб руководства, как определено в Classifier-Free Diffusion Guidance.guidance_scaleопределяется какwиз уравнения 2 статьи Imagen Paper. Масштаб руководства включается при установкеguidance_scale > 1. Более высокий масштаб руководства способствует генерации изображений, тесно связанных с текстомprompt, обычно за счёт снижения качества изображения. - num_images_per_prompt (
int, необязательный, по умолчанию 1) — Количество изображений, генерируемых для каждого промпта. - generator (
torch.Generatorилиlist[torch.Generator], необязательный) — Один или список генераторов torch для обеспечения детерминированности генерации. - latents (
torch.Tensor, необязательный) — Предварительно сгенерированные зашумлённые латенты, выбранные из гауссова распределения, которые используются в качестве входных данных для генерации изображений. Позволяет корректировать один и тот же процесс генерации с помощью различных промптов. Если не заданы, тензор латентов будет сгенерирован путём выборки с использованием переданного случайногоgenerator. - output_type (
str, необязательный, по умолчанию"pil") — Формат вывода сгенерированного изображения. Выберите один из вариантов:"pil"(PIL.Image.Image),"np"(np.array) или"pt"(torch.Tensor). - callback (
Callable, необязательный) — Функция, вызываемая каждыеcallback_stepsшагов во время инференса. Функция вызывается со следующими аргументами:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, необязательный, по умолчанию 1) — Частота вызова функцииcallback. Если не указано, callback вызывается на каждом шаге. - return_dict (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли возвращать ImagePipelineOutput вместо обычного кортежа.
Возвращает
ImagePipelineOutput или tuple
Функция, вызываемая при обращении к конвейеру для генерации.
Примеры:
>>> from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch
>>> import numpy as np

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "a hat"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyInpaintPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/cat.png"
... )

>>> mask = np.zeros((768, 768), dtype=np.float32)
>>> mask[:250, 250:-250] = 1

>>> out = pipe(
...     prompt,
...     image=init_image,
...     mask_image=mask,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=50,
... )

>>> image = out.images[0]
>>> image.save("cat_with_hat.png")
KandinskyInpaintCombinedPipeline
класс diffusers.KandinskyInpaintCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Параметры
- text_encoder (
MultilingualCLIP) — Замороженный текстовый энкодер. - tokenizer (
XLMRobertaTokenizer) — токенизатор класса - scheduler (
DDIMScheduler|DDPMScheduler) — планировщик, используемый в связке сunetдля генерации латентов изображения. - unet (UNet2DConditionModel) — Условная архитектура U-Net для удаления шума из эмбеддинга изображения.
- movq (VQModel) — декодер MoVQ для генерации изображения из латентов.
- prior_prior (PriorTransformer) — Канонический unCLIP prior для приближения встраивания изображения по встраиванию текста.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Замороженный энкодер изображений. - prior_text_encoder (
CLIPTextModelWithProjection) — Замороженный текстовый энкодер. - prior_tokenizer (
CLIPTokenizer) — токенизатор класса CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — планировщик, используемый в сочетании сpriorдля генерации эмбеддинга изображения.
Совместный конвейер для генерации с использованием Kandinsky
Эта модель наследуется от DiffusionPipeline. См. документацию родительского класса для общих методов, которые библиотека реализует для всех пайплайнов (например, загрузка или сохранение, запуск на конкретном устройстве и т. д.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]mask_image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Параметры
- prompt (
strилиlist[str]) — Промпт или промпты для управления генерацией изображения. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]илиlist[np.ndarray]) —Imageили тензор, представляющий пакет изображений, который будет использоваться как отправная точка для процесса. Также можно передавать латенты изображений в качествеimage; если латенты передаются напрямую, они не будут кодироваться повторно. - mask_image (
np.array) — Тензор, представляющий пакет изображений, для маскированияimage. Белые пиксели в маске будут перекрашены, тогда как чёрные пиксели сохранятся. Еслиmask_image— это изображение PIL, оно будет преобразовано в один канал (яркость) перед использованием. Если это тензор, он должен содержать один цветовой канал (L) вместо трёх, поэтому ожидаемая форма —(B, H, W, 1). - negative_prompt (
strилиlist[str], необязательный) — Промпт или промпты, которые не должны направлять генерацию изображения. Игнорируется, если не используется направляющее влияние (то есть игнорируется, еслиguidance_scaleменьше1). - num_images_per_prompt (
int, необязательный, по умолчанию 1) — Количество изображений, генерируемых для каждого промпта. - num_inference_steps (
int, необязательный, по умолчанию 100) — Количество шагов денойзинга. Как правило, большее число шагов денойзинга приводит к изображению более высокого качества, но за счет более медленного вывода. - height (
int, необязательный, по умолчанию 512) — Высота генерируемого изображения в пикселях. - width (
int, необязательный, по умолчанию 512) — Ширина генерируемого изображения в пикселях. - prior_guidance_scale (
float, необязательный, по умолчанию 4.0) — Масштаб направленного генерирования, как определено в Classifier-Free Diffusion Guidance.guidance_scaleопределяется какwиз уравнения 2 статьи Imagen Paper. Масштаб направленного генерирования включается при установкеguidance_scale > 1. Более высокое значение масштаба направленного генерирования способствует созданию изображений, тесно связанных с текстомprompt, обычно за счёт снижения качества изображения. - prior_num_inference_steps (
int, необязательный, по умолчанию 100) — Количество шагов денойзинга. Как правило, большее число шагов денойзинга приводит к изображению более высокого качества, но за счет более медленного вывода. - guidance_scale (
float, необязательный, по умолчанию 4.0) — Масштаб руководства, как определено в Classifier-Free Diffusion Guidance.guidance_scaleопределяется какwиз уравнения 2 статьи Imagen Paper. Масштаб руководства включается при установкеguidance_scale > 1. Более высокий масштаб руководства способствует генерации изображений, тесно связанных с текстомprompt, обычно за счёт снижения качества изображения. - generator (
torch.Generatorилиlist[torch.Generator], необязательный) — Один или список генераторов torch для обеспечения детерминированности генерации. - latents (
torch.Tensor, необязательный) — Предварительно сгенерированные зашумлённые латенты, выбранные из гауссова распределения, которые используются в качестве входных данных для генерации изображений. Позволяет корректировать один и тот же процесс генерации с помощью различных промптов. Если не заданы, тензор латентов будет сгенерирован путём выборки с использованием переданного случайногоgenerator. - output_type (
str, необязательный, по умолчанию"pil") — Формат вывода сгенерированного изображения. Выберите один из вариантов:"pil"(PIL.Image.Image),"np"(np.array) или"pt"(torch.Tensor). - callback (
Callable, необязательный) — Функция, вызываемая каждыеcallback_stepsшагов во время инференса. Функция вызывается со следующими аргументами:callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, необязательный, по умолчанию 1) — Частота вызова функцииcallback. Если не указано, callback вызывается на каждом шаге. - return_dict (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли возвращать ImagePipelineOutput вместо обычного кортежа.
Возвращает
ImagePipelineOutput или tuple
Функция, вызываемая при обращении к конвейеру для генерации.
Примеры:
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image
import torch
import numpy as np

pipe = AutoPipelineForInpainting.from_pretrained(
    "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

original_image = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main" "/kandinsky/cat.png"
)

mask = np.zeros((768, 768), dtype=np.float32)
# Let's mask out an area above the cat's head
mask[:250, 250:-250] = 1

image = pipe(prompt=prompt, image=original_image, mask_image=mask, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Offloads all models to CPU using accelerate, significantly reducing memory usage. When called, unet,
text_encoder, vae and safety checker have their state dicts saved to CPU and then are moved to a torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, but performance is lower.