
Diffusers documentation
Comprendre les pipelines, les modèles et les planificateurs
Comprendre les pipelines, les modèles et les planificateurs
🧨 Diffusers est conçu pour être une boîte à outils conviviale et flexible permettant de construire des systèmes de diffusion adaptés à votre cas d'usage. Au cœur de la boîte à outils se trouvent les modèles et les planificateurs. Bien que le DiffusionPipeline regroupe ces composants pour plus de commodité, vous pouvez également décomposer le pipeline et utiliser les modèles et les planificateurs séparément pour créer de nouveaux systèmes de diffusion.
Dans ce tutoriel, vous apprendrez à utiliser des modèles et des planificateurs pour assembler un système de diffusion pour l'inférence, en commençant par un pipeline de base avant de passer au pipeline Stable Diffusion.
Décomposer un pipeline de base
Un pipeline est un moyen rapide et simple d’exécuter un modèle pour l’inférence, nécessitant au plus quatre lignes de code pour générer une image :
>>> from diffusers import DDPMPipeline

>>> ddpm = DDPMPipeline.from_pretrained("google/ddpm-cat-256", use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
>>> image = ddpm(num_inference_steps=25).images[0]
>>> image
C’était très simple, mais comment le pipeline a-t-il fait cela ? Décomposons le pipeline et examinons ce qui se passe sous le capot.
Dans l’exemple ci-dessus, le pipeline contient un modèle UNet2DModel et un DDPMScheduler. Le pipeline débruite une image en prenant du bruit aléatoire de la taille de la sortie souhaitée et en le faisant passer plusieurs fois à travers le modèle. À chaque pas de temps, le modèle prédit le bruit résiduel et le planificateur l’utilise pour prédire une image moins bruitée. Le pipeline répète ce processus jusqu’à atteindre la fin du nombre de pas d’inférence spécifié.
Pour recréer le pipeline avec le modèle et le planificateur séparément, écrivons notre propre processus de débruitage.
- Charger le modèle et le planificateur :
>>> from diffusers import DDPMScheduler, UNet2DModel

>>> scheduler = DDPMScheduler.from_pretrained("google/ddpm-cat-256")
>>> model = UNet2DModel.from_pretrained("google/ddpm-cat-256", use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"- Définissez le nombre de pas de temps pour exécuter le processus de débruitage :
>>> scheduler.set_timesteps(50)- Définir les pas de temps du planificateur crée un tenseur dont les éléments sont répartis uniformément, 50 dans cet exemple. Chaque élément correspond à un pas de temps auquel le modèle débruite une image. Lorsque vous créerez la boucle de débruitage plus tard, vous itérerez sur ce tenseur pour débruitage une image :
>>> scheduler.timesteps
tensor([980, 960, 940, 920, 900, 880, 860, 840, 820, 800, 780, 760, 740, 720,
    700, 680, 660, 640, 620, 600, 580, 560, 540, 520, 500, 480, 460, 440,
    420, 400, 380, 360, 340, 320, 300, 280, 260, 240, 220, 200, 180, 160,
140, 120, 100, 80, 60, 40, 20, 0])- Créez du bruit aléatoire avec la même forme que la sortie souhaitée :
>>> import torch

>>> sample_size = model.config.sample_size
>>> noise = torch.randn((1, 3, sample_size, sample_size), device="cuda") # or "mps", "xpu", "cpu"- Écrivez maintenant une boucle pour itérer sur les timesteps. À chaque timestep, le modèle effectue un passage UNet2DModel.forward() et renvoie le résidu bruité. La méthode step() du planificateur prend en entrée le résidu bruité, le timestep et l’entrée, et prédit l’image au timestep précédent. Cette sortie devient l’entrée suivante du modèle dans la boucle de débruitage, et le processus se répète jusqu’à atteindre la fin du tableau
timesteps.
>>> input = noise

>>> for t in scheduler.timesteps:
...     with torch.no_grad():
...         noisy_residual = model(input, t).sample
...     previous_noisy_sample = scheduler.step(noisy_residual, t, input).prev_sample
...     input = previous_noisy_sample
Voici l’ensemble du processus de débruitage, et vous pouvez utiliser ce même schéma pour écrire n’importe quel système de diffusion.
- La dernière étape consiste à convertir la sortie débruitée en image :
>>> from PIL import Image
>>> import numpy as np

>>> image = (input / 2 + 0.5).clamp(0, 1).squeeze()
>>> image = (image.permute(1, 2, 0) * 255).round().to(torch.uint8).cpu().numpy()
>>> image = Image.fromarray(image)
>>> image
Dans la section suivante, vous mettrez vos compétences à l’épreuve et vous décomposerez le pipeline Stable Diffusion plus complexe. Les étapes sont plus ou moins les mêmes. Vous initialiserez les composants nécessaires et définirez le nombre de timesteps pour créer un tableau timestep. Le tableau timestep est utilisé dans la boucle de débruitage, et pour chaque élément de ce tableau, le modèle prédit une image moins bruitée. La boucle de débruitage itère sur les timestep, et à chaque timestep, elle produit un résidu bruité que le scheduler utilise pour prédire une image moins bruitée au timestep précédent. Ce processus est répété jusqu’à atteindre la fin du tableau timestep.
Essayons !
Décomposer le pipeline Stable Diffusion
Stable Diffusion est un modèle de diffusion latente texte-vers-image. Il est appelé modèle de diffusion latente car il fonctionne avec une représentation de dimension inférieure de l'image plutôt qu'avec l'espace des pixels réel, ce qui le rend plus efficace en mémoire. L'encodeur compresse l'image en une représentation plus petite, et un décodeur convertit la représentation compressée à nouveau en image. Pour les modèles texte-vers-image, vous aurez besoin d'un tokenizer et d'un encodeur pour générer des embeddings de texte. À partir de l'exemple précédent, vous savez déjà que vous avez besoin d'un modèle UNet et d'un scheduler.
Comme vous pouvez le constater, c'est déjà plus complexe que le pipeline DDPM qui ne contient qu'un modèle UNet. Le modèle Stable Diffusion comporte trois modèles pré-entraînés distincts.
💡 Lisez le blog Comment fonctionne Stable Diffusion ? pour plus de détails sur le fonctionnement des modèles VAE, UNet et encodeur de texte.
Maintenant que vous savez de quoi vous avez besoin pour le pipeline Stable Diffusion, chargez tous ces composants avec la méthode from_pretrained(). Vous pouvez les trouver dans le checkpoint pré-entraîné stable-diffusion-v1-5/stable-diffusion-v1-5, et chaque composant est stocké dans un sous-dossier distinct :
>>> from PIL import Image
>>> import torch
>>> from transformers import CLIPTextModel, CLIPTokenizer
>>> from diffusers import AutoencoderKL, UNet2DConditionModel, PNDMScheduler

>>> vae = AutoencoderKL.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="vae", use_safetensors=True)
>>> tokenizer = CLIPTokenizer.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="tokenizer")
>>> text_encoder = CLIPTextModel.from_pretrained(
...     "CompVis/stable-diffusion-v1-4", subfolder="text_encoder", use_safetensors=True
... )
>>> unet = UNet2DConditionModel.from_pretrained(
...     "CompVis/stable-diffusion-v1-4", subfolder="unet", use_safetensors=True
... )
À la place du PNDMScheduler par défaut, remplacez-le par le UniPCMultistepScheduler pour voir à quel point il est facile d’insérer un autre planificateur :
>>> from diffusers import UniPCMultistepScheduler

>>> scheduler = UniPCMultistepScheduler.from_pretrained("CompVis/stable-diffusion-v1-4", subfolder="scheduler")
Pour accélérer l'inférence, déplacez les modèles sur un GPU, car, contrairement au planificateur, ils possèdent des poids entraînables :
>>> torch_device = "cuda"  # or "mps", "xpu", "cpu"
>>> vae.to(torch_device)
>>> text_encoder.to(torch_device)
>>> unet.to(torch_device)
Créer des embeddings de texte
L'étape suivante consiste à tokeniser le texte afin de générer des embeddings. Le texte est utilisé pour conditionner le modèle UNet et orienter le processus de diffusion vers un résultat ressemblant au prompt d'entrée.
💡 Le paramètre
guidance_scaledétermine le poids accordé au prompt lors de la génération d'une image.
N'hésitez pas à choisir n'importe quel prompt si vous souhaitez générer autre chose !
>>> prompt = ["a photograph of an astronaut riding a horse"]
>>> height = 512  # default height of Stable Diffusion
>>> width = 512  # default width of Stable Diffusion
>>> num_inference_steps = 25  # Number of denoising steps
>>> guidance_scale = 7.5  # Scale for classifier-free guidance
>>> generator = torch.manual_seed(0)  # Seed generator to create the initial latent noise
>>> batch_size = len(prompt)
Tokeniser le texte et générer les embeddings à partir du prompt :
>>> text_input = tokenizer(
...     prompt, padding="max_length", max_length=tokenizer.model_max_length, truncation=True, return_tensors="pt"
... )

>>> with torch.no_grad():
...     text_embeddings = text_encoder(text_input.input_ids.to(torch_device))[0]
Vous devrez également générer les embeddings de texte non conditionnels, qui sont les embeddings du jeton de bourrage. Ils doivent avoir la même forme (batch_size et seq_length) que les text_embeddings conditionnels :
>>> max_length = text_input.input_ids.shape[-1]
>>> uncond_input = tokenizer([""] * batch_size, padding="max_length", max_length=max_length, return_tensors="pt")
>>> uncond_embeddings = text_encoder(uncond_input.input_ids.to(torch_device))[0]
Concatenons les embeddings conditionnels et non conditionnels dans un lot afin d’éviter de réaliser deux passes avant :
>>> text_embeddings = torch.cat([uncond_embeddings, text_embeddings])Créer du bruit aléatoire
Ensuite, générez un bruit aléatoire initial comme point de départ pour le processus de diffusion. Il s’agit de la représentation latente de l’image, qui sera progressivement débruitée. À ce stade, l’image latent est plus petite que la taille finale de l’image, mais ce n’est pas un problème, car le modèle la transformera en dimensions finales de 512x512 plus tard.
💡 La hauteur et la largeur sont divisées par 8 car le modèle
vaecomporte 3 couches de sous-échantillonnage. Vous pouvez le vérifier en exécutant ce qui suit :2 ** (len(vae.config.block_out_channels) - 1) == 8
>>> latents = torch.randn(
...     (batch_size, unet.config.in_channels, height // 8, width // 8),
...     generator=generator,
...     device=torch_device,
... )
Dénuisancer l'image
Commencez par mettre à l'échelle l'entrée avec la distribution de bruit initiale, sigma, la valeur d'échelle du bruit, qui est requise pour les planificateurs améliorés tels que UniPCMultistepScheduler :
>>> latents = latents * scheduler.init_noise_sigmaLa dernière étape consiste à créer la boucle de débruitage qui transformera progressivement le bruit pur dans latents en une image décrite par votre invite. Rappelez-vous, la boucle de débruitage doit faire trois choses :
- Définissez les timesteps du scheduler à utiliser lors du débruitage.
- Itérer sur les timesteps.
- À chaque pas de temps, appelez le modèle UNet pour prédire le résidu de bruit et transmettez-le au planificateur afin de calculer l'échantillon bruité précédent.
>>> from tqdm.auto import tqdm

>>> scheduler.set_timesteps(num_inference_steps)

>>> for t in tqdm(scheduler.timesteps):
...     # expand the latents if we are doing classifier-free guidance to avoid doing two forward passes.
...     latent_model_input = torch.cat([latents] * 2)

...     latent_model_input = scheduler.scale_model_input(latent_model_input, timestep=t)

...     # predict the noise residual
...     with torch.no_grad():
...         noise_pred = unet(latent_model_input, t, encoder_hidden_states=text_embeddings).sample

...     # perform guidance
...     noise_pred_uncond, noise_pred_text = noise_pred.chunk(2)
...     noise_pred = noise_pred_uncond + guidance_scale * (noise_pred_text - noise_pred_uncond)

...     # compute the previous noisy sample x_t -> x_t-1
...     latents = scheduler.step(noise_pred, t, latents).prev_sample
Décoder l'image
La dernière étape consiste à utiliser le vae pour décoder la représentation latente en image et obtenir la sortie décodée avec sample :
# scale and decode the image latents with vae
latents = 1 / 0.18215 * latents
with torch.no_grad():
    image = vae.decode(latents).sample
Enfin, convertissez l'image en PIL.Image pour voir l'image générée !
>>> image = (image / 2 + 0.5).clamp(0, 1).squeeze()
>>> image = (image.permute(1, 2, 0) * 255).to(torch.uint8).cpu().numpy()
>>> image = Image.fromarray(image)
>>> image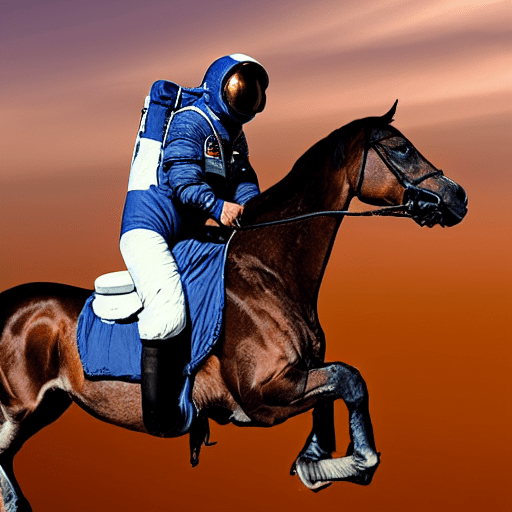
Étapes suivantes
Des pipelines les plus simples aux plus complexes, vous avez constaté que l’essentiel pour écrire votre propre système de diffusion est une boucle de débruitage. Cette boucle doit définir les timesteps du scheduler, itérer sur ceux-ci, et alterner entre l’appel du modèle UNet pour prédire le résidu de bruit et le passage de ce dernier au scheduler afin de calculer l’échantillon bruité précédent.
C'est précisément à quoi 🧨 Diffusers est conçu : rendre intuitif et simple l'écriture de votre propre système de diffusion à l'aide de modèles et de planificateurs.
Pour vos prochaines étapes, n'hésitez pas à :
- Apprenez à construire et contribuer à un pipeline pour 🧨 Diffusers. Nous avons hâte de voir ce que vous allez inventer !
- Explorez les pipelines existants de la bibliothèque et voyez si vous pouvez les déconstruire et construire un pipeline à partir de zéro en utilisant les modèles et les planificateurs séparément.