
Diffusers documentation
Kandinsky 2.1
Kandinsky 2.1
Kandinsky 2.1 a été créé par Arseniy Shakhmatov, Anton Razzhigaev, Aleksandr Nikolich, Vladimir Arkhipkin, Igor Pavlov, Andrey Kuznetsov et Denis Dimitrov.
La description de sa page GitHub est :
Kandinsky 2.1 reprend les meilleures pratiques de Dall-E 2 et de la diffusion latente, tout en introduisant de nouvelles idées. Il utilise le modèle CLIP comme encodeur de texte et d’image, ainsi qu’un a priori de diffusion d’image (mapping) entre les espaces latents des modalités CLIP. Cette approche améliore les performances visuelles du modèle et ouvre de nouvelles perspectives en matière de fusion d’images et de manipulation d’images guidée par le texte.
Le code source original peut être trouvé sur ai-forever/Kandinsky-2.
Consultez l'organisation Kandinsky Community sur le Hub pour les points de contrôle officiels des modèles destinés à des tâches telles que la génération d'images à partir de texte, la transformation d'image en image et l'inpainting.
Pensez à consulter le guide des Schedulers pour apprendre à explorer le compromis entre la vitesse et la qualité du scheduler, et à consulter la section réutilisation des composants entre les pipelines pour apprendre à charger efficacement les mêmes composants dans plusieurs pipelines.
Assurez-vous d'avoir installé les bibliothèques suivantes.
# uncomment to install the necessary libraries in Colab
#!pip install -q diffusers transformers accelerate
L'utilisation de Kandinsky 2.1 et 2.2 est très similaire ! La seule différence est que Kandinsky 2.2 n'accepte pas
promptcomme entrée lors du décodage des latents. En revanche, Kandinsky 2.2 n'accepte queimage_embedslors du décodage.
Kandinsky 3 possède une architecture plus concise et ne nécessite pas de modèle préalable. Son utilisation est donc identique à celle d’autres modèles de diffusion comme Stable Diffusion XL.
Texte vers image
Pour utiliser les modèles Kandinsky pour toute tâche, vous commencez toujours par configurer le pipeline prior afin d’encoder le prompt et de générer les embeddings d’image. Le pipeline prior génère également des negative_image_embeds qui correspondent au prompt négatif "". Pour de meilleurs résultats, vous pouvez passer un negative_prompt réel au pipeline prior, mais cela augmentera la taille effective du lot du pipeline prior par un facteur de 2.
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt, guidance_scale=1.0).to_tuple()
Passez maintenant tous les prompts et les embeddings au KandinskyPipeline pour générer une image :
image = pipeline(prompt, image_embeds=image_embeds, negative_prompt=negative_prompt, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
import torch

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16).to("cuda")

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality" # optional to include a negative prompt, but results are usually better
image_embeds, negative_image_embeds = prior_pipeline(prompt, guidance_scale=1.0).to_tuple()
Passez image_embeds et negative_image_embeds au KandinskyV22Pipeline pour générer une image :
image = pipeline(image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768).images[0]
image
Kandinsky 3 ne nécessite pas de modèle préalable, vous pouvez donc charger directement le Kandinsky3Pipeline et passer un prompt pour générer une image :
from diffusers import Kandinsky3Pipeline
import torch

pipeline = Kandinsky3Pipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
image = pipeline(prompt).images[0]
image
🤗 Diffusers fournit également une API de bout en bout avec KandinskyCombinedPipeline et KandinskyV22CombinedPipeline, ce qui signifie qu’il n’est pas nécessaire de charger séparément le pipeline prior et le pipeline texte-vers-image. Le pipeline combiné charge automatiquement à la fois le modèle prior et le décodeur. Vous pouvez toujours définir des valeurs différentes pour le pipeline prior à l’aide des paramètres prior_guidance_scale et prior_num_inference_steps si vous le souhaitez.
Utilisez AutoPipelineForText2Image pour appeler automatiquement les pipelines combinés en arrière-plan :
from diffusers import AutoPipelineForText2Image
import torch

pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
pipeline.enable_model_cpu_offload()

prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
imagefrom diffusers import AutoPipelineForText2Image
import torch
pipeline = AutoPipelineForText2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A alien cheeseburger creature eating itself, claymation, cinematic, moody lighting"
negative_prompt = "low quality, bad quality"
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, prior_guidance_scale=1.0, guidance_scale=4.0, height=768, width=768).images[0]
imageImage vers image
Pour l'image-à-image, passez l'image initiale et le prompt de texte pour conditionner l'image au pipeline. Commencez par charger le pipeline prior :
import torch
from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyImg2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")import torch
from diffusers import KandinskyV22Img2ImgPipeline, KandinskyPriorPipeline
prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")Kandinsky 3 n’exige pas de modèle préalable, vous pouvez donc charger directement le pipeline image-versus-image :
from diffusers import Kandinsky3Img2ImgPipeline
from diffusers.utils import load_image
import torch

pipeline = Kandinsky3Img2ImgPipeline.from_pretrained("kandinsky-community/kandinsky-3", variant="fp16", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
Télécharger une image à utiliser comme condition :
from diffusers.utils import load_image

# download image
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image = original_image.resize((768, 512))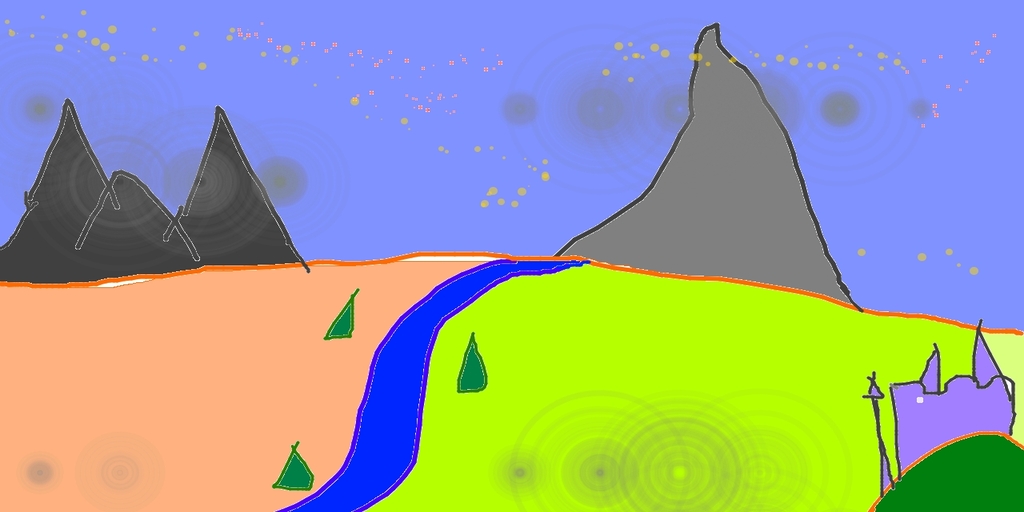
Générer les image_embeds et les negative_image_embeds avec le pipeline précédent :
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

image_embeds, negative_image_embeds = prior_pipeline(prompt, negative_prompt).to_tuple()
Passez maintenant l'image d'origine, ainsi que tous les prompts et embeddings, au pipeline pour générer une image :
from diffusers.utils import make_image_grid

image = pipeline(prompt, negative_prompt=negative_prompt, image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
from diffusers.utils import make_image_grid

image = pipeline(image=original_image, image_embeds=image_embeds, negative_image_embeds=negative_image_embeds, height=768, width=768, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
image = pipeline(prompt, negative_prompt=negative_prompt, image=image, strength=0.75, num_inference_steps=25).images[0]
image
🤗 Diffusers fournit également une API de bout en bout avec KandinskyImg2ImgCombinedPipeline et KandinskyV22Img2ImgCombinedPipeline, ce qui signifie qu’il n’est pas nécessaire de charger séparément le pipeline prior et le pipeline image-à-image. Le pipeline combiné charge automatiquement à la fois le modèle prior et le décodeur. Vous pouvez toujours définir des valeurs différentes pour le pipeline prior à l’aide des paramètres prior_guidance_scale et prior_num_inference_steps si vous le souhaitez.
Utilisez AutoPipelineForImage2Image pour appeler automatiquement les pipelines combinés en arrière-plan :
from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch

pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True)
pipeline.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)

original_image.thumbnail((768, 768))

image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)from diffusers import AutoPipelineForImage2Image
from diffusers.utils import make_image_grid, load_image
import torch
pipeline = AutoPipelineForImage2Image.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16)
pipeline.enable_model_cpu_offload()
prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"
url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"
original_image = load_image(url)
original_image.thumbnail((768, 768))
image = pipeline(prompt=prompt, negative_prompt=negative_prompt, image=original_image, strength=0.3).images[0]
make_image_grid([original_image.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)Inpainting
⚠️ Les modèles Kandinsky utilisent désormais des pixels blancs ⬜️ pour représenter la zone masquée, au lieu de pixels noirs. Si vous utilisez KandinskyInpaintPipeline en production, vous devez modifier le masque pour utiliser des pixels blancs :
# For PIL input
import PIL.ImageOps
mask = PIL.ImageOps.invert(mask)

# For PyTorch and NumPy input
mask = 1 - mask
Pour l'inpainting, vous aurez besoin de l'image d'origine, d'un masque de la zone à remplacer dans l'image d'origine et d'un prompt texte décrivant ce qu'il faut inpainter. Chargez le pipeline précédent :
from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
pipeline = KandinskyInpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")from diffusers import KandinskyV22InpaintPipeline, KandinskyV22PriorPipeline
from diffusers.utils import load_image, make_image_grid
import torch
import numpy as np
from PIL import Image
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
pipeline = KandinskyV22InpaintPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16, use_safetensors=True).to("cuda")Charger une image initiale et créer un masque :
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
Générer les embeddings avec le pipeline précédent :
prompt = "a hat"
prior_output = prior_pipeline(prompt)
Passez maintenant l'image initiale, le masque, le prompt et les embeddings au pipeline pour générer une image :
output_image = pipeline(prompt, image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
output_image = pipeline(image=init_image, mask_image=mask, **prior_output, height=768, width=768, num_inference_steps=150).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)
Vous pouvez également utiliser les pipelines de bout en bout KandinskyInpaintCombinedPipeline et KandinskyV22InpaintCombinedPipeline pour appeler les pipelines prior et decoder ensemble en interne. Utilisez AutoPipelineForInpainting pour cela :
import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid

pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-1-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()

init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"

output_image = pipe(prompt=prompt, image=init_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)import torch
import numpy as np
from PIL import Image
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image, make_image_grid
pipe = AutoPipelineForInpainting.from_pretrained("kandinsky-community/kandinsky-2-2-decoder-inpaint", dtype=torch.float16)
pipe.enable_model_cpu_offload()
init_image = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
mask = np.zeros((768, 768), dtype=np.float32)
# mask area above cat's head
mask[:250, 250:-250] = 1
prompt = "a hat"
output_image = pipe(prompt=prompt, image=original_image, mask_image=mask).images[0]
mask = Image.fromarray((mask*255).astype('uint8'), 'L')
make_image_grid([init_image, mask, output_image], rows=1, cols=3)Interpolation
L’interpolation vous permet d’explorer l’espace latent entre les embeddings d’image et de texte, ce qui est une excellente façon de visualiser certaines des sorties intermédiaires du modèle prior. Chargez le pipeline prior et les deux images que vous souhaitez interpoler :
from diffusers import KandinskyPriorPipeline, KandinskyPipeline
from diffusers.utils import load_image, make_image_grid
import torch

prior_pipeline = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)from diffusers import KandinskyV22PriorPipeline, KandinskyV22Pipeline
from diffusers.utils import load_image, make_image_grid
import torch
prior_pipeline = KandinskyV22PriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True).to("cuda") # or "mps", "xpu", "cpu"
img_1 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/cat.png")
img_2 = load_image("https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinsky/starry_night.jpeg")
make_image_grid([img_1.resize((512,512)), img_2.resize((512,512))], rows=1, cols=2)

Spécifiez les textes ou images à interpoler et définissez les poids pour chaque texte ou image. Expérimentez avec les poids pour voir comment ils affectent l'interpolation !
images_texts = ["a cat", img_1, img_2]
weights = [0.3, 0.3, 0.4]
Appel de la fonction interpolate pour générer les embeddings, puis de leur passage au pipeline pour générer l'image :
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
# prompt can be left empty
prompt = ""
prior_out = prior_pipeline.interpolate(images_texts, weights)

pipeline = KandinskyV22Pipeline.from_pretrained("kandinsky-community/kandinsky-2-2-decoder", dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"

image = pipeline(prompt, **prior_out, height=768, width=768).images[0]
image
ControlNet
⚠️ ControlNet n'est pris en charge que pour Kandinsky 2.2 !
ControlNet permet de conditionner de grands modèles de diffusion pré-entraînés avec des entrées supplémentaires telles qu'une carte de profondeur ou une détection de contours. Par exemple, vous pouvez conditionner Kandinsky 2.2 avec une carte de profondeur afin que le modèle comprenne et conserve la structure de l'image de profondeur.
Chargons une image et extrayons sa carte de profondeur :
from diffusers.utils import load_image

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))
img
Vous pouvez ensuite utiliser le Pipeline depth-estimation de 🤗 Transformers pour traiter l'image et récupérer la carte de profondeur :
import torch
import numpy as np

from transformers import pipeline

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
Texte vers image
Chargez le pipeline précédent et le KandinskyV22ControlnetPipeline :
from diffusers import KandinskyV22PriorPipeline, KandinskyV22ControlnetPipeline

prior_pipeline = KandinskyV22PriorPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
Générer les embeddings d’image à partir d’un prompt et d’un prompt négatif :
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

image_emb, zero_image_emb = prior_pipeline(
    prompt=prompt, negative_prompt=negative_prior_prompt, generator=generator
).to_tuple()
Enfin, passez les embeddings d'image et l'image de profondeur à KandinskyV22ControlnetPipeline pour générer une image :
image = pipeline(image_embeds=image_emb, negative_image_embeds=zero_image_emb, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
image
Image vers image
Pour l'image-à-image avec ControlNet, vous devrez utiliser :
- KandinskyV22PriorEmb2EmbPipeline pour générer les embeddings d’image à partir d’un prompt texte et d’une image
- KandinskyV22ControlnetImg2ImgPipeline pour générer une image à partir de l’image initiale et des embeddings d’image
Traitez et extrayez une carte de profondeur d'une image initiale d'un chat à l'aide du Pipeline depth-estimation de 🤗 Transformers :
import torch
import numpy as np

from diffusers import KandinskyV22PriorEmb2EmbPipeline, KandinskyV22ControlnetImg2ImgPipeline
from diffusers.utils import load_image
from transformers import pipeline

img = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main/kandinskyv22/cat.png"
).resize((768, 768))

def make_hint(image, depth_estimator):
    image = depth_estimator(image)["depth"]
    image = np.array(image)
    image = image[:, :, None]
    image = np.concatenate([image, image, image], axis=2)
    detected_map = torch.from_numpy(image).float() / 255.0
    hint = detected_map.permute(2, 0, 1)
    return hint

depth_estimator = pipeline("depth-estimation")
hint = make_hint(img, depth_estimator).unsqueeze(0).half().to("cuda")  # or "mps", "xpu", "cpu"
Chargez le pipeline précédent et le KandinskyV22ControlnetImg2ImgPipeline :
prior_pipeline = KandinskyV22PriorEmb2EmbPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-prior", dtype=torch.float16, use_safetensors=True
).to("cuda")  # or "mps", "xpu", "cpu"

pipeline = KandinskyV22ControlnetImg2ImgPipeline.from_pretrained(
    "kandinsky-community/kandinsky-2-2-controlnet-depth", dtype=torch.float16
).to("cuda")
Transmettez un prompt de texte et l'image initiale au pipeline prior pour générer les embeddings d'image :
prompt = "A robot, 4k photo"
negative_prior_prompt = "lowres, text, error, cropped, worst quality, low quality, jpeg artifacts, ugly, duplicate, morbid, mutilated, out of frame, extra fingers, mutated hands, poorly drawn hands, poorly drawn face, mutation, deformed, blurry, dehydrated, bad anatomy, bad proportions, extra limbs, cloned face, disfigured, gross proportions, malformed limbs, missing arms, missing legs, extra arms, extra legs, fused fingers, too many fingers, long neck, username, watermark, signature"

generator = torch.Generator(device="cuda").manual_seed(43)  # or "mps", "xpu", "cpu"

img_emb = prior_pipeline(prompt=prompt, image=img, strength=0.85, generator=generator)
negative_emb = prior_pipeline(prompt=negative_prior_prompt, image=img, strength=1, generator=generator)
Vous pouvez maintenant exécuter le KandinskyV22ControlnetImg2ImgPipeline pour générer une image à partir de l'image initiale et des embeddings d'image :
image = pipeline(image=img, strength=0.5, image_embeds=img_emb.image_embeds, negative_image_embeds=negative_emb.image_embeds, hint=hint, num_inference_steps=50, generator=generator, height=768, width=768).images[0]
make_image_grid([img.resize((512, 512)), image.resize((512, 512))], rows=1, cols=2)
Optimisations
Kandinsky est unique car il nécessite un pipeline préalable pour générer les correspondances, puis un second pipeline pour décoder les latents en image. Les efforts d'optimisation doivent se concentrer sur le second pipeline, car c'est là que se fait l'essentiel du calcul. Voici quelques conseils pour améliorer Kandinsky lors de l'inférence.
- Activez xFormers si vous utilisez PyTorch < 2.0 :
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_xformers_memory_efficient_attention()- Activez
torch.compilesi vous utilisez PyTorch >= 2.0 afin d’utiliser automatiquement l’attention à point produit mis à l’échelle (SDPA) :
  pipe.unet.to(memory_format=torch.channels_last)
+ pipe.unet = torch.compile(pipe.unet, mode="reduce-overhead", fullgraph=True)
Cela revient à définir explicitement le processeur d’attention à utiliser comme étant AttnAddedKVProcessor2_0 :
from diffusers.models.attention_processor import AttnAddedKVProcessor2_0

pipe.unet.set_attn_processor(AttnAddedKVProcessor2_0())- Déchargez le modèle sur le CPU avec enable_model_cpu_offload() pour éviter les erreurs de mémoire insuffisante :
  from diffusers import DiffusionPipeline
  import torch

  pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", dtype=torch.float16)
+ pipe.enable_model_cpu_offload()- Par défaut, le pipeline texte-vers-image utilise le DDIMScheduler, mais vous pouvez le remplacer par un autre planificateur comme DDPMScheduler pour voir comment cela affecte le compromis entre la vitesse d'inférence et la qualité de l'image :
from diffusers import DDPMScheduler
from diffusers import DiffusionPipeline

scheduler = DDPMScheduler.from_pretrained("kandinsky-community/kandinsky-2-1", subfolder="ddpm_scheduler")
pipe = DiffusionPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", scheduler=scheduler, dtype=torch.float16, use_safetensors=True).to("cuda")  # or "mps", "xpu", "cpu"
KandinskyPriorPipeline
classe diffusers.KandinskyPriorPipeline
< source >( prior: PriorTransformerimage_encoder: CLIPVisionModelWithProjectiontext_encoder: CLIPTextModelWithProjectiontokenizer: CLIPTokenizerscheduler: UnCLIPSchedulerimage_processor: CLIPImageProcessorPil )
Paramètres
- prior (PriorTransformer) — Le prior unCLIP canonique pour approximer l’embedding d’image à partir de l’embedding de texte.
- image_encoder (
CLIPVisionModelWithProjection) — Encodeur d’images figé. - text_encoder (
CLIPTextModelWithProjection) — Encodeur de texte figé. - tokenizer (
CLIPTokenizer) — Tokeniseur de la classe CLIPTokenizer. - scheduler (
UnCLIPScheduler) — Un planificateur à utiliser en combinaison avecpriorpour générer l’embedding d’image.
Pipeline pour générer un a priori d'image pour Kandinsky
Ce modèle hérite de DiffusionPipeline. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous les pipelines (tels que le téléchargement ou l'enregistrement, l'exécution sur un appareil particulier, etc.)
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneguidance_scale: float = 4.0output_type: str | None = 'pt'return_dict: bool = True ) → KandinskyPriorPipelineOutput or tuple
Paramètres
- prompt (
stroulist[str]) — Le prompt ou les prompts pour guider la génération d’image. - negative_prompt (
stroulist[str], facultatif) — Le ou les prompts à ne pas utiliser pour guider la génération d’image. Ignoré lorsque la guidance n’est pas utilisée (c’est-à-dire ignoré siguidance_scaleest inférieur à1). - num_images_per_prompt (
int, facultatif, valeur par défaut 1) — Le nombre d'images à générer par invite. - num_inference_steps (
int, facultatif, valeur par défaut 25) — Le nombre d'étapes de débruitage. Un plus grand nombre d'étapes de débruitage conduit généralement à une image de meilleure qualité, au prix d'une inférence plus lente. - generator (
torch.Generatoroulist[torch.Generator], facultatif) — Un ou une liste de générateurs torch pour rendre la génération déterministe. - latents (
torch.Tensor, facultatif) — Latents bruités pré-générés, échantillonnés à partir d’une distribution gaussienne, à utiliser comme entrées pour la génération d’images. Peut être utilisé pour ajuster la même génération avec des prompts différents. S’il n’est pas fourni, un tenseur de latents sera généré par échantillonnage à l’aide dugeneratoraléatoire fourni. - guidance_scale (
float, facultatif, valeur par défaut 4.0) — Échelle de guidage telle que définie dans Classifier-Free Diffusion Guidance.guidance_scaleest défini commewde l’équation 2 de Imagen Paper. L’échelle de guidage est activée en définissantguidance_scale > 1. Une échelle de guidage plus élevée encourage la génération d’images étroitement liées auprompttexte, généralement au détriment de la qualité de l’image. - output_type (
str, facultatif, par défaut"pt") — Le format de sortie de l'image générée. Choisissez entre :"np"(np.array) ou"pt"(torch.Tensor). - return_dict (
bool, facultatif, par défautTrue) — Indique s'il faut retourner un ImagePipelineOutput plutôt qu'un simple tuple.
Retourne
KandinskyPriorPipelineOutput ou tuple
Fonction appelée lors de l'appel du pipeline pour la génération.
Exemples :
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
interpolate
< source >( images_and_prompts: listweights: listnum_images_per_prompt: int = 1num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Nonenegative_prior_prompt: str | None = Nonenegative_prompt: str = ''guidance_scale: float = 4.0device = None ) → KandinskyPriorPipelineOutput or tuple
Paramètres
- images_and_prompts (
list[str | PIL.Image.Image | torch.Tensor]) — liste de prompts et d'images pour guider la génération d'images. - weights — (
list[float]) : liste des poids pour chaque condition dansimages_and_prompts - num_images_per_prompt (
int, facultatif, valeur par défaut 1) — Le nombre d'images à générer par invite. - num_inference_steps (
int, facultatif, valeur par défaut 25) — Le nombre d'étapes de débruitage. Un plus grand nombre d'étapes de débruitage conduit généralement à une image de meilleure qualité, au prix d'une inférence plus lente. - generator (
torch.Generatoroulist[torch.Generator], facultatif) — Un ou une liste de générateurs torch pour rendre la génération déterministe. - latents (
torch.Tensor, facultatif) — Latents bruités pré-générés, échantillonnés à partir d’une distribution gaussienne, à utiliser comme entrées pour la génération d’images. Peut être utilisé pour ajuster la même génération avec des prompts différents. S’il n’est pas fourni, un tenseur de latents sera généré par échantillonnage à l’aide dugeneratoraléatoire fourni. - negative_prior_prompt (
str, facultatif) — Le prompt à ne pas utiliser pour guider le processus de diffusion a priori. Ignoré lorsque la guidance n’est pas utilisée (c’est-à-dire ignoré siguidance_scaleest inférieur à1). - negative_prompt (
stroulist[str], facultatif) — Le prompt à ne pas utiliser pour guider la génération de l’image. Ignoré lorsque la guidance n’est pas utilisée (c’est-à-dire ignoré siguidance_scaleest inférieur à1). - guidance_scale (
float, facultatif, valeur par défaut 4.0) — Échelle de guidage telle que définie dans Classifier-Free Diffusion Guidance.guidance_scaleest défini commewde l’équation 2 de Imagen Paper. L’échelle de guidage est activée en définissantguidance_scale > 1. Une échelle de guidage plus élevée encourage la génération d’images étroitement liées auprompttexte, généralement au détriment de la qualité de l’image.
Retourne
KandinskyPriorPipelineOutput ou tuple
Fonction appelée lors de l'utilisation du pipeline antérieur pour l'interpolation.
Exemples :
>>> from diffusers import KandinskyPriorPipeline, KandinskyPipeline
>>> from diffusers.utils import load_image
>>> import PIL

>>> import torch
>>> from torchvision import transforms

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> img1 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/cat.png"
... )

>>> img2 = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/starry_night.jpeg"
... )

>>> images_texts = ["a cat", img1, img2]
>>> weights = [0.3, 0.3, 0.4]
>>> image_emb, zero_image_emb = pipe_prior.interpolate(images_texts, weights)

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16)
>>> pipe.to("cuda")

>>> image = pipe(
...     "",
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=150,
... ).images[0]

>>> image.save("starry_cat.png")
KandinskyPipeline
classe diffusers.KandinskyPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModel )
Paramètres
- text_encoder (
MultilingualCLIP) — Encodeur de texte figé. - tokenizer (
XLMRobertaTokenizer) — Tokenizer de classe - scheduler (
DDIMScheduler|DDPMScheduler) — Un planificateur à utiliser en combinaison avecunetpour générer des latents d’image. - unet (UNet2DConditionModel) — Architecture U-Net conditionnelle pour le débruitage de l’embedding d’image.
- movq (VQModel) — Décodeur MoVQ pour générer l'image à partir des latents.
Pipeline pour la génération d'images à partir de texte utilisant Kandinsky
Ce modèle hérite de DiffusionPipeline. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous les pipelines (tels que le téléchargement ou l'enregistrement, l'exécution sur un appareil particulier, etc.)
__call__
< source >( prompt: str | list[str]image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_image_embeds: typing.Union[torch.Tensor, list[torch.Tensor]]negative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Paramètres
- prompt (
stroulist[str]) — Le prompt ou les prompts pour guider la génération d’image. - image_embeds (
torch.Tensoroulist[torch.Tensor]) — Les embeddings d’image CLIP pour le prompt texte, qui seront utilisés pour conditionner la génération d’image. - negative_image_embeds (
torch.Tensoroulist[torch.Tensor]) — Les embeddings d’image CLIP pour le prompt de texte négatif, utilisés pour conditionner la génération d’image. - negative_prompt (
stroulist[str], facultatif) — Le ou les prompts à ne pas utiliser pour guider la génération d’image. Ignoré lorsque la guidance n’est pas utilisée (c’est-à-dire ignoré siguidance_scaleest inférieur à1). - height (
int, facultatif, par défaut 512) — La hauteur en pixels de l'image générée. - width (
int, facultatif, par défaut 512) — La largeur en pixels de l'image générée. - num_inference_steps (
int, facultatif, valeur par défaut 100) — Le nombre d'étapes de débruitage. Un plus grand nombre d'étapes de débruitage conduit généralement à une image de meilleure qualité, au prix d'une inférence plus lente. - guidance_scale (
float, facultatif, valeur par défaut 4.0) — Échelle de guidage telle que définie dans Classifier-Free Diffusion Guidance.guidance_scaleest défini commewde l’équation 2 de Imagen Paper. L’échelle de guidage est activée en définissantguidance_scale > 1. Une échelle de guidage plus élevée encourage la génération d’images étroitement liées auprompttexte, généralement au détriment de la qualité de l’image. - num_images_per_prompt (
int, facultatif, valeur par défaut 1) — Le nombre d'images à générer par invite. - generator (
torch.Generatoroulist[torch.Generator], facultatif) — Un ou une liste de générateurs torch pour rendre la génération déterministe. - latents (
torch.Tensor, facultatif) — Latents bruités pré-générés, échantillonnés à partir d’une distribution gaussienne, à utiliser comme entrées pour la génération d’images. Peut être utilisé pour ajuster la même génération avec des prompts différents. S’il n’est pas fourni, un tenseur de latents sera généré par échantillonnage à l’aide dugeneratoraléatoire fourni. - output_type (
str, facultatif, par défaut"pil") — Le format de sortie de l'image générée. Choisissez entre :"pil"(PIL.Image.Image),"np"(np.array) ou"pt"(torch.Tensor). - callback (
Callable, facultatif) — Une fonction appelée toutes lescallback_stepsétapes pendant l'inférence. La fonction est appelée avec les arguments suivants :callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, facultatif, valeur par défaut 1) — La fréquence à laquelle la fonctioncallbackest appelée. Si non spécifié, le callback est appelé à chaque étape. - return_dict (
bool, facultatif, par défautTrue) — Indique s'il faut retourner un ImagePipelineOutput plutôt qu'un simple tuple.
Retourne
ImagePipelineOutput ou tuple
Fonction appelée lors de l'appel du pipeline pour la génération.
Exemples :
>>> from diffusers import KandinskyPipeline, KandinskyPriorPipeline
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained("kandinsky-community/Kandinsky-2-1-prior")
>>> pipe_prior.to("cuda")

>>> prompt = "red cat, 4k photo"
>>> out = pipe_prior(prompt)
>>> image_emb = out.image_embeds
>>> negative_image_emb = out.negative_image_embeds

>>> pipe = KandinskyPipeline.from_pretrained("kandinsky-community/kandinsky-2-1")
>>> pipe.to("cuda")

>>> image = pipe(
...     prompt,
...     image_embeds=image_emb,
...     negative_image_embeds=negative_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
... ).images

>>> image[0].save("cat.png")
KandinskyCombinedPipeline
classe diffusers.KandinskyCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Paramètres
- text_encoder (
MultilingualCLIP) — Encodeur de texte figé. - tokenizer (
XLMRobertaTokenizer) — Tokenizer de classe - scheduler (
DDIMScheduler|DDPMScheduler) — Un planificateur à utiliser en combinaison avecunetpour générer des latents d’image. - unet (UNet2DConditionModel) — Architecture U-Net conditionnelle pour le débruitage de l’embedding d’image.
- movq (VQModel) — Décodeur MoVQ pour générer l'image à partir des latents.
- prior_prior (PriorTransformer) — Le prior unCLIP canonique pour approximer l’embedding d’image à partir de l’embedding de texte.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Encodeur d'images figé. - prior_text_encoder (
CLIPTextModelWithProjection) — Encodeur de texte figé. - prior_tokenizer (
CLIPTokenizer) — Tokenizer de la classe CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — Un planificateur à utiliser en combinaison avecpriorpour générer l’embedding d’image.
Pipeline combiné pour la génération d'images à partir de texte utilisant Kandinsky
Ce modèle hérite de DiffusionPipeline. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous les pipelines (tels que le téléchargement ou l'enregistrement, l'exécution sur un appareil particulier, etc.)
__call__
< source >( prompt: str | list[str]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Paramètres
- prompt (
stroulist[str]) — Le prompt ou les prompts pour guider la génération d’image. - negative_prompt (
stroulist[str], facultatif) — Le ou les prompts à ne pas utiliser pour guider la génération d’image. Ignoré lorsque la guidance n’est pas utilisée (c’est-à-dire ignoré siguidance_scaleest inférieur à1). - num_images_per_prompt (
int, facultatif, valeur par défaut 1) — Le nombre d'images à générer par invite. - num_inference_steps (
int, facultatif, valeur par défaut 100) — Le nombre d'étapes de débruitage. Un plus grand nombre d'étapes de débruitage conduit généralement à une image de meilleure qualité, au prix d'une inférence plus lente. - height (
int, facultatif, par défaut 512) — La hauteur en pixels de l'image générée. - width (
int, facultatif, par défaut 512) — La largeur en pixels de l'image générée. - prior_guidance_scale (
float, facultatif, valeur par défaut 4.0) — Échelle de guidage telle que définie dans Classifier-Free Diffusion Guidance.guidance_scaleest défini commewde l’équation 2 de Imagen Paper. L’échelle de guidage est activée en définissantguidance_scale > 1. Une échelle de guidage plus élevée encourage la génération d’images étroitement liées auprompttexte, généralement au détriment de la qualité de l’image. - prior_num_inference_steps (
int, facultatif, valeur par défaut 100) — Le nombre d'étapes de débruitage. Un plus grand nombre d'étapes de débruitage conduit généralement à une image de meilleure qualité, au prix d'une inférence plus lente. - guidance_scale (
float, facultatif, valeur par défaut 4.0) — Échelle de guidage telle que définie dans Classifier-Free Diffusion Guidance.guidance_scaleest défini commewde l’équation 2 de Imagen Paper. L’échelle de guidage est activée en définissantguidance_scale > 1. Une échelle de guidage plus élevée encourage la génération d’images étroitement liées auprompttexte, généralement au détriment de la qualité de l’image. - generator (
torch.Generatoroulist[torch.Generator], facultatif) — Un ou une liste de générateurs torch pour rendre la génération déterministe. - latents (
torch.Tensor, facultatif) — Latents bruités pré-générés, échantillonnés à partir d’une distribution gaussienne, à utiliser comme entrées pour la génération d’images. Peut être utilisé pour ajuster la même génération avec des prompts différents. S’il n’est pas fourni, un tenseur de latents sera généré par échantillonnage à l’aide dugeneratoraléatoire fourni. - output_type (
str, facultatif, par défaut"pil") — Le format de sortie de l'image générée. Choisissez entre :"pil"(PIL.Image.Image),"np"(np.array) ou"pt"(torch.Tensor). - callback (
Callable, facultatif) — Une fonction appelée toutes lescallback_stepsétapes pendant l'inférence. La fonction est appelée avec les arguments suivants :callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, facultatif, valeur par défaut 1) — La fréquence à laquelle la fonctioncallbackest appelée. Si non spécifié, le callback est appelé à chaque étape. - return_dict (
bool, facultatif, par défautTrue) — Indique s'il faut retourner un ImagePipelineOutput plutôt qu'un simple tuple.
Retourne
ImagePipelineOutput ou tuple
Fonction appelée lors de l'appel du pipeline pour la génération.
Exemples :
from diffusers import AutoPipelineForText2Image
import torch

pipe = AutoPipelineForText2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A lion in galaxies, spirals, nebulae, stars, smoke, iridescent, intricate detail, octane render, 8k"

image = pipe(prompt=prompt, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Décharge tous les modèles (les dictionnaires d’état de unet, text_encoder, vae et du safety checker) sur le CPU à l’aide de 🤗
Accelerate, réduisant ainsi considérablement l’utilisation de la mémoire. Les modèles sont déplacés vers un torch.device('meta') et chargés sur un
GPU uniquement lorsque la méthode forward de leur sous-module spécifique est appelée. La décharge s’effectue au niveau des sous-modules.
Les économies de mémoire sont supérieures à celles obtenues avec enable_model_cpu_offload, mais les performances sont inférieures.
KandinskyImg2ImgPipeline
classe diffusers.KandinskyImg2ImgPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
Paramètres
- text_encoder (
MultilingualCLIP) — Encodeur de texte figé. - tokenizer (
XLMRobertaTokenizer) — Tokenizer de classe - scheduler (DDIMScheduler) —
Un planificateur à utiliser en combinaison avec
unetpour générer des latents d’image. - unet (UNet2DConditionModel) — Architecture U-Net conditionnelle pour le débruitage de l’embedding d’image.
- movq (VQModel) — encodeur et décodeur d'images MoVQ
Pipeline pour la génération d'image à partir d'image utilisant Kandinsky
Ce modèle hérite de DiffusionPipeline. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous les pipelines (tels que le téléchargement ou l'enregistrement, l'exécution sur un appareil particulier, etc.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100strength: float = 0.3guidance_scale: float = 7.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Paramètres
- prompt (
stroulist[str]) — Le prompt ou les prompts pour guider la génération d’image. - image (
torch.Tensor,PIL.Image.Image) —Imageou tenseur représentant un lot d’images, qui servira de point de départ au processus. - image_embeds (
torch.Tensoroulist[torch.Tensor]) — Les embeddings d’image CLIP pour le prompt texte, qui seront utilisés pour conditionner la génération d’image. - negative_image_embeds (
torch.Tensoroulist[torch.Tensor]) — Les embeddings d’image CLIP pour le prompt de texte négatif, utilisés pour conditionner la génération d’image. - negative_prompt (
stroulist[str], facultatif) — Le ou les prompts à ne pas utiliser pour guider la génération d’image. Ignoré lorsque la guidance n’est pas utilisée (c’est-à-dire ignoré siguidance_scaleest inférieur à1). - height (
int, facultatif, par défaut 512) — La hauteur en pixels de l'image générée. - width (
int, facultatif, par défaut 512) — La largeur en pixels de l'image générée. - num_inference_steps (
int, facultatif, valeur par défaut 100) — Le nombre d'étapes de débruitage. Un plus grand nombre d'étapes de débruitage conduit généralement à une image de meilleure qualité, au prix d'une inférence plus lente. - strength (
float, facultatif, valeur par défaut 0,3) — Indique conceptuellement dans quelle mesure transformer l'imagede référence. Doit être compris entre 0 et 1. L'imageservira de point de départ, en y ajoutant d'autant plus de bruit que la valeur destrengthest élevée. Le nombre d'étapes de débruitage dépend de la quantité de bruit initialement ajoutée. Lorsquestrengthvaut 1, le bruit ajouté sera maximal et le processus de débruitage s'exécutera pendant le nombre complet d'itérations spécifié dansnum_inference_steps. Une valeur de 1 ignore donc essentiellement l'image. - guidance_scale (
float, facultatif, valeur par défaut 4.0) — Échelle de guidage telle que définie dans Classifier-Free Diffusion Guidance.guidance_scaleest défini commewde l’équation 2 de Imagen Paper. L’échelle de guidage est activée en définissantguidance_scale > 1. Une échelle de guidage plus élevée encourage la génération d’images étroitement liées auprompttexte, généralement au détriment de la qualité de l’image. - num_images_per_prompt (
int, facultatif, valeur par défaut 1) — Le nombre d'images à générer par invite. - generator (
torch.Generatoroulist[torch.Generator], facultatif) — Un ou une liste de générateurs torch pour rendre la génération déterministe. - output_type (
str, facultatif, par défaut"pil") — Le format de sortie de l'image générée. Choisissez entre :"pil"(PIL.Image.Image),"np"(np.array) ou"pt"(torch.Tensor). - callback (
Callable, facultatif) — Une fonction appelée toutes lescallback_stepsétapes pendant l'inférence. La fonction est appelée avec les arguments suivants :callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, facultatif, valeur par défaut 1) — La fréquence à laquelle la fonctioncallbackest appelée. Si non spécifié, le callback est appelé à chaque étape. - return_dict (
bool, facultatif, par défautTrue) — Indique s'il faut retourner un ImagePipelineOutput plutôt qu'un simple tuple.
Retourne
ImagePipelineOutput ou tuple
Fonction appelée lors de l'appel du pipeline pour la génération.
Exemples :
>>> from diffusers import KandinskyImg2ImgPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "A red cartoon frog, 4k"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyImg2ImgPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/frog.png"
... )

>>> image = pipe(
...     prompt,
...     image=init_image,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=100,
...     strength=0.2,
... ).images

>>> image[0].save("red_frog.png")
KandinskyImg2ImgCombinedPipeline
classe diffusers.KandinskyImg2ImgCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Paramètres
- text_encoder (
MultilingualCLIP) — Encodeur de texte figé. - tokenizer (
XLMRobertaTokenizer) — Tokenizer de classe - scheduler (
DDIMScheduler|DDPMScheduler) — Un planificateur à utiliser en combinaison avecunetpour générer des latents d’image. - unet (UNet2DConditionModel) — Architecture U-Net conditionnelle pour le débruitage de l’embedding d’image.
- movq (VQModel) — Décodeur MoVQ pour générer l'image à partir des latents.
- prior_prior (PriorTransformer) — Le prior unCLIP canonique pour approximer l’embedding d’image à partir de l’embedding de texte.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Encodeur d'images figé. - prior_text_encoder (
CLIPTextModelWithProjection) — Encodeur de texte figé. - prior_tokenizer (
CLIPTokenizer) — Tokenizer de la classe CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — Un planificateur à utiliser en combinaison avecpriorpour générer l’embedding d’image.
Pipeline combiné pour la génération d'image à partir d'image à l'aide de Kandinsky
Ce modèle hérite de DiffusionPipeline. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous les pipelines (tels que le téléchargement ou l'enregistrement, l'exécution sur un appareil particulier, etc.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1strength: float = 0.3height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Paramètres
- prompt (
stroulist[str]) — Le prompt ou les prompts pour guider la génération d’image. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]oulist[np.ndarray]) —Imageou tenseur représentant un lot d’images, qui servira de point de départ au processus. Peut également accepter des latents d’image en tant queimage; si des latents sont transmis directement, ils ne seront pas réencodés. - negative_prompt (
stroulist[str], facultatif) — Le ou les prompts à ne pas utiliser pour guider la génération d’image. Ignoré lorsque la guidance n’est pas utilisée (c’est-à-dire ignoré siguidance_scaleest inférieur à1). - num_images_per_prompt (
int, facultatif, valeur par défaut 1) — Le nombre d'images à générer par invite. - num_inference_steps (
int, facultatif, valeur par défaut 100) — Le nombre d'étapes de débruitage. Un plus grand nombre d'étapes de débruitage conduit généralement à une image de meilleure qualité, au prix d'une inférence plus lente. - height (
int, facultatif, par défaut 512) — La hauteur en pixels de l'image générée. - width (
int, facultatif, par défaut 512) — La largeur en pixels de l'image générée. - strength (
float, facultatif, valeur par défaut 0,3) — Indique conceptuellement dans quelle mesure transformer l'imagede référence. Doit être compris entre 0 et 1. L'imageservira de point de départ, en y ajoutant d'autant plus de bruit que la valeur destrengthest élevée. Le nombre d'étapes de débruitage dépend de la quantité de bruit initialement ajoutée. Lorsquestrengthvaut 1, le bruit ajouté sera maximal et le processus de débruitage s'exécutera pendant le nombre complet d'itérations spécifié dansnum_inference_steps. Une valeur de 1 ignore donc essentiellement l'image. - prior_guidance_scale (
float, facultatif, valeur par défaut 4.0) — Échelle de guidage telle que définie dans Classifier-Free Diffusion Guidance.guidance_scaleest défini commewde l’équation 2 de Imagen Paper. L’échelle de guidage est activée en définissantguidance_scale > 1. Une échelle de guidage plus élevée encourage la génération d’images étroitement liées auprompttexte, généralement au détriment de la qualité de l’image. - prior_num_inference_steps (
int, facultatif, valeur par défaut 100) — Le nombre d'étapes de débruitage. Un plus grand nombre d'étapes de débruitage conduit généralement à une image de meilleure qualité, au prix d'une inférence plus lente. - guidance_scale (
float, facultatif, valeur par défaut 4.0) — Échelle de guidage telle que définie dans Classifier-Free Diffusion Guidance.guidance_scaleest défini commewde l’équation 2 de Imagen Paper. L’échelle de guidage est activée en définissantguidance_scale > 1. Une échelle de guidage plus élevée encourage la génération d’images étroitement liées auprompttexte, généralement au détriment de la qualité de l’image. - generator (
torch.Generatoroulist[torch.Generator], facultatif) — Un ou une liste de générateurs torch pour rendre la génération déterministe. - latents (
torch.Tensor, facultatif) — Latents bruités pré-générés, échantillonnés à partir d’une distribution gaussienne, à utiliser comme entrées pour la génération d’images. Peut être utilisé pour ajuster la même génération avec des prompts différents. S’il n’est pas fourni, un tenseur de latents sera généré par échantillonnage à l’aide dugeneratoraléatoire fourni. - output_type (
str, facultatif, par défaut"pil") — Le format de sortie de l'image générée. Choisissez entre :"pil"(PIL.Image.Image),"np"(np.array) ou"pt"(torch.Tensor). - callback (
Callable, facultatif) — Une fonction appelée toutes lescallback_stepsétapes pendant l'inférence. La fonction est appelée avec les arguments suivants :callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, facultatif, valeur par défaut 1) — La fréquence à laquelle la fonctioncallbackest appelée. Si non spécifié, le callback est appelé à chaque étape. - return_dict (
bool, facultatif, par défautTrue) — Indique s'il faut retourner un ImagePipelineOutput plutôt qu'un simple tuple.
Retourne
ImagePipelineOutput ou tuple
Fonction appelée lors de l'appel du pipeline pour la génération.
Exemples :
from diffusers import AutoPipelineForImage2Image
import torch
import requests
from io import BytesIO
from PIL import Image
import os

pipe = AutoPipelineForImage2Image.from_pretrained(
    "kandinsky-community/kandinsky-2-1", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

url = "https://raw.githubusercontent.com/CompVis/stable-diffusion/main/assets/stable-samples/img2img/sketch-mountains-input.jpg"

response = requests.get(url)
image = Image.open(BytesIO(response.content)).convert("RGB")
image.thumbnail((768, 768))

image = pipe(prompt=prompt, image=original_image, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Décharge tous les modèles sur le CPU à l'aide de accelerate, réduisant ainsi considérablement l'utilisation de la mémoire. Lors de l'appel, les dictionnaires d'état de unet, text_encoder, vae et du vérificateur de sécurité sont enregistrés sur le CPU, puis déplacés vers un torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, mais performance is lower.
KandinskyInpaintPipeline
classe diffusers.KandinskyInpaintPipeline
< source >( text_encoder: MultilingualCLIPmovq: VQModeltokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: DDIMScheduler )
Paramètres
- text_encoder (
MultilingualCLIP) — Encodeur de texte figé. - tokenizer (
XLMRobertaTokenizer) — Tokenizer de classe - scheduler (DDIMScheduler) —
Un planificateur à utiliser en combinaison avec
unetpour générer des latents d’image. - unet (UNet2DConditionModel) — Architecture U-Net conditionnelle pour le débruitage de l’embedding d’image.
- movq (VQModel) — encodeur et décodeur d'images MoVQ
Pipeline pour l'inpainting d'images guidé par le texte à l'aide de Kandinsky2.1
Ce modèle hérite de DiffusionPipeline. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous les pipelines (tels que le téléchargement ou l'enregistrement, l'exécution sur un appareil particulier, etc.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, PIL.Image.Image]mask_image: typing.Union[PIL.Image.Image, torch.Tensor, numpy.ndarray]image_embeds: Tensornegative_image_embeds: Tensornegative_prompt: str | list[str] | None = Noneheight: int = 512width: int = 512num_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Paramètres
- prompt (
stroulist[str]) — Le prompt ou les prompts pour guider la génération d’image. - image (
torch.Tensor,PIL.Image.Imageounp.ndarray) —Image, ou tenseur représentant un lot d’images, qui servira de point de départ au processus. - mask_image (
PIL.Image.Image,torch.Tensorounp.ndarray) —Image, ou un tenseur représentant un lot d’images, à utiliser comme masque pourimage. Les pixels blancs du masque seront repeints, tandis que les pixels noirs seront conservés. Vous ne pouvez passer un tenseur pytorch en tant que masque que si l’image transmise est un tenseur pytorch, et il doit contenir un seul canal de couleur (L) au lieu de 3, de sorte que la forme attendue soit soit(B, 1, H, W,),(B, H, W),(1, H, W)ou(H, W)Si l’image est une image PIL ou un tableau numpy, le masque doit également être soit une image PIL, soit un tableau numpy. S’il s’agit d’une image PIL, elle sera convertie en un seul canal (luminance) avant utilisation. S’il s’agit d’un tableau nummpy, la forme attendue est(H, W). - image_embeds (
torch.Tensoroulist[torch.Tensor]) — Les embeddings d’image CLIP pour le prompt texte, qui seront utilisés pour conditionner la génération d’image. - negative_image_embeds (
torch.Tensoroulist[torch.Tensor]) — Les embeddings d’image CLIP pour le prompt de texte négatif, utilisés pour conditionner la génération d’image. - negative_prompt (
stroulist[str], facultatif) — Le ou les prompts à ne pas utiliser pour guider la génération d’image. Ignoré lorsque la guidance n’est pas utilisée (c’est-à-dire ignoré siguidance_scaleest inférieur à1). - height (
int, facultatif, par défaut 512) — La hauteur en pixels de l'image générée. - width (
int, facultatif, par défaut 512) — La largeur en pixels de l'image générée. - num_inference_steps (
int, facultatif, valeur par défaut 100) — Le nombre d'étapes de débruitage. Un plus grand nombre d'étapes de débruitage conduit généralement à une image de meilleure qualité, au prix d'une inférence plus lente. - guidance_scale (
float, facultatif, valeur par défaut 4.0) — Échelle de guidage telle que définie dans Classifier-Free Diffusion Guidance.guidance_scaleest défini commewde l’équation 2 de Imagen Paper. L’échelle de guidage est activée en définissantguidance_scale > 1. Une échelle de guidage plus élevée encourage la génération d’images étroitement liées auprompttexte, généralement au détriment de la qualité de l’image. - num_images_per_prompt (
int, facultatif, valeur par défaut 1) — Le nombre d'images à générer par invite. - generator (
torch.Generatoroulist[torch.Generator], facultatif) — Un ou une liste de générateurs torch pour rendre la génération déterministe. - latents (
torch.Tensor, facultatif) — Latents bruités pré-générés, échantillonnés à partir d’une distribution gaussienne, à utiliser comme entrées pour la génération d’images. Peut être utilisé pour ajuster la même génération avec des prompts différents. S’il n’est pas fourni, un tenseur de latents sera généré par échantillonnage à l’aide dugeneratoraléatoire fourni. - output_type (
str, facultatif, par défaut"pil") — Le format de sortie de l'image générée. Choisissez entre :"pil"(PIL.Image.Image),"np"(np.array) ou"pt"(torch.Tensor). - callback (
Callable, facultatif) — Une fonction appelée toutes lescallback_stepsétapes pendant l'inférence. La fonction est appelée avec les arguments suivants :callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, facultatif, valeur par défaut 1) — La fréquence à laquelle la fonctioncallbackest appelée. Si non spécifié, le callback est appelé à chaque étape. - return_dict (
bool, facultatif, par défautTrue) — Indique s'il faut retourner un ImagePipelineOutput plutôt qu'un simple tuple.
Retourne
ImagePipelineOutput ou tuple
Fonction appelée lors de l'appel du pipeline pour la génération.
Exemples :
>>> from diffusers import KandinskyInpaintPipeline, KandinskyPriorPipeline
>>> from diffusers.utils import load_image
>>> import torch
>>> import numpy as np

>>> pipe_prior = KandinskyPriorPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-prior", torch_dtype=torch.float16
... )
>>> pipe_prior.to("cuda")

>>> prompt = "a hat"
>>> image_emb, zero_image_emb = pipe_prior(prompt, return_dict=False)

>>> pipe = KandinskyInpaintPipeline.from_pretrained(
...     "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
... )
>>> pipe.to("cuda")

>>> init_image = load_image(
...     "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main"
...     "/kandinsky/cat.png"
... )

>>> mask = np.zeros((768, 768), dtype=np.float32)
>>> mask[:250, 250:-250] = 1

>>> out = pipe(
...     prompt,
...     image=init_image,
...     mask_image=mask,
...     image_embeds=image_emb,
...     negative_image_embeds=zero_image_emb,
...     height=768,
...     width=768,
...     num_inference_steps=50,
... )

>>> image = out.images[0]
>>> image.save("cat_with_hat.png")
KandinskyInpaintCombinedPipeline
classe diffusers.KandinskyInpaintCombinedPipeline
< source >( text_encoder: MultilingualCLIPtokenizer: XLMRobertaTokenizerunet: UNet2DConditionModelscheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_ddpm.DDPMSchedulermovq: VQModelprior_prior: PriorTransformerprior_image_encoder: CLIPVisionModelWithProjectionprior_text_encoder: CLIPTextModelWithProjectionprior_tokenizer: CLIPTokenizerprior_scheduler: UnCLIPSchedulerprior_image_processor: CLIPImageProcessorPil )
Paramètres
- text_encoder (
MultilingualCLIP) — Encodeur de texte figé. - tokenizer (
XLMRobertaTokenizer) — Tokenizer de classe - scheduler (
DDIMScheduler|DDPMScheduler) — Un planificateur à utiliser en combinaison avecunetpour générer des latents d’image. - unet (UNet2DConditionModel) — Architecture U-Net conditionnelle pour le débruitage de l’embedding d’image.
- movq (VQModel) — Décodeur MoVQ pour générer l'image à partir des latents.
- prior_prior (PriorTransformer) — Le prior unCLIP canonique pour approximer l’embedding d’image à partir de l’embedding de texte.
- prior_image_encoder (
CLIPVisionModelWithProjection) — Encodeur d'images figé. - prior_text_encoder (
CLIPTextModelWithProjection) — Encodeur de texte figé. - prior_tokenizer (
CLIPTokenizer) — Tokenizer de la classe CLIPTokenizer. - prior_scheduler (
UnCLIPScheduler) — Un planificateur à utiliser en combinaison avecpriorpour générer l’embedding d’image.
Pipeline combiné pour la génération à l'aide de Kandinsky
Ce modèle hérite de DiffusionPipeline. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous les pipelines (tels que le téléchargement ou l'enregistrement, l'exécution sur un appareil particulier, etc.)
__call__
< source >( prompt: str | list[str]image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]mask_image: typing.Union[torch.Tensor, list[torch.Tensor], PIL.Image.Image, list[PIL.Image.Image]]negative_prompt: str | list[str] | None = Nonenum_inference_steps: int = 100guidance_scale: float = 4.0num_images_per_prompt: int = 1height: int = 512width: int = 512prior_guidance_scale: float = 4.0prior_num_inference_steps: int = 25generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'callback: typing.Optional[typing.Callable[[int, int, torch.Tensor], NoneType]] = Nonecallback_steps: int = 1return_dict: bool = True ) → ImagePipelineOutput or tuple
Paramètres
- prompt (
stroulist[str]) — Le prompt ou les prompts pour guider la génération d’image. - image (
torch.Tensor,PIL.Image.Image,np.ndarray,list[torch.Tensor],list[PIL.Image.Image]oulist[np.ndarray]) —Imageou tenseur représentant un lot d’images, qui servira de point de départ au processus. Peut également accepter des latents d’image en tant queimage; si des latents sont transmis directement, ils ne seront pas réencodés. - mask_image (
np.array) — Tenseur représentant un lot d’images, servant à masquerimage. Les pixels blancs du masque seront repeints, tandis que les pixels noirs seront conservés. Simask_imageest une image PIL, elle sera convertie en un seul canal (luminance) avant utilisation. S’il s’agit d’un tenseur, il doit contenir un seul canal de couleur (L) au lieu de 3, la forme attendue étant donc(B, H, W, 1). - negative_prompt (
stroulist[str], facultatif) — Le ou les prompts à ne pas utiliser pour guider la génération d’image. Ignoré lorsque la guidance n’est pas utilisée (c’est-à-dire ignoré siguidance_scaleest inférieur à1). - num_images_per_prompt (
int, facultatif, valeur par défaut 1) — Le nombre d'images à générer par invite. - num_inference_steps (
int, facultatif, valeur par défaut 100) — Le nombre d'étapes de débruitage. Un plus grand nombre d'étapes de débruitage conduit généralement à une image de meilleure qualité, au prix d'une inférence plus lente. - height (
int, facultatif, par défaut 512) — La hauteur en pixels de l'image générée. - width (
int, facultatif, par défaut 512) — La largeur en pixels de l'image générée. - prior_guidance_scale (
float, facultatif, valeur par défaut 4.0) — Échelle de guidage telle que définie dans Classifier-Free Diffusion Guidance.guidance_scaleest défini commewde l’équation 2 de Imagen Paper. L’échelle de guidage est activée en définissantguidance_scale > 1. Une échelle de guidage plus élevée encourage la génération d’images étroitement liées auprompttexte, généralement au détriment de la qualité de l’image. - prior_num_inference_steps (
int, facultatif, valeur par défaut 100) — Le nombre d'étapes de débruitage. Un plus grand nombre d'étapes de débruitage conduit généralement à une image de meilleure qualité, au prix d'une inférence plus lente. - guidance_scale (
float, facultatif, valeur par défaut 4.0) — Échelle de guidage telle que définie dans Classifier-Free Diffusion Guidance.guidance_scaleest défini commewde l’équation 2 de Imagen Paper. L’échelle de guidage est activée en définissantguidance_scale > 1. Une échelle de guidage plus élevée encourage la génération d’images étroitement liées auprompttexte, généralement au détriment de la qualité de l’image. - generator (
torch.Generatoroulist[torch.Generator], facultatif) — Un ou une liste de générateurs torch pour rendre la génération déterministe. - latents (
torch.Tensor, facultatif) — Latents bruités pré-générés, échantillonnés à partir d’une distribution gaussienne, à utiliser comme entrées pour la génération d’images. Peut être utilisé pour ajuster la même génération avec des prompts différents. S’il n’est pas fourni, un tenseur de latents sera généré par échantillonnage à l’aide dugeneratoraléatoire fourni. - output_type (
str, facultatif, par défaut"pil") — Le format de sortie de l'image générée. Choisissez entre :"pil"(PIL.Image.Image),"np"(np.array) ou"pt"(torch.Tensor). - callback (
Callable, facultatif) — Une fonction appelée toutes lescallback_stepsétapes pendant l'inférence. La fonction est appelée avec les arguments suivants :callback(step: int, timestep: int, latents: torch.Tensor). - callback_steps (
int, facultatif, valeur par défaut 1) — La fréquence à laquelle la fonctioncallbackest appelée. Si non spécifié, le callback est appelé à chaque étape. - return_dict (
bool, facultatif, par défautTrue) — Indique s'il faut retourner un ImagePipelineOutput plutôt qu'un simple tuple.
Retourne
ImagePipelineOutput ou tuple
Fonction appelée lors de l'appel du pipeline pour la génération.
Exemples :
from diffusers import AutoPipelineForInpainting
from diffusers.utils import load_image
import torch
import numpy as np

pipe = AutoPipelineForInpainting.from_pretrained(
    "kandinsky-community/kandinsky-2-1-inpaint", torch_dtype=torch.float16
)
pipe.enable_model_cpu_offload()

prompt = "A fantasy landscape, Cinematic lighting"
negative_prompt = "low quality, bad quality"

original_image = load_image(
    "https://huggingface.co/datasets/hf-internal-testing/diffusers-images/resolve/main" "/kandinsky/cat.png"
)

mask = np.zeros((768, 768), dtype=np.float32)
# Let's mask out an area above the cat's head
mask[:250, 250:-250] = 1

image = pipe(prompt=prompt, image=original_image, mask_image=mask, num_inference_steps=25).images[0]
enable_sequential_cpu_offload
< source >( gpu_id: int | None = Nonedevice: typing.Union[torch.device, str] = None )
Décharge tous les modèles sur le CPU à l'aide de accelerate, réduisant ainsi considérablement l'utilisation de la mémoire. Lors de l'appel, les dictionnaires d'état de unet, text_encoder, vae et du vérificateur de sécurité sont enregistrés sur le CPU, puis déplacés vers un torch.device('meta') and loaded to GPU only when their specific submodule has itsforwardmethod called. Note that offloading happens on a submodule basis. Memory savings are higher than withenable_model_cpu_offload`, mais les performances sont inférieures.