
Diffusers documentation
OmniGen
OmniGen
OmniGen: Unified Image Generation de BAAI, por Shitao Xiao, Yueze Wang, Junjie Zhou, Huaying Yuan, Xingrun Xing, Ruiran Yan, Chaofan Li, Shuting Wang, Tiejun Huang, Zheng Liu.
El resumen del artículo es:
El surgimiento de los Modelos de Lenguaje de Gran Escala (LLM) ha unificado las tareas de generación de lenguaje y ha revolucionado la interacción humano-máquina. Sin embargo, en el ámbito de la generación de imágenes, un modelo unificado capaz de manejar diversas tareas dentro de un único marco sigue siendo en gran medida inexplorado. En este trabajo, presentamos OmniGen, un nuevo modelo de difusión para la generación unificada de imágenes. OmniGen se caracteriza por las siguientes características: 1) Unificación: OmniGen no solo demuestra capacidades de generación de texto a imagen, sino que también admite de forma inherente diversas tareas descendentes, como la edición de imágenes, la generación dirigida por sujeto y la generación condicional visual. 2) Simplicidad: La arquitectura de OmniGen está altamente simplificada, eliminando la necesidad de complementos adicionales. Además, en comparación con los modelos de difusión existentes, es más fácil de usar y puede completar tareas complejas de extremo a extremo mediante instrucciones, sin la necesidad de pasos intermedios adicionales, simplificando en gran medida el flujo de trabajo de generación de imágenes. 3) Transferencia de conocimiento: Gracias al aprendizaje en un formato unificado, OmniGen transfiere de manera efectiva el conocimiento entre diferentes tareas, gestiona tareas y dominios no vistos y exhibe capacidades novedosas. También exploramos las capacidades de razonamiento del modelo y las aplicaciones potenciales del mecanismo de cadena de pensamiento. Este trabajo representa el primer intento de un modelo de generación de imágenes de uso general, y publicaremos nuestros recursos en https://github.com/VectorSpaceLab/OmniGen para fomentar avances futuros.
Asegúrate de consultar la guía de Schedulers para aprender a explorar el equilibrio entre la velocidad y la calidad del scheduler, y consulta la sección reutilizar componentes entre pipelines para aprender a cargar eficientemente los mismos componentes en múltiples pipelines.
Este pipeline fue aportado por staoxiao. La base de código original se puede encontrar aquí. Los pesos originales se pueden encontrar en hf.co/shitao.
Cargar puntos de control de modelos
Los pesos del modelo pueden estar almacenados en subcarpetas separadas en el Hub o localmente, en cuyo caso, debe utilizar el método from_pretrained().
import torch
from diffusers import OmniGenPipeline

pipe = OmniGenPipeline.from_pretrained("Shitao/OmniGen-v1-diffusers", dtype=torch.bfloat16)
Texto a imagen
Para texto a imagen, pasa un prompt de texto. Por defecto, OmniGen genera una imagen de 1024x1024.
Puedes intentar establecer los parámetros height y width para generar imágenes de diferentes tamaños.
import torch
from diffusers import OmniGenPipeline

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt = "Realistic photo. A young woman sits on a sofa, holding a book and facing the camera. She wears delicate silver hoop earrings adorned with tiny, sparkling diamonds that catch the light, with her long chestnut hair cascading over her shoulders. Her eyes are focused and gentle, framed by long, dark lashes. She is dressed in a cozy cream sweater, which complements her warm, inviting smile. Behind her, there is a table with a cup of water in a sleek, minimalist blue mug. The background is a serene indoor setting with soft natural light filtering through a window, adorned with tasteful art and flowers, creating a cozy and peaceful ambiance. 4K, HD."
image = pipe(
    prompt=prompt,
    height=1024,
    width=1024,
    guidance_scale=3,
    generator=torch.Generator(device="cpu").manual_seed(111),
).images[0]
image.save("output.png")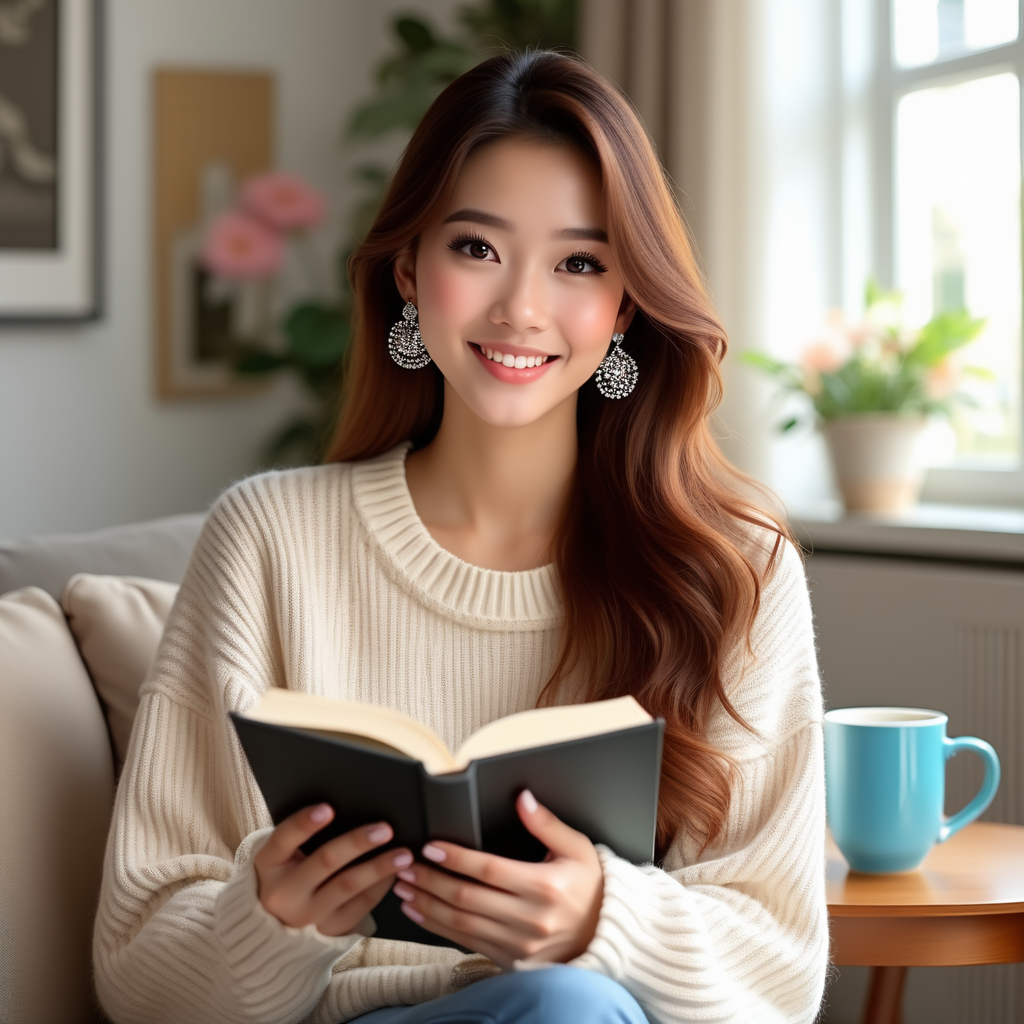
Edición de imagen
OmniGen admite entradas multimodales.
Cuando la entrada incluye una imagen, es necesario añadir un marcador de posición <img><|image_1|></img> en el prompt de texto para representar la imagen.
Se recomienda habilitar use_input_image_size_as_output para que la imagen editada mantenga el mismo tamaño que la imagen original.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="<img><|image_1|></img> Remove the woman's earrings. Replace the mug with a clear glass filled with sparkling iced cola."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/t2i_woman_with_book.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(222)
).images[0]
image.save("output.png") 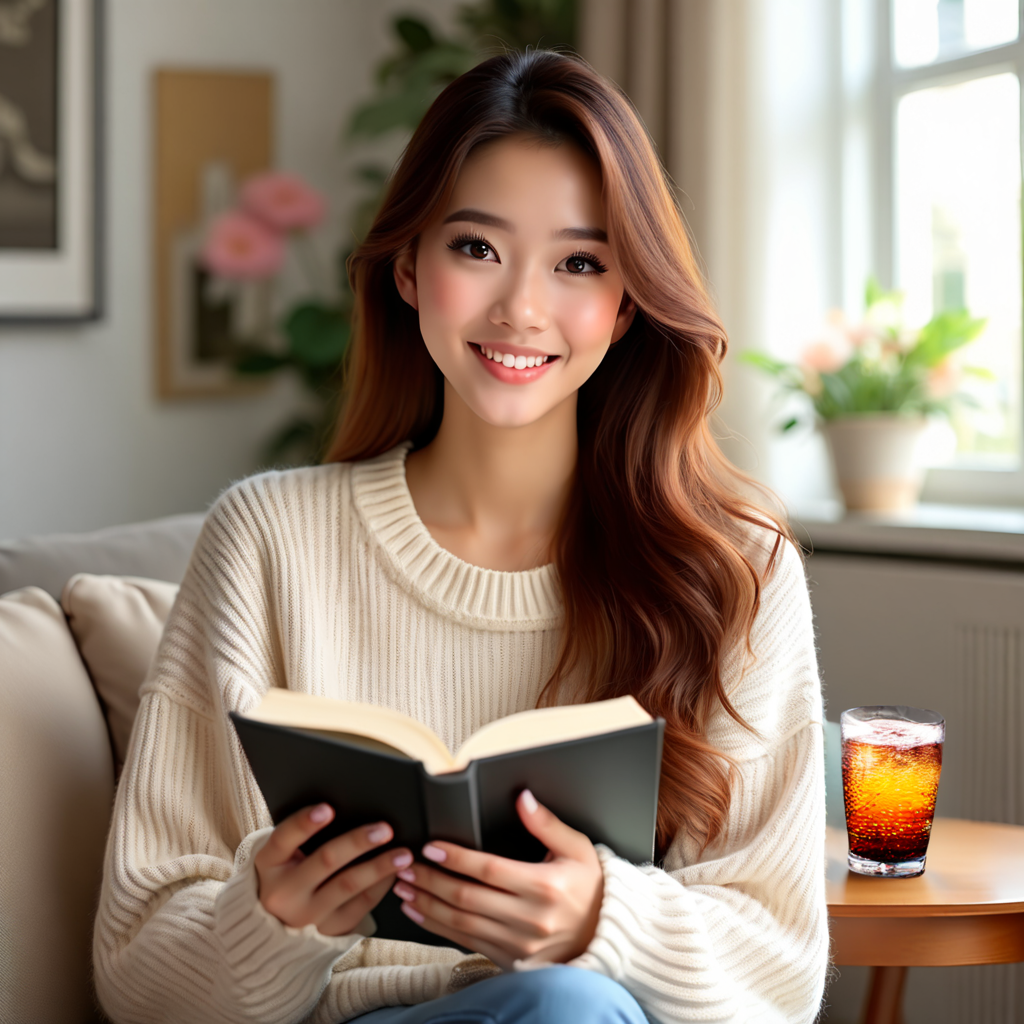
OmniGen cuenta con algunas funciones interesantes, como el razonamiento visual, como se muestra en el ejemplo siguiente.
prompt="If the woman is thirsty, what should she take? Find it in the image and highlight it in blue. <img><|image_1|></img>"
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(0)
).images[0]
image.save("output.png")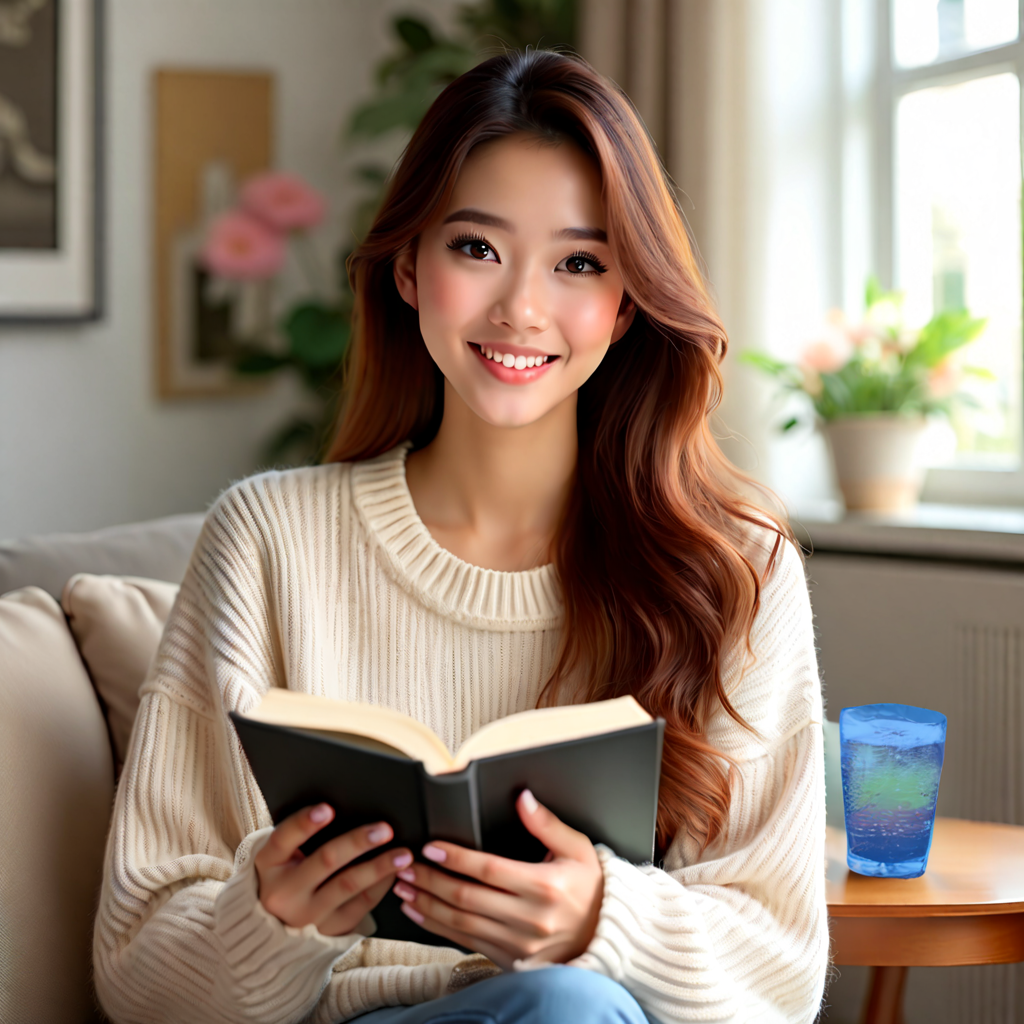
Generación controlable
OmniGen puede manejar varias tareas clásicas de visión por computadora. Como se muestra a continuación, OmniGen puede detectar esqueletos humanos en las imágenes de entrada, lo que puede usarse como condiciones de control para generar nuevas imágenes.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="Detect the skeleton of human in this image: <img><|image_1|></img>"
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image1 = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(333)
).images[0]
image1.save("image1.png")

prompt="Generate a new photo using the following picture and text as conditions: <img><|image_1|></img>\n A young boy is sitting on a sofa in the library, holding a book. His hair is neatly combed, and a faint smile plays on his lips, with a few freckles scattered across his cheeks. The library is quiet, with rows of shelves filled with books stretching out behind him."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/skeletal.png")]
image2 = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(333)
).images[0]
image2.save("image2.png") 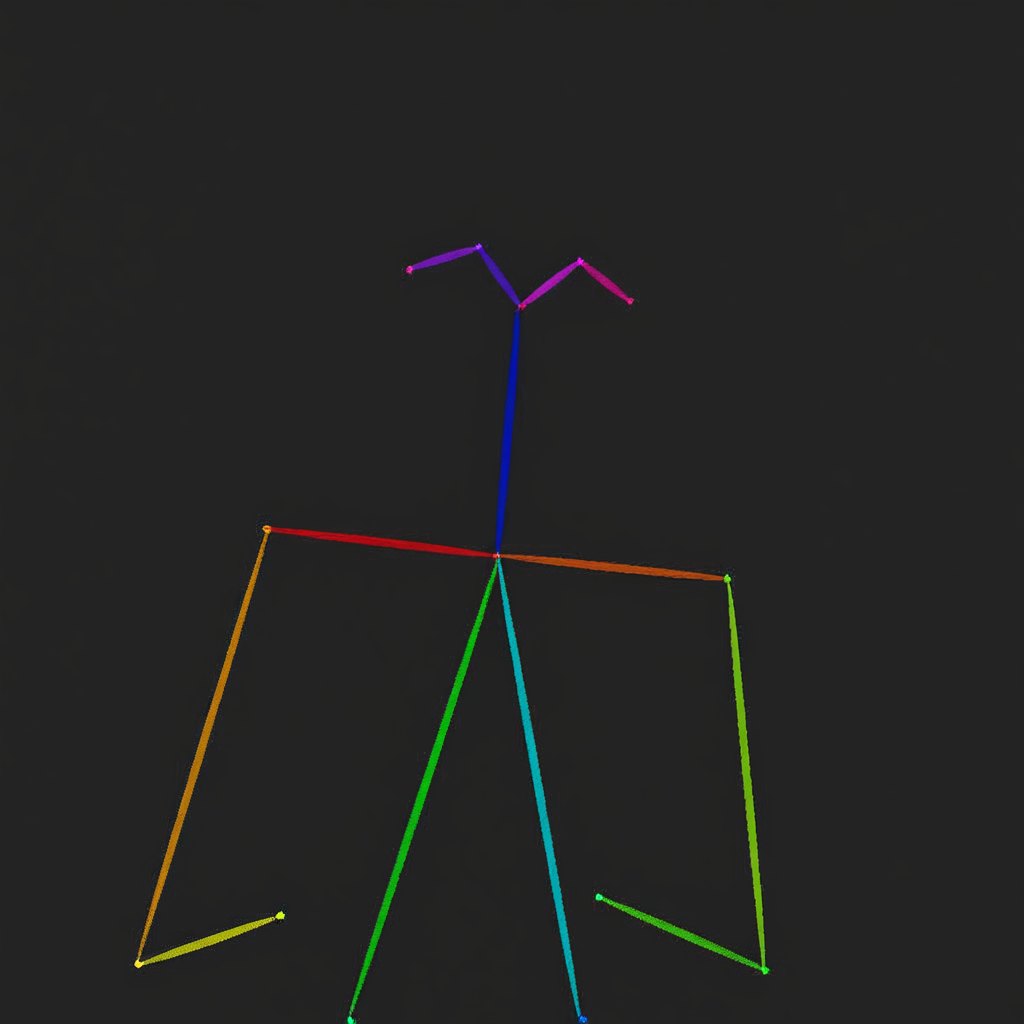
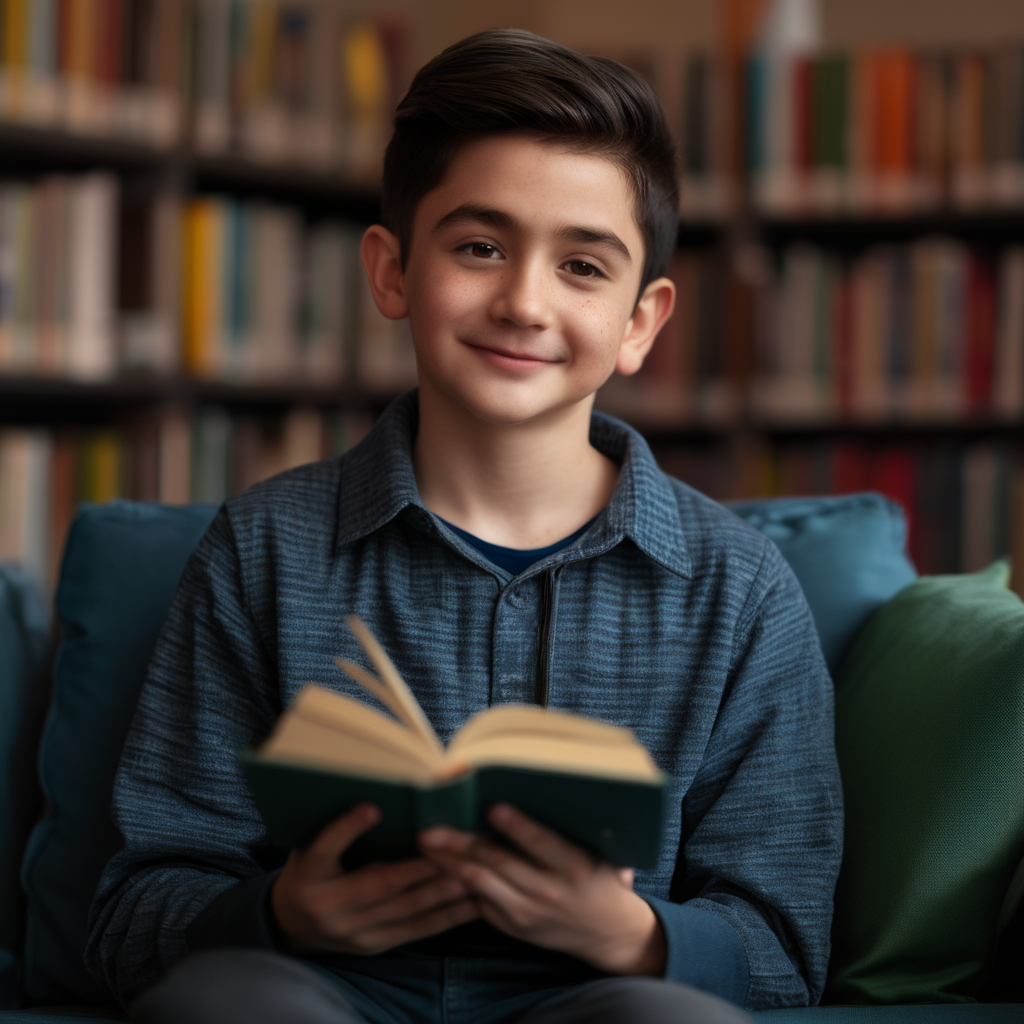
OmniGen también puede utilizar directamente la información relevante de las imágenes de entrada para generar nuevas imágenes.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="Following the pose of this image <img><|image_1|></img>, generate a new photo: A young boy is sitting on a sofa in the library, holding a book. His hair is neatly combed, and a faint smile plays on his lips, with a few freckles scattered across his cheeks. The library is quiet, with rows of shelves filled with books stretching out behind him."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(0)
).images[0]
image.save("output.png")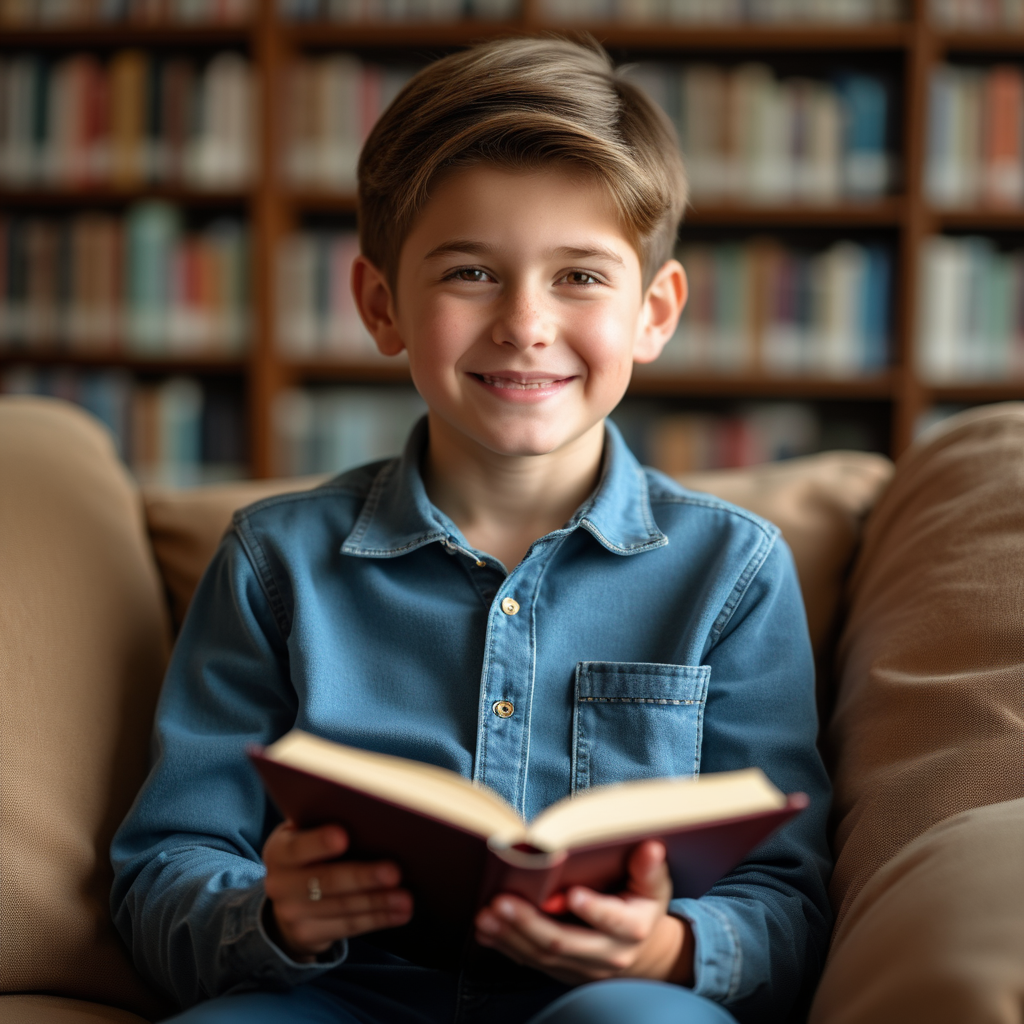
Preservación de ID y objetos
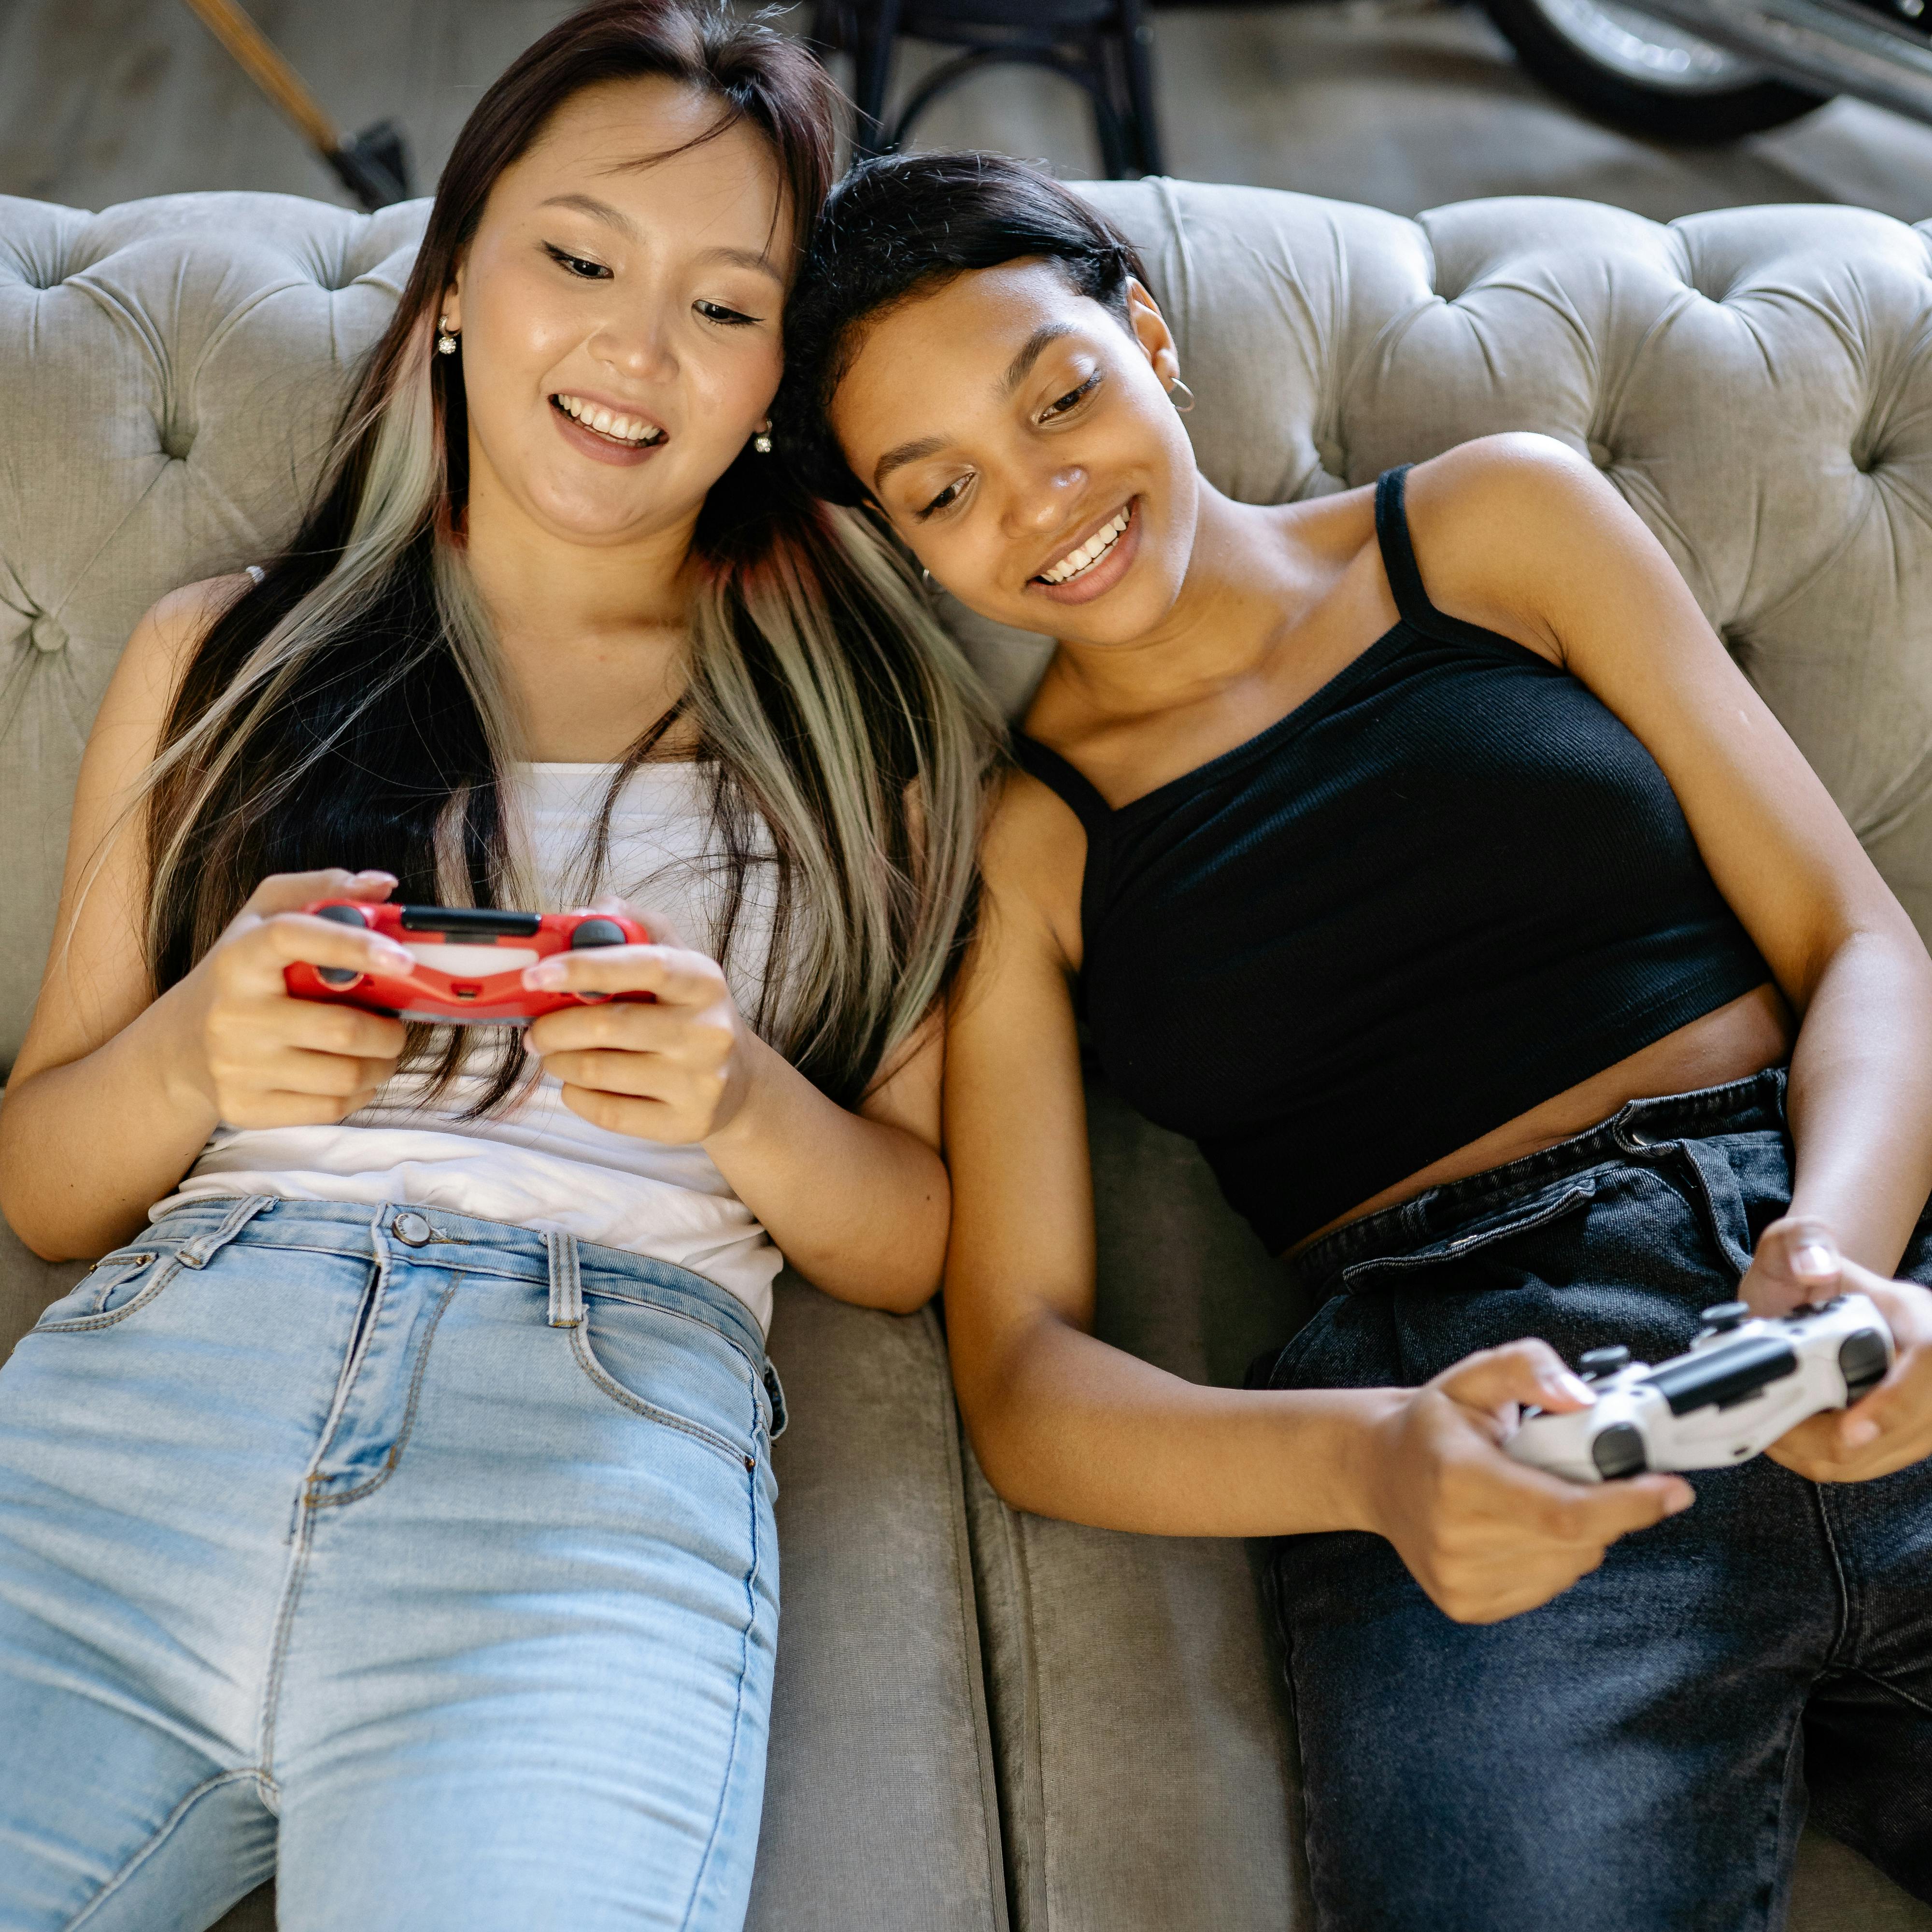
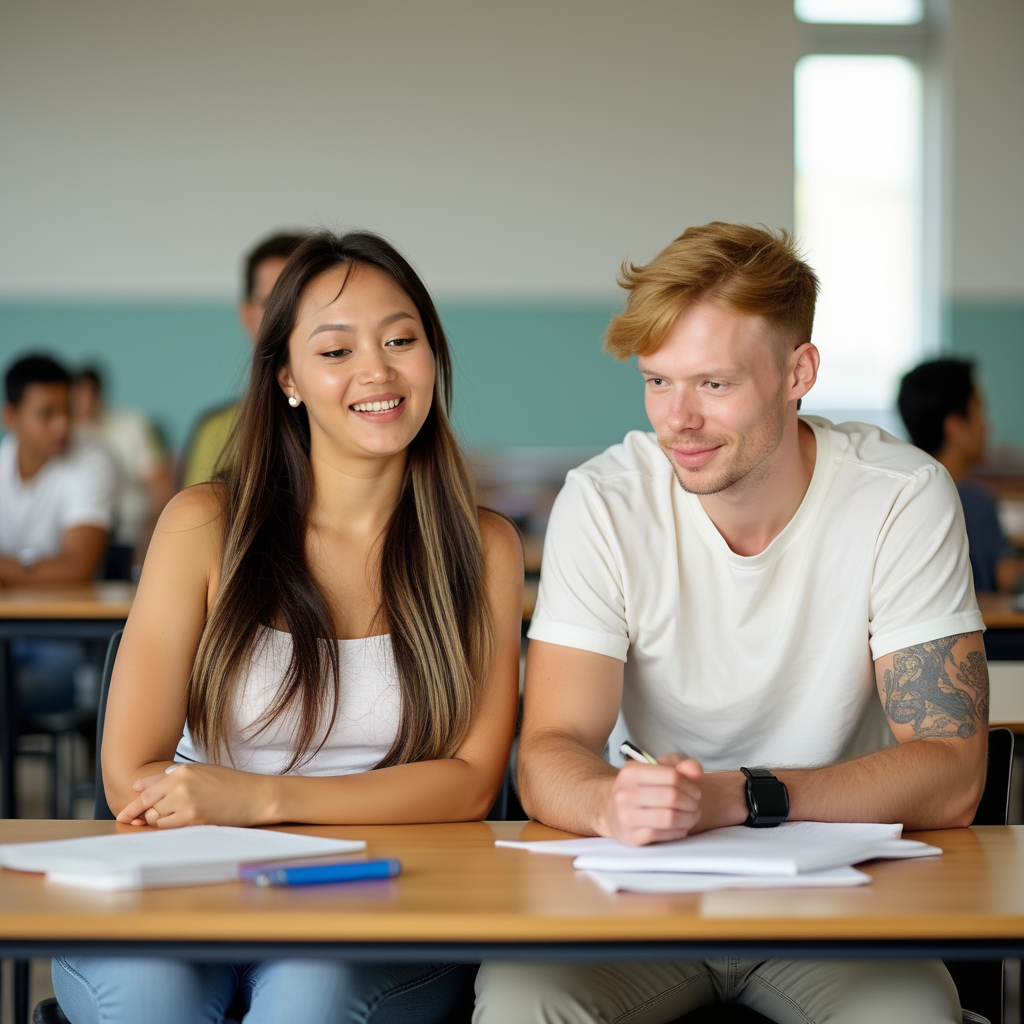
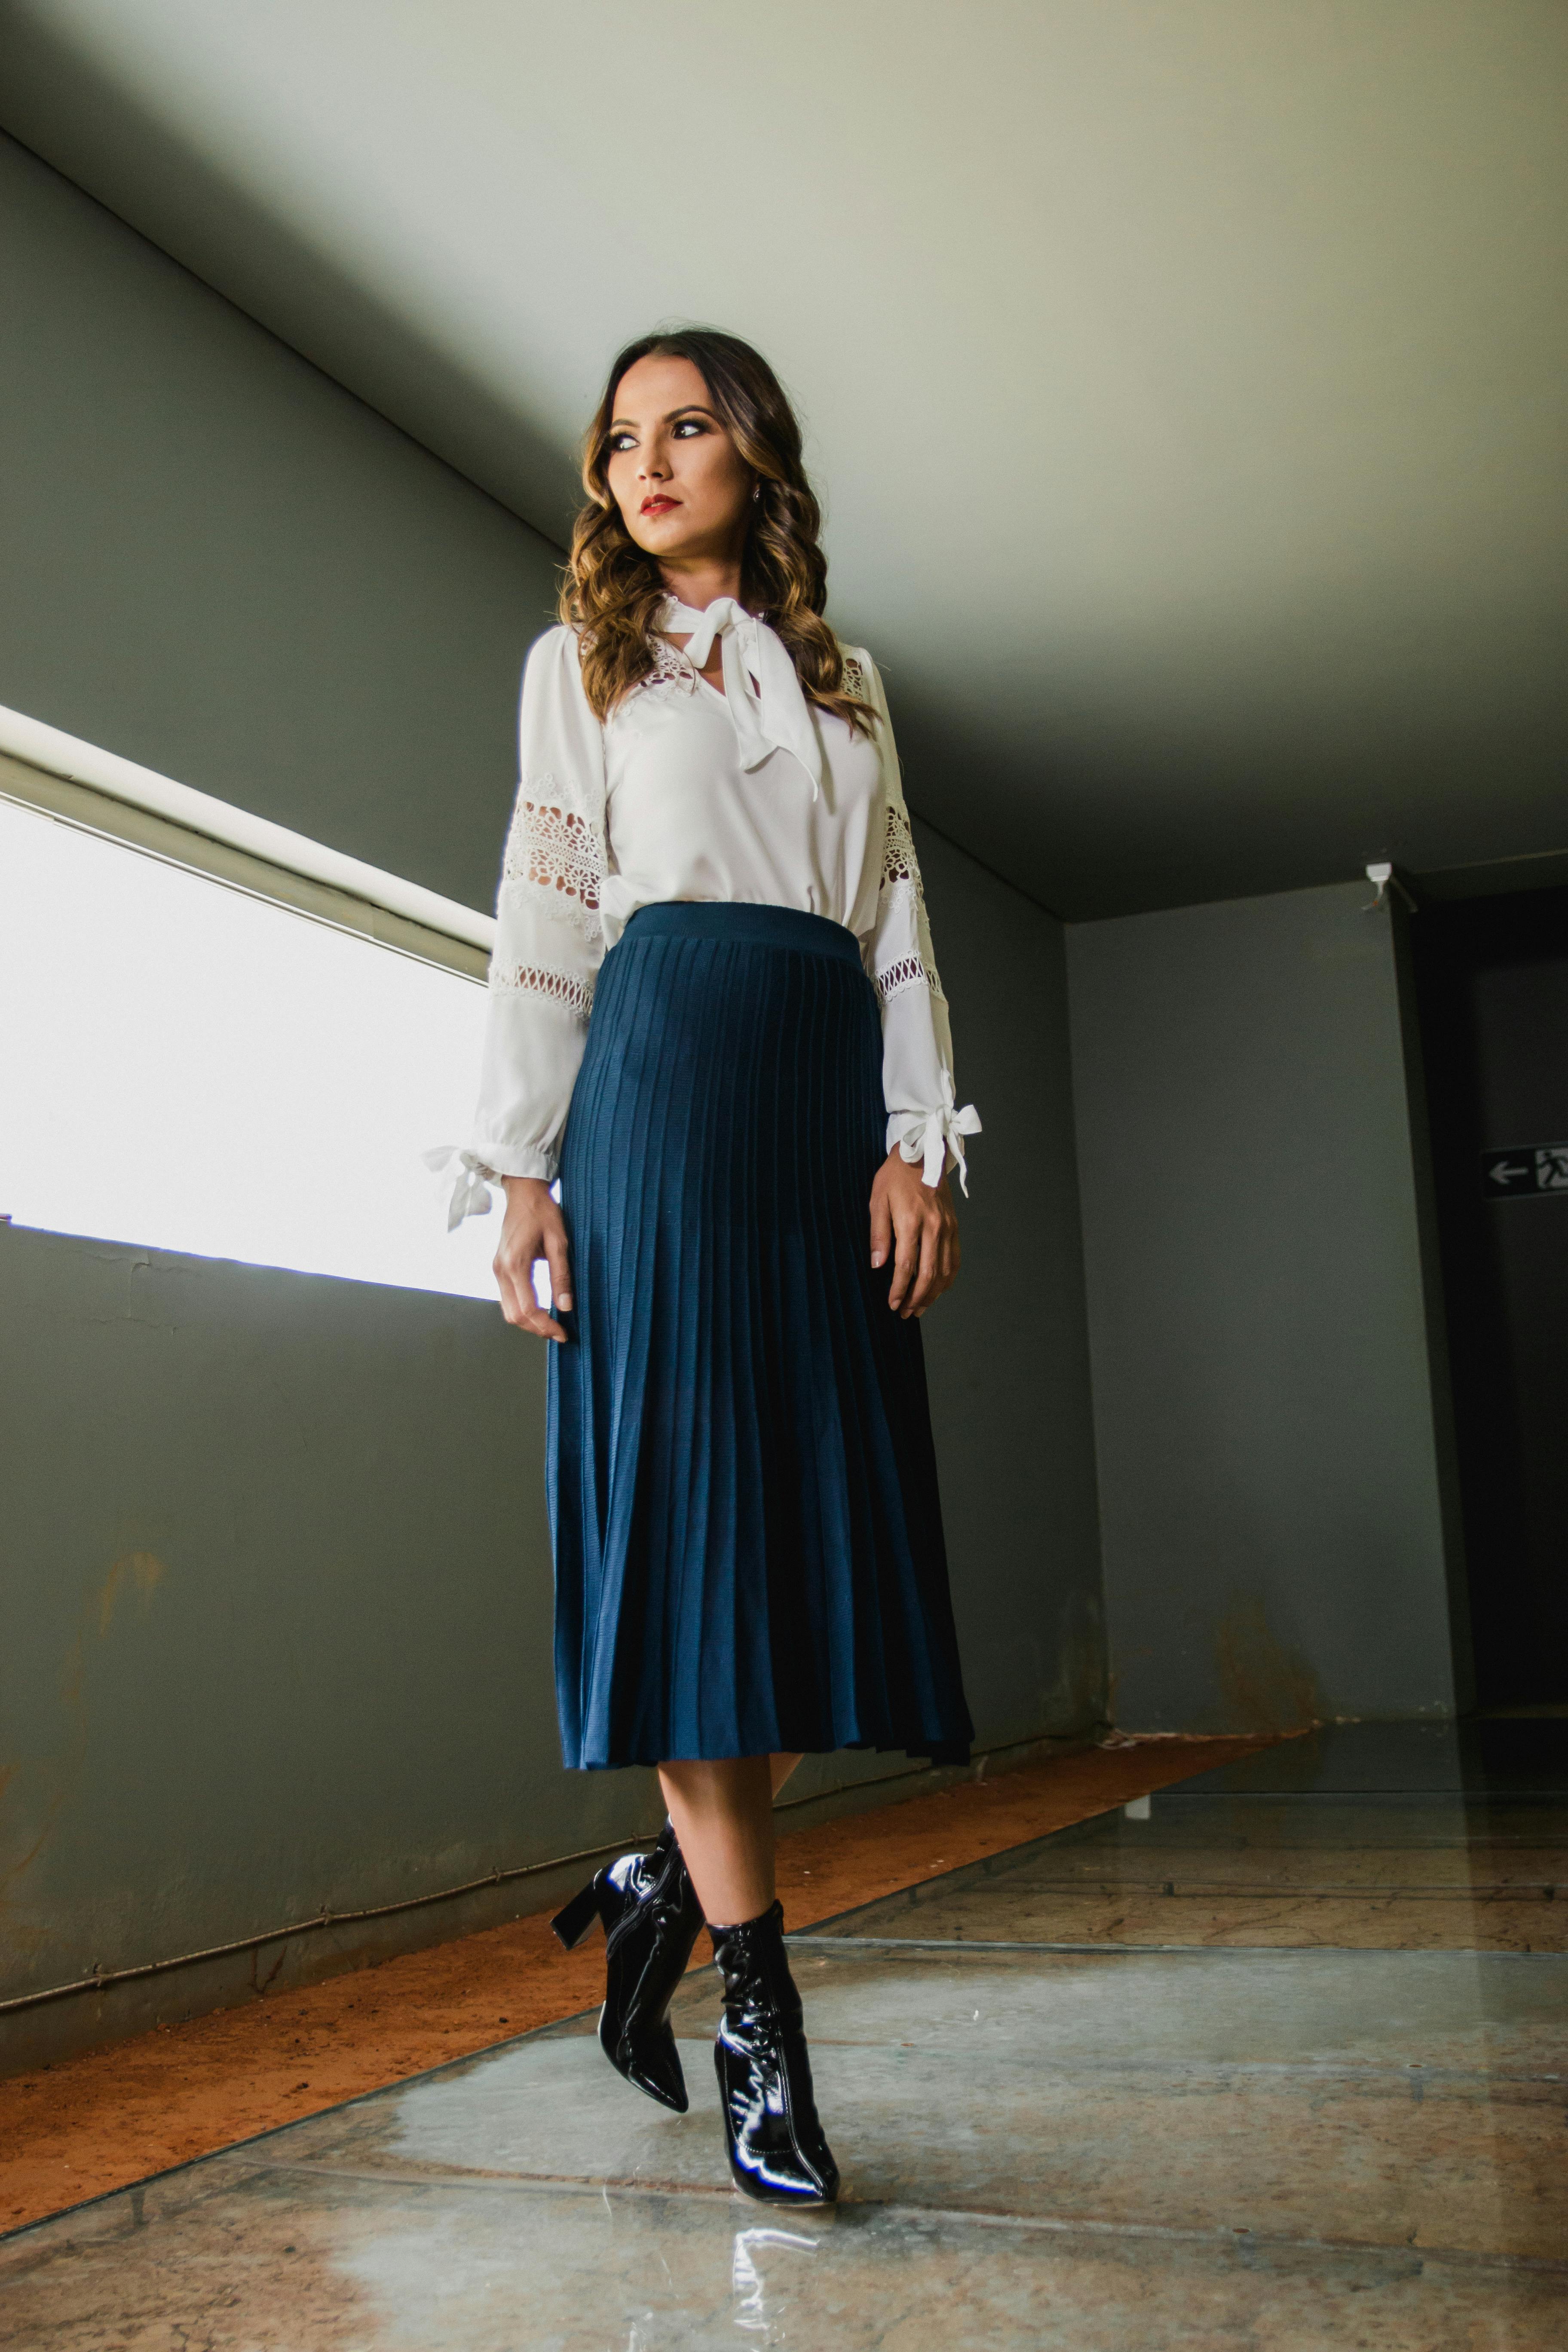
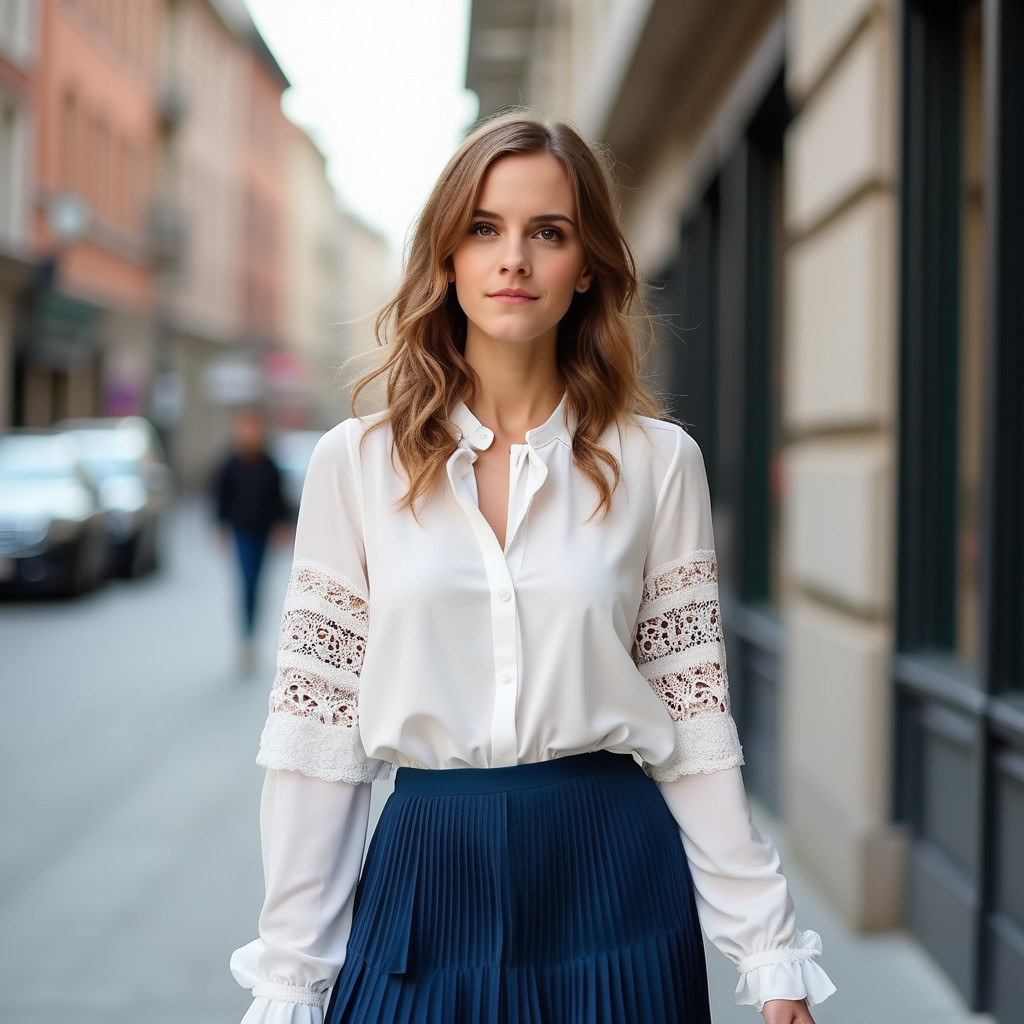
OmniGen puede generar varias imágenes basándose en las personas y los objetos de la imagen de entrada y admite la entrada de varias imágenes simultáneamente. Además, OmniGen puede extraer los objetos deseados de una imagen que contiene varios objetos en función de las instrucciones.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="A man and a woman are sitting at a classroom desk. The man is the man with yellow hair in <img><|image_1|></img>. The woman is the woman on the left of <img><|image_2|></img>"
input_image_1 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/3.png")
input_image_2 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/4.png")
input_images=[input_image_1, input_image_2]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    height=1024,
    width=1024,
    guidance_scale=2.5,
    img_guidance_scale=1.6,
    generator=torch.Generator(device="cpu").manual_seed(666)
).images[0]
image.save("output.png")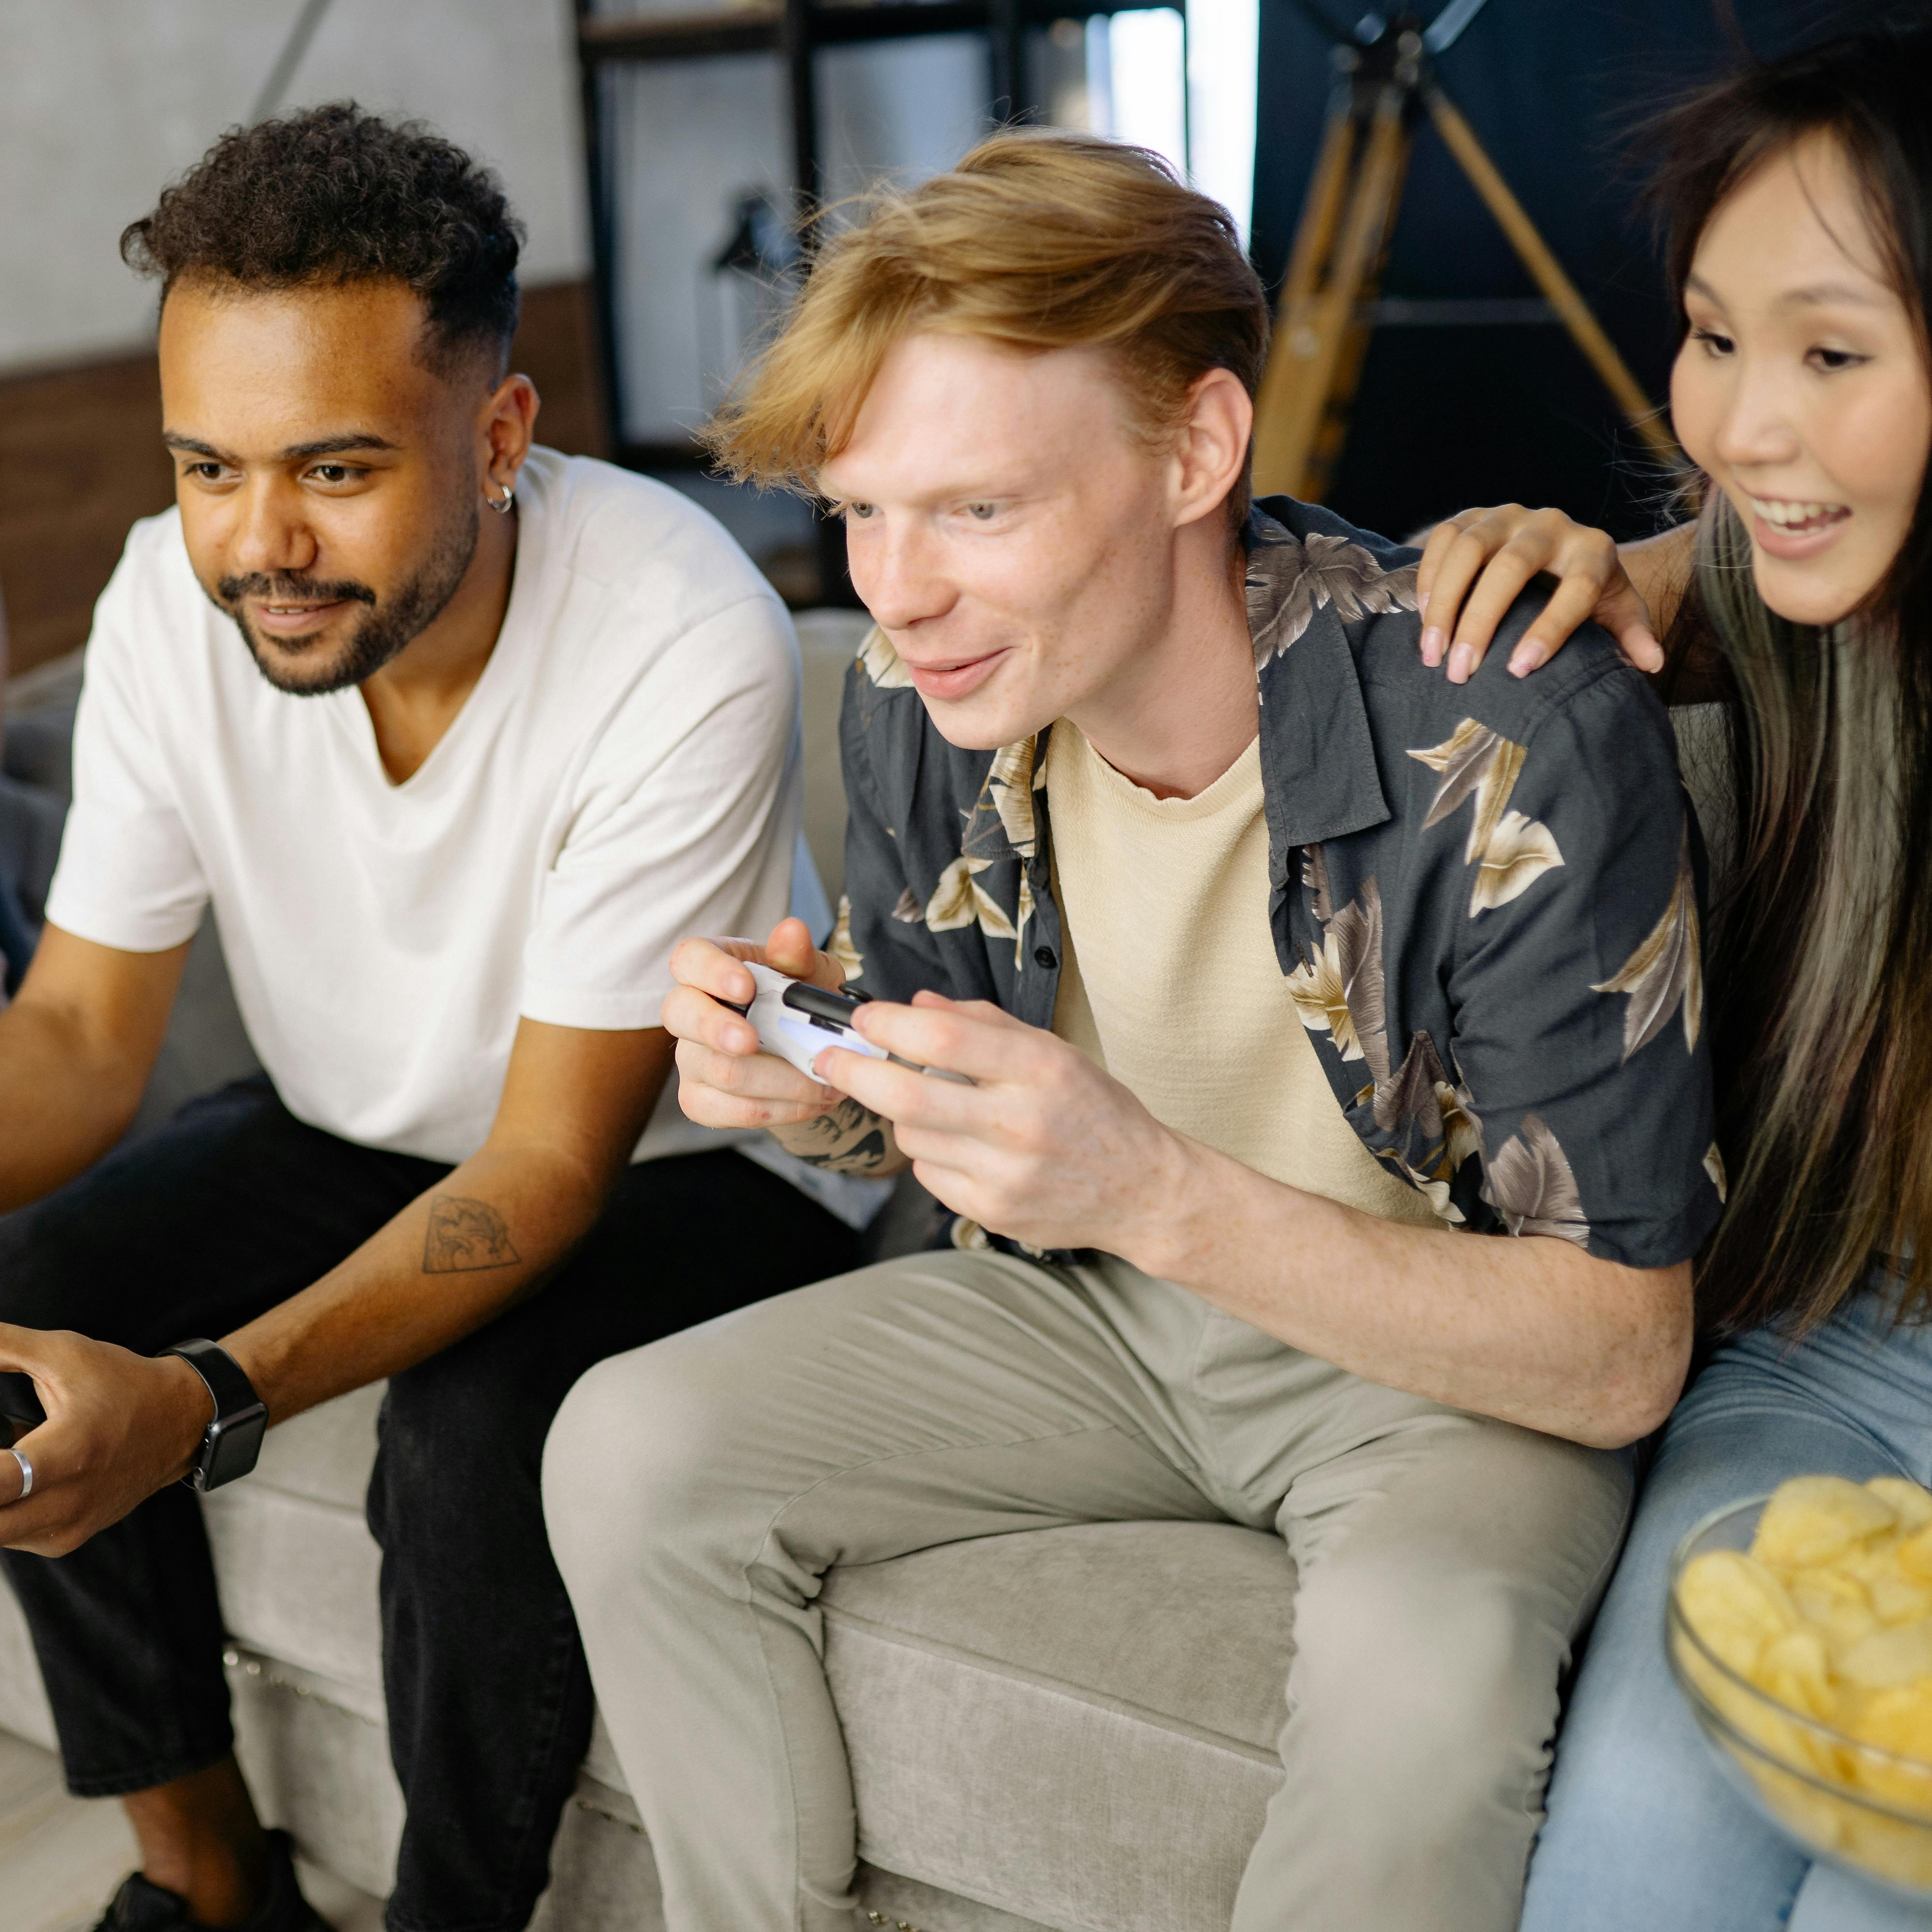
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="A woman is walking down the street, wearing a white long-sleeve blouse with lace details on the sleeves, paired with a blue pleated skirt. The woman is <img><|image_1|></img>. The long-sleeve blouse and a pleated skirt are <img><|image_2|></img>."
input_image_1 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/emma.jpeg")
input_image_2 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/dress.jpg")
input_images=[input_image_1, input_image_2]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    height=1024,
    width=1024,
    guidance_scale=2.5,
    img_guidance_scale=1.6,
    generator=torch.Generator(device="cpu").manual_seed(666)
).images[0]
image.save("output.png")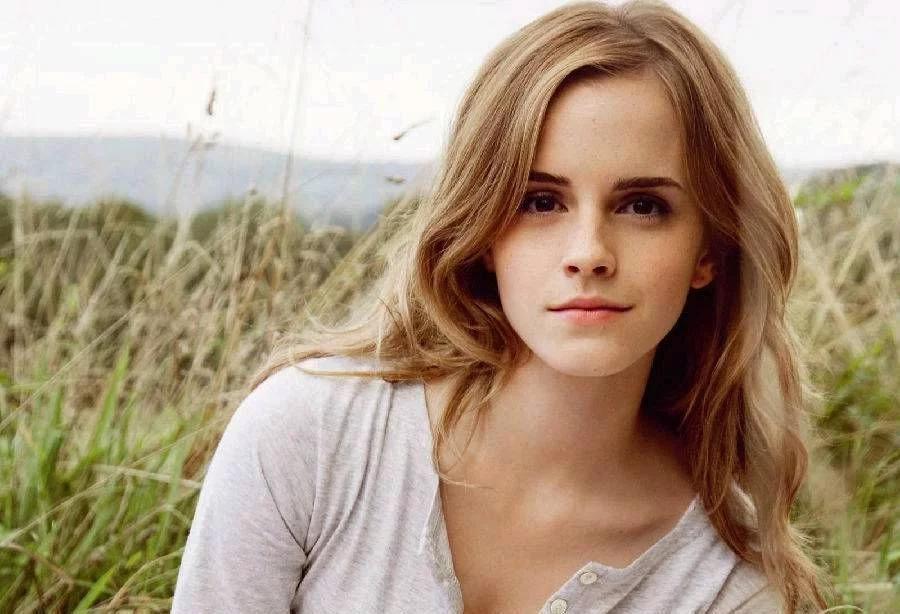
Optimización al usar varias imágenes
Para la tarea de texto a imagen, OmniGen requiere un coste mínimo de memoria y tiempo (9 GB de memoria y 31 s para una imagen de 1024x1024 en una GPU A800). Sin embargo, al utilizar imágenes de entrada, el coste computacional aumenta.
A continuación se presentan algunas directrices para ayudarle a reducir los costos computacionales al utilizar varias imágenes. Los experimentos se realizan en una GPU A800 con dos imágenes de entrada.
Como en otros pipelines, puedes reducir el uso de memoria descargando el modelo: pipe.enable_model_cpu_offload() o pipe.enable_sequential_cpu_offload().
En OmniGen, también puedes disminuir la sobrecarga computacional reduciendo max_input_image_size.
El consumo de memoria para diferentes tamaños de imagen se muestra en la tabla siguiente:
| Método | Uso de memoria |
|---|---|
| max_input_image_size=1024 | 40GB |
| max_input_image_size=512 | 17GB |
| max_input_image_size=256 | 14GB |
OmniGenPipeline
clase diffusers.OmniGenPipeline
< source >( transformer: OmniGenTransformer2DModelscheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtokenizer: LlamaTokenizer )
Parámetros
- transformer (OmniGenTransformer2DModel) — Arquitectura de Transformer autoregresiva para OmniGen.
- scheduler (FlowMatchEulerDiscreteScheduler) —
Un scheduler para usar en combinación con
transformerpara desruidar los latentes de imagen codificados. - vae (AutoencoderKL) — Modelo de Variational Auto-Encoder (VAE) para codificar y decodificar imágenes a partir de y hacia representaciones latentes.
- tokenizer (
LlamaTokenizer) — Tokenizador de texto de la clase LlamaTokenizer.
El pipeline OmniGen para la generación de imágenes a partir de multimodal.
Referencia: https://huggingface.co/papers/2409.11340
__call__
< source >( prompt: str | list[str]input_images: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]]] = Noneheight: int | None = Nonewidth: int | None = Nonenum_inference_steps: int = 50max_input_image_size: int = 1024timesteps: list = Noneguidance_scale: float = 2.5img_guidance_scale: float = 1.6use_input_image_size_as_output: bool = Falsenum_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list = ['latents'] ) → ImagePipelineOutput or tuple
Parámetros
- prompt (
strolist[str], opcional) — El prompt o prompts para guiar la generación de la imagen. Si la entrada incluye imágenes, es necesario añadir marcadores de posición<img><|image_i|></img>en el prompt para indicar la posición de la i-ésima imagen. - input_images (
PipelineImageInputolist[PipelineImageInput], opcional) — La lista de imágenes de entrada. Reemplazaremos el ”<|image_i|>” en el prompt con la i-ésima imagen de la lista. - height (
int, opcional, por defecto self.unet.config.sample_size * self.vae_scale_factor) — La altura en píxeles de la imagen generada. Por defecto, se establece en 1024 para obtener los mejores resultados. - width (
int, opcional, valor predeterminado self.unet.config.sample_size * self.vae_scale_factor) — El ancho en píxeles de la imagen generada. Por defecto, se establece en 1024 para obtener los mejores resultados. - num_inference_steps (
int, opcional, valor predeterminado 50) — El número de pasos de desruido. Más pasos de desruido suelen conducir a una imagen de mayor calidad a costa de una inferencia más lenta. - max_input_image_size (
int, opcional, valor predeterminado 1024) — el tamaño máximo de la imagen de entrada, que se utilizará para recortar la imagen de entrada al tamaño máximo - timesteps (
list[int], opcional) — Pasos de tiempo personalizados para usar en el proceso de desruido con programadores que admiten un argumentotimestepsen su métodoset_timesteps. Si no se define, se usará el comportamiento predeterminado cuando se pasenum_inference_steps. Debe estar en orden descendente. - guidance_scale (
float, opcional, valor predeterminado 2.5) — Escala de guía tal como se define en Classifier-Free Diffusion Guidance.guidance_scalese define comowde la ecuación 2 de Imagen Paper. La escala de guía se habilita al establecerguidance_scale > 1. Una escala de guía más alta fomenta la generación de imágenes estrechamente vinculadas alpromptde texto, generalmente a costa de una menor calidad de imagen. - img_guidance_scale (
float, opcional, valor predeterminado 1.6) — Definido como la ecuación 3 en Instrucpix2pix. - use_input_image_size_as_output (bool, predeterminado en False) — si se debe usar el tamaño de la imagen de entrada como el tamaño de la imagen de salida, lo cual puede usarse para una sola imagen de entrada, p. ej., en una tarea de edición de imágenes
- num_images_per_prompt (
int, opcional, valor predeterminado 1) — El número de imágenes que se generarán por indicación. - generator (
torch.Generatorolist[torch.Generator], opcional) — Un generador o una lista de generadores de torch para hacer la generación determinista. - latents (
torch.Tensor, opcional) — Latentes ruidosos pregenerados, muestreados de una distribución gaussiana, que se usarán como entradas para la generación de imágenes. Se pueden utilizar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se generará un tensor de latentes mediante muestreo usando elgeneratoraleatorio suministrado. - output_type (
str, opcional, valor predeterminado"pil") — El formato de salida de la imagen generada. Elija entre PIL:PIL.Image.Imageonp.array. - return_dict (
bool, opcional, valor predeterminadoTrue) — Indica si se debe devolver un~pipelines.flux.FluxPipelineOutputen lugar de una tupla simple. - callback_on_step_end (
Callable, opcional) — Una función que se llama al final de cada paso de desruido durante la inferencia. La función se llama con los siguientes argumentos:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargsincluirá una lista de todos los tensores especificados porcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, opcional) — La lista de entradas de tensor para la funcióncallback_on_step_end. Los tensores especificados en la lista se pasarán como argumentocallback_kwargs. Solo podrás incluir variables listadas en el atributo._callback_tensor_inputsde tu clase de pipeline.
Devuelve
ImagePipelineOutput o tuple
ImagePipelineOutput si return_dict es True,
en caso contrario, una tuple. Al devolver una tupla, el primer elemento es una lista con las imágenes generadas.
Función invocada al llamar a la pipeline para la generación.
Ejemplos:
>>> import torch
>>> from diffusers import OmniGenPipeline

>>> pipe = OmniGenPipeline.from_pretrained("Shitao/OmniGen-v1-diffusers", torch_dtype=torch.bfloat16)
>>> pipe.to("cuda")

>>> prompt = "A cat holding a sign that says hello world"
>>> # Depending on the variant being used, the pipeline call will slightly vary.
>>> # Refer to the pipeline documentation for more details.
>>> image = pipe(prompt, num_inference_steps=50, guidance_scale=2.5).images[0]
>>> image.save("output.png")
Devuelve: ImagePipelineOutput o tuple:
Si return_dict es True, se devuelve ImagePipelineOutput; en caso contrario, se devuelve una tuple
cuyo primer elemento es una lista con las imágenes generadas.
encode_input_images
< source >( input_pixel_values: listdevice: typing.Optional[torch.device] = Nonedtype: typing.Optional[torch.dtype] = None )
obtener la representación continua de las imágenes de entrada mediante VAE
Devuelve: torch.Tensor