# Nougat
## Genel Bakış
Nougat modeli, Lukas Blecher, Guillem Cucurull, Thomas Scialom ve Robert Stojnic tarafından [Nougat: Neural Optical Understanding for Academic Documents](https://huggingface.co/papers/2308.13418) makalesinde önerilmiştir. Nougat, [Donut](donut) ile aynı mimariyi kullanır; bu da bir görüntü Transformer kodlayıcı ve bir otoregresif metin Transformer çözücü anlamına gelir. Bu yapı, bilimsel PDF'leri markdown'a çevirerek bu belgelere daha kolay erişim sağlar.
Makalenin özeti aşağıdaki gibidir:
*Bilimsel bilgi büyük ölçüde kitaplar ve bilimsel dergilerde, çoğu zaman PDF formatında saklanır. Ancak PDF formatı, özellikle matematiksel ifadeler için anlamsal bilgi kaybına yol açar. Bilimsel belgeleri bir işaret diline dönüştürmek için Optik Karakter Tanıma (OCR) görevi gerçekleştiren Nougat (Neural Optical Understanding for Academic Documents) adlı bir Görsel Transformer modeli öneriyor ve modelimizin etkinliğini bilimsel belgelerden oluşan yeni bir veri setinde gösteriyoruz. Önerilen yaklaşım, insan tarafından okunabilir belgeler ile makine tarafından okunabilir metin arasındaki boşluğu doldurarak dijital çağda bilimsel bilginin erişilebilirliğini artırmak için umut verici bir çözüm sunmaktadır. Bilimsel metin tanıma alanındaki gelecekteki çalışmaları hızlandırmak için modelleri ve kodu yayımlıyoruz.*
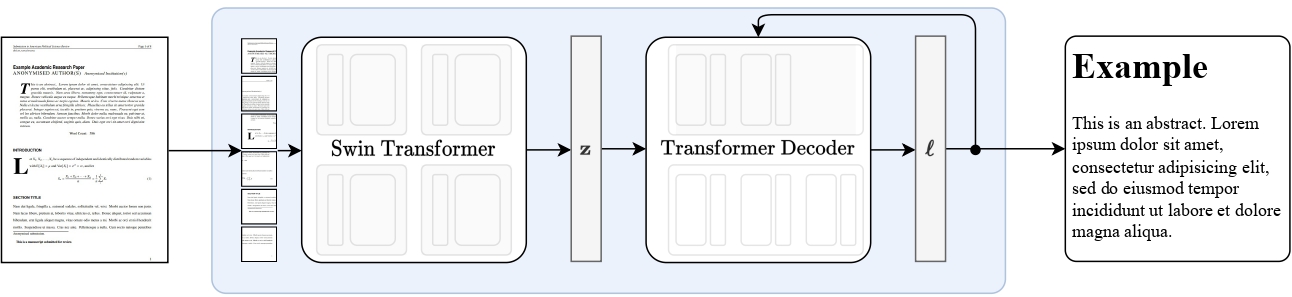 Nougat genel bakış. Orijinal makaleden alınmıştır.
Bu model [nielsr](https://huggingface.co/nielsr) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/facebookresearch/nougat) bulunabilir.
## Kullanım ipuçları
- Nougat ile en hızlı şekilde başlamak için, modelin çıkarım sırasında nasıl kullanılacağını ve özel verilerle ince ayarın nasıl yapılacağını gösteren [öğrenme defterlerine](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Nougat) göz atabilirsiniz.
- Nougat her zaman [VisionEncoderDecoder](vision-encoder-decoder) çerçevesi içinde kullanılır. Model, mimari açısından [Donut](donut) ile özdeştir.
## Çıkarım
Nougat'ın `VisionEncoderDecoder` modeli girdi olarak görüntüler kabul eder ve girdi görüntüsüne dayanarak metni otoregresif olarak üretmek için [generate()](/docs/transformers/v5.23.0/tr/main_classes/text_generation#transformers.GenerationMixin.generate) işlevinden yararlanır.
[NougatImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/nougat#transformers.NougatImageProcessor) sınıfı, girdi görüntüsünün ön işlenmesinden sorumludur ve [NougatTokenizerFast](/docs/transformers/v5.23.0/tr/model_doc/nougat#transformers.NougatTokenizer), üretilen hedef token'ları hedef dizeye çözer. [NougatProcessor](/docs/transformers/v5.23.0/tr/model_doc/nougat#transformers.NougatProcessor), hem girdi özelliklerini çıkarmak hem de tahmin edilen token kimliklerini çözmek için [NougatImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/nougat#transformers.NougatImageProcessor) ve [NougatTokenizerFast](/docs/transformers/v5.23.0/tr/model_doc/nougat#transformers.NougatTokenizer) sınıflarını tek bir örnekte birleştirir.
- Adım adım PDF transkripsiyonu
```python
from huggingface_hub import hf_hub_download
from PIL import Image
from transformers import AutoModelForImageTextToText, NougatProcessor
processor = NougatProcessor.from_pretrained("facebook/nougat-base")
model = AutoModelForImageTextToText.from_pretrained("facebook/nougat-base", device_map="auto")
model.to(model.device) # doctest: +IGNORE_RESULT
# prepare PDF image for the model
filepath = hf_hub_download(repo_id="hf-internal-testing/fixtures_docvqa", filename="nougat_paper.png", repo_type="dataset")
image = Image.open(filepath)
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
# generate transcription (here we only generate 30 tokens)
outputs = model.generate(
pixel_values.to(model.device),
min_length=1,
max_new_tokens=30,
bad_words_ids=[[processor.tokenizer.unk_token_id]],
)
sequence = processor.batch_decode(outputs, skip_special_tokens=True)[0]
sequence = processor.post_process_generation(sequence, fix_markdown=False)
# note: we're using repr here such for the sake of printing the \n characters, feel free to just print the sequence
print(repr(sequence))
'\n\n# Nougat: Neural Optical Understanding for Academic Documents\n\n Lukas Blecher\n\nCorrespondence to: lblecher@'
```
Nougat kontrol noktalarını aramak için [model hub](https://huggingface.co/models?filter=nougat)'a bakın.
Model, mimari açısından [Donut](donut) ile özdeştir.
## NougatConfig[[transformers.NougatConfig]]
#### transformers.NougatConfig[[transformers.NougatConfig]]
```python
transformers.NougatConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, encoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None, decoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/configuration_nougat.py#L28)
**Parametreler:**
is_encoder_decoder (`bool`, *isteğe bağlı*, varsayılan `True`) : Modelin bir kodlayıcı/çözücü olarak kullanılıp kullanılmadığı.
encoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Encoder iskeletinin yapılandırma nesnesi veya sözlüğü.
decoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Dekoder omurgasının yapılandırma nesnesi veya sözlüğü.
Bu, bir NougatModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Nougat modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılanlarla bir yapılandırma örneği oluşturmak, [facebook/nougat-base](https://huggingface.co/facebook/nougat-base) ile benzer bir yapılandırmaya yol açar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnekler:
```python
>>> from transformers import NougatConfig, VisionEncoderDecoderModel
>>> # Initializing a Nougat configuration
>>> config = NougatConfig()
>>> # Initializing a VisionEncoderDecoder model (with random weights) from a Nougat configurations
>>> model = VisionEncoderDecoderModel(config=config)
```
#### from_encoder_decoder_configs[[transformers.NougatConfig.from_encoder_decoder_configs]]
```python
from_encoder_decoder_configs(encoder_config: PreTrainedConfig, decoder_config: PreTrainedConfig, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/configuration_nougat.py#L52)
**Dönüş:** [VisionEncoderDecoderConfig](/docs/transformers/v5.23.0/tr/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig)
Bir yapılandırma nesnesi örneği
Önceden eğitilmiş bir kodlayıcı modeli yapılandırması ve kodlayıcı modeli yapılandırmasından bir [VisionEncoderDecoderConfig](/docs/transformers/v5.23.0/tr/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig) (veya türetilmiş bir sınıf) örnekleyin.
## NougatImageProcessor[[transformers.NougatImageProcessor]]
#### transformers.NougatImageProcessor[[transformers.NougatImageProcessor]]
```python
transformers.NougatImageProcessor(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_nougat.py#L57)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 896, 'width': 672}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `2`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan değeri `[0.485, 0.456, 0.406]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.229, 0.224, 0.225]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
do_crop_margin (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_crop_margin`) : Görsel kenarlarının kırpilip kırpılmayacağı.
do_thumbnail (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_thumbnail`) : Görüntünün thumbnail yöntemiyle yeniden boyutlandırılıp boyutlandırılmayacağını belirtir.
do_align_long_axis (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_align_long_axis`) : Görselin uzun eksenini 90 derece döndürerek `size`'ın uzun eksenine hizalamak için.
NougatImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.NougatImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_nougat.py#L74)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
do_crop_margin (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_crop_margin`) : Görsel kenarlarının kırpilip kırpılmayacağı.
do_thumbnail (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_thumbnail`) : Görüntünün thumbnail yöntemiyle yeniden boyutlandırılıp boyutlandırılmayacağını belirtir.
do_align_long_axis (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_align_long_axis`) : Görselin uzun eksenini 90 derece döndürerek `size`'ın uzun eksenine hizalamak için.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
## NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
#### transformers.NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
```python
transformers.NougatImageProcessorPil(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_pil_nougat.py#L59)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 896, 'width': 672}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `2`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan değeri `[0.485, 0.456, 0.406]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.229, 0.224, 0.225]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
do_crop_margin (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_crop_margin`) : Görsel kenarlarının kırpilip kırpılmayacağı.
do_thumbnail (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_thumbnail`) : Görüntünün thumbnail yöntemiyle yeniden boyutlandırılıp boyutlandırılmayacağını belirtir.
do_align_long_axis (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_align_long_axis`) : Görselin uzun eksenini 90 derece döndürerek `size`'ın uzun eksenine hizalamak için.
NougatImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.NougatImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/image_processing_pil_nougat.py#L76)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
do_crop_margin (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_crop_margin`) : Görsel kenarlarının kırpilip kırpılmayacağı.
do_thumbnail (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_thumbnail`) : Görüntünün thumbnail yöntemiyle yeniden boyutlandırılıp boyutlandırılmayacağını belirtir.
do_align_long_axis (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_align_long_axis`) : Görselin uzun eksenini 90 derece döndürerek `size`'ın uzun eksenine hizalamak için.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
## NougatTokenizer[[transformers.NougatTokenizer]]
#### transformers.NougatTokenizer[[transformers.NougatTokenizer]]
```python
transformers.NougatTokenizer(errors: str = 'replace', unk_token: str = '', bos_token: str = '
', eos_token: str = '', pad_token: str = '', vocab: str | dict | list | None = None, merges: str | list | None = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L347)
**Parametreler:**
vocab_file (`str`, *isteğe bağlı*) : Sözlük dosyasının yolu.
merges_file (`str`, *isteğe bağlı*) : Birleştirme dosyasının yolu.
tokenizer_file (`str`, *isteğe bağlı*) : Tokenizer'ı yüklemek için gereken her şeyi içeren [tokenizers](https://github.com/huggingface/tokenizers) dosyası (genellikle .json uzantısına sahiptir).
clean_up_tokenization_spaces (`str`, *isteğe bağlı*, varsayılan `False`) : Çözümleme sonrası boşlukların temizlenip temizlenmeyeceğini belirtir. Temizleme işlemi, ek boşluklar gibi olası artefaktların kaldırılmasını içerir.
unk_token (`str`, *isteğe bağlı*, varsayılan `""`) : Bilinmeyen token. Sözlükte yer almayan bir token, bir kimliğe dönüştürülemez ve bunun yerine bu token olarak ayarlanır.
bos_token (`str`, *isteğe bağlı*, varsayılan `""`) : Ön eğitim sırasında kullanılan dizinin başlangıç jetonu. Bir dizi sınıflandırıcı jetonu olarak kullanılabilir.
eos_token (`str`, *isteğe bağlı*, varsayılan `""`) : Sıra sonu belirteci.
pad_token (`str`, *isteğe bağlı*, varsayılan `""`) : Dolgu için kullanılan jeton, örneğin farklı uzunluklardaki dizileri toplu işleme (batching) sırasında.
vocab (`str`, `dict` veya `list`, *isteğe bağlı*) : Özel sözlük. Sağlanmazsa, sözlük vocab_file'den yüklenir.
merges (`str` veya `list`, *isteğe bağlı*) : Özel birleştirmeler listesi. Sağlanmazsa, birleştirmeler merges_file'den yüklenir.
Nougat için Tokenizer (HuggingFace tokenizers kütüphanesi tarafından desteklenir).
Bu tokenizer, ana yöntemlerin çoğunu içeren [TokenizersBackend](/docs/transformers/v5.23.0/tr/main_classes/tokenizer#transformers.TokenizersBackend) sınıfından devralır. Kullanıcıların bu yöntemlerle ilgili daha fazla bilgi için bu üst sınıfa başvurması gerekir. Bu sınıf, üretilen metni işleme (postprocessing) için Nougat'a özgü yöntemleri ekler.
#### correct_tables[[transformers.NougatTokenizer.correct_tables]]
```python
correct_tables(generation: str)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L493)
**Parametreler:**
generation (str) : Son işleme tabi tutulacak üretilen metin.
**Dönüş:** `str`
İşlem sonrası metin.
Üretilen bir dizeyi alır ve markdown biçimiyle uyumlu hale getirmek için tabloları/düzenli yapıları düzeltir.
Örnek:
```python
correct_tables("\begin{table} \begin{tabular}{l l} & \ \end{tabular} \end{table}")
"\begin{table}
abular}{l l} & \ \end{tabular}
le}"
```
#### post_process_generation[[transformers.NougatTokenizer.post_process_generation]]
```python
post_process_generation(generation: str | list[str], fix_markdown: bool = True, num_workers: int | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L623)
**Parametreler:**
generation (Union[str, list[str]]) : Üretilen metin veya üretilen metinlerin listesi.
fix_markdown (`bool`, *isteğe bağlı*, varsayılan `True`) : Markdown biçimlendirme düzeltmelerinin uygulanıp uygulanmayacağı.
num_workers (`int`, *isteğe bağlı*) : Çoklu işlemi (birden fazla metni paralel olarak ön işleme) kullanmak için geçirilecek isteğe bağlı işçi sayısı.
**Dönüş:** Union[str, list[str]]
İşlem sonrası metin veya işlem sonrası metinler listesi.
Oluşturulan bir metni veya oluşturulan metinlerin bir listesini son işlemeye tabi tutun.
Bu fonksiyon, üretilen metin üzerinde Markdown biçimlendirmesini düzeltme gibi son işlemler yapmak için kullanılabilir.
Postprocessing oldukça yavaş olduğu için süreci hızlandırmak için multiprocessing kullanılması önerilir.
#### post_process_single[[transformers.NougatTokenizer.post_process_single]]
```python
post_process_single(generation: str, fix_markdown: bool = True)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L528)
**Parametreler:**
generation (str) : Son işleme tabi tutulacak üretilen metin.
fix_markdown (bool, isteğe bağlı) : Markdown biçimlendirme düzeltmelerinin uygulanıp uygulanmayacağını belirtir. Varsayılan değer True'dur.
**Dönüş:** `str`
İşlem sonrası metin.
Tek bir üretilen metni son işlemeye tabi tutar. Burada kullanılan düzenli ifadeler, Nougat makalesinin yazarlarından doğrudan alınmıştır. Bu ifadeler açıklık için yorumlanmıştır ve çoğu durumda uçtan uca test edilmiştir.
#### remove_hallucinated_references[[transformers.NougatTokenizer.remove_hallucinated_references]]
```python
remove_hallucinated_references(text: str)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/tokenization_nougat.py#L463)
**Parametreler:**
text (`str`) : Referanslar içeren girdi metni.
**Dönüş:** `str`
Halüsinasyonlu referanslar kaldırılmış metin.
Metinden uydurma veya eksik referansları kaldırın.
Bu işlev, girdi metnindeki eksik veya halüsinasyon olarak işaretlenmiş referansları tespit eder ve kaldırır.
## NougatProcessor[[transformers.NougatProcessor]]
#### transformers.NougatProcessor[[transformers.NougatProcessor]]
```python
transformers.NougatProcessor(image_processor, tokenizer)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L24)
**Parametreler:**
image_processor (`NougatImageProcessor`) : Görüntü işleyici zorunlu bir girdidir.
tokenizer (`NougatTokenizer`) : Tokenizer zorunlu bir girdidir.
Bir görüntü işleyiciyi ve bir belirteç oluşturucuyu tek bir işleyicide birleştiren bir NougatProcessor oluşturur.
[NougatProcessor](/docs/transformers/v5.23.0/tr/model_doc/nougat#transformers.NougatProcessor), [NougatImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/nougat#transformers.NougatImageProcessor) ve [NougatTokenizer](/docs/transformers/v5.23.0/tr/model_doc/nougat#transformers.NougatTokenizer) sınıflarının tüm işlevlerini sunar. Daha fazla bilgi için [~NougatImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/nougat#transformers.NougatImageProcessor) ve [~NougatTokenizer](/docs/transformers/v5.23.0/tr/model_doc/nougat#transformers.NougatTokenizer) belgelerini inceleyin.
#### __call__[[transformers.NougatProcessor.__call__]]
```python
__call__(images = None, text = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L32)
**Parametreler:**
images (``) : Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, set `do_rescale=False
text (``) : The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, set `is_split_into_words=True` to avoid ambiguity with batched inputs.
return_tensors (`str` veya [TensorType](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.TensorType), *opsiyonel*) : Ayarlanırsa, belirli bir çerçeveye ait tensörleri döndürür. Kabul edilen değerler: - `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür. - `'np'`: NumPy `np.ndarray` nesnelerini döndürür.
#### from_pretrained[[transformers.NougatProcessor.from_pretrained]]
```python
from_pretrained(pretrained_model_name_or_path: str | os.PathLike, cache_dir: str | os.PathLike | None = None, force_download: bool = False, local_files_only: bool = False, token: str | bool | None = None, revision: str = 'main', **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L1799)
**Parametreler:**
pretrained_model_name_or_path (`str` veya `os.PathLike`) : Şu seçeneklerden biri olabilir: - huggingface.co üzerindeki bir model deposunda barındırılan önceden eğitilmiş bir feature_extractor'ın *model kimliği* olan bir dize. - [save_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) yöntemiyle kaydedilmiş bir feature extractor dosyası içeren bir *dizin*in yolu, örneğin `./my_model_directory/`. - Kaydedilmiş bir feature extractor JSON *dosyası*nın yolu, örneğin `./my_model_directory/preprocessor_config.json`.
- ****kwargs** : Hem [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) hem de `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained` ile birlikte iletilen ek anahtar kelime argümanları.
Önceden eğitilmiş bir modelle ilişkili bir işlemci örnekleyin.
Bu sınıf metodu, yalnızca özellik çıkarıcının [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained), görüntü işleyicinin [ImageProcessingMixin](/docs/transformers/v5.23.0/tr/internal/image_processing_utils#transformers.ImageProcessingMixin) ve belirteçleyicinin `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained` metotlarını çağırır. Daha fazla bilgi için yukarıdaki metotların dokümantasyon dizelerine (docstring) başvurun.
#### save_pretrained[[transformers.NougatProcessor.save_pretrained]]
```python
save_pretrained(save_directory, push_to_hub: bool = False, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L1182)
**Parametreler:**
save_directory (`str` veya `os.PathLike`) : Özellik çıkarıcısının JSON dosyasının ve tokenizer dosyalarının kaydedileceği dizin (dizin mevcut değilse oluşturulur).
push_to_hub (`bool`, *isteğe bağlı*, varsayılan `False`) : Modeli kaydettikten sonra Hugging Face model hub'ına gönderip göndermeyeceğinizi belirtir. Göndermek istediğiniz depoyu `repo_id` ile belirleyebilirsiniz (varsayılan olarak ad alanınızdaki `save_directory` adı kullanılır).
kwargs (`dict[str, Any]`, *isteğe bağlı*) : [push_to_hub()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.utils.PushToHubMixin.push_to_hub) yöntemine iletilen ek anahtar kelime argümanları.
Bu işleyicinin (özellik çıkarıcı, belirteçleştirici...) özniteliklerini, [from_pretrained()](/docs/transformers/v5.23.0/tr/model_doc/wav2vec2#transformers.Wav2Vec2Processor.from_pretrained) yöntemiyle yeniden yüklenebilmesi için belirtilen dizinde kaydeder.
Bu sınıf metodu yalnızca [save_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) ve [save_pretrained()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.save_pretrained) çağrılarını yapar. Daha fazla bilgi için yukarıdaki metodların dokümantasyon dizelerine (docstring) başvurun.
#### batch_decode[[transformers.NougatProcessor.batch_decode]]
```python
batch_decode(*args, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L2054)
Bu yöntem, tüm argümanlarını PreTrainedTokenizer'ın [batch_decode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.batch_decode) yöntemine iletir. Daha fazla bilgi için bu yöntemin docstring'ine başvurun.
#### decode[[transformers.NougatProcessor.decode]]
```python
decode(*args, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L2063)
Bu yöntem, tüm argümanlarını PreTrainedTokenizer'ın [decode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.decode) yöntemine iletir. Daha fazla bilgi için bu yöntemin docstring'ine başvurun.
#### post_process_generation[[transformers.NougatProcessor.post_process_generation]]
```python
post_process_generation(*args, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/nougat/processing_nougat.py#L40)
Bu yöntem, tüm argümanlarını NougatTokenizer'ın `~PreTrainedTokenizer.post_process_generation` metoduna iletir. Daha fazla bilgi için bu metodun docstring'ine başvurun.