# BridgeTower
## Genel Bakış
BridgeTower modeli, Xiao Xu, Chenfei Wu, Shachar Rosenman, Vasudev Lal, Wanxiang Che ve Nan Duan tarafından [BridgeTower: Building Bridges Between Encoders in Vision-Language Representative Learning](https://huggingface.co/papers/2206.08657) makalesinde önerilmiştir. Bu modelin amacı, her tek modlu kodlayıcı ile çapraz modlu kodlayıcı arasında bir köprü kurarak, çapraz modlu kodlayıcının her katmanında kapsamlı ve ayrıntılı etkileşimi mümkün kılmak ve böylece neredeyse ihmal edilebilir ek performans ve hesaplama maliyetleriyle çeşitli aşağı akış görevlerinde olağanüstü performans elde etmektir.
Bu makale [AAAI'23](https://aaai.org/Conferences/AAAI-23/) konferansında kabul edilmiştir.
Makalenin özeti aşağıdaki gibidir:
*TWO-TOWER mimarisine sahip Görsel-Dil (VL) modelleri, son yıllarda görsel-dil temsil öğrenmesinde baskın bir rol üstlenmiştir. Mevcut VL modelleri, ya hafif tek modlu kodlayıcılar kullanarak derin çapraz modlu kodlayıcıda her iki modu eş zamanlı olarak çıkarmayı, hizalamayı ve birleştirmeyi öğrenir; ya da derin önceden eğitilmiş tek modlu kodlayıcılardan gelen son katman tek modlu temsil çapraz modlu üst kodlayıcıya aktarılır. Her iki yaklaşım da görsel-dil temsil öğrenmesini potansiyel olarak kısıtlar ve model performansını sınırlar. Bu makalede, BRIDGETOWER'ı öneriyoruz; bu model, tek modlu kodlayıcıların üst katmanları ile çapraz modlu kodlayıcının her katmanı arasında bağlantı kuran çoklu köprü katmanları tanıtır. Bu, önceden eğitilmiş tek modlu kodlayıcıların farklı semantik seviyelerindeki görsel ve metinsel temsil çapraz modlu kodlayıcıda etkili bir alttan üste çapraz modlu hizalama ve birleşmesine olanak tanır. Sadece 4M görselle önceden eğitilen BRIDGETOWER, çeşitli aşağı akış görsel-dil görevlerinde en iyi performansı (state-of-the-art) elde eder. Özellikle VQAv2 test-std kümesinde, BRIDGETOWER %78,73 doğruluk oranına ulaşarak, aynı önceden eğitim verisiyle ve neredeyse ihmal edilebilir ek parametre ve hesaplama maliyetleriyle önceki en iyi model olan METER'ı %1,09 geride bırakır. Belirgin bir şekilde, model daha da ölçeklendirildiğinde, BRIDGETOWER %81,15 doğruluk oranına ulaşarak, büyüklük sırası daha büyük veri kümeleriyle önceden eğitilmiş modelleri geride bırakır.*
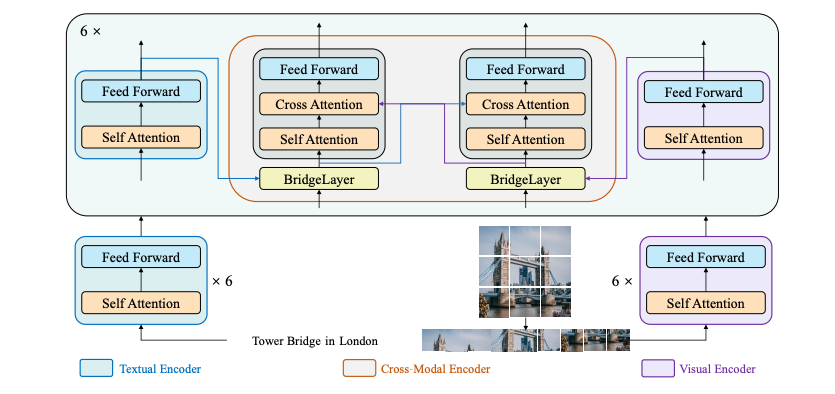 BridgeTower mimarisi. Orijinal makaleden alınmıştır.
Bu model [Anahita Bhiwandiwalla](https://huggingface.co/anahita-b), [Tiep Le](https://huggingface.co/Tile) ve [Shaoyen Tseng](https://huggingface.co/shaoyent) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/microsoft/BridgeTower) bulunabilir.
## Kullanım ipuçları ve örnekleri
BridgeTower, çok sayıda hafif köprü katmanına sahip bir görsel kodlayıcı, bir metinsel kodlayıcı ve bir çapraz modallı kodlayıcıdan oluşur. Bu yaklaşımın amacı, çapraz modallı kodlayıcının her katmanında kapsamlı ve ayrıntılı etkileşimi mümkün kılmak için her tek modallı kodlayıcı ile çapraz modallı kodlayıcı arasında bir köprü oluşturmaktı. İlke olarak, önerilen mimaride herhangi bir görsel, metinsel veya çapraz modallı kodlayıcı uygulanabilir.
[BridgeTowerProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerProcessor), metni kodlamak ve sırasıyla görüntüleri hazırlamak için [RobertaTokenizer](/docs/transformers/v5.23.0/tr/model_doc/led#transformers.RobertaTokenizer) ve [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) bileşenlerini tek bir örnekte birleştirir.
Aşağıdaki örnek, [BridgeTowerProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerProcessor) ve [BridgeTowerForContrastiveLearning](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerForContrastiveLearning) kullanarak kontrastif öğrenmenin nasıl çalıştırıldığını gösterir.
```python
import requests
from PIL import Image
from transformers import BridgeTowerForContrastiveLearning, BridgeTowerProcessor
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
model = BridgeTowerForContrastiveLearning.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc", device_map="auto")
# forward pass
scores = dict()
for text in texts:
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
outputs = model(**encoding)
scores[text] = outputs
```
Aşağıdaki örnek, [BridgeTowerProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerProcessor) ve [BridgeTowerForImageAndTextRetrieval](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerForImageAndTextRetrieval) kullanarak görüntü-metin eşleme (retrieval) çalıştırmanın nasıl yapılacağını gösterir.
```python
import requests
from PIL import Image
from transformers import BridgeTowerForImageAndTextRetrieval, BridgeTowerProcessor
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm", device_map="auto")
# forward pass
scores = dict()
for text in texts:
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
outputs = model(**encoding)
scores[text] = outputs.logits[0, 1].item()
```
Aşağıdaki örnek, [BridgeTowerProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerProcessor) ve [BridgeTowerForMaskedLM](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerForMaskedLM) kullanarak maskeli dil modellemesinin nasıl çalıştırılacağını gösterir.
```python
from transformers import BridgeTowerProcessor, BridgeTowerForMaskedLM
from PIL import Image
import requests
url = "http://images.cocodataset.org/val2017/000000360943.jpg"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
text = "a looking out of the window"
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForMaskedLM.from_pretrained("BridgeTower/bridgetower-base-itm-mlm", device_map="auto")
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
# forward pass
outputs = model(**encoding)
results = processor.decode(outputs.logits.argmax(dim=-1).squeeze(0).tolist())
print(results)
.a cat looking out of the window.
```
İpuçları:
- Bu BridgeTower uygulaması, metin gömlemlerini üretmek için [RobertaTokenizer](/docs/transformers/v5.23.0/tr/model_doc/led#transformers.RobertaTokenizer) ve görsel gömlemleri hesaplamak için OpenAI'ın CLIP/ViT modelini kullanır.
- Önceden eğitilmiş [bridgeTower-base](https://huggingface.co/BridgeTower/bridgetower-base) ve [bridgetower masked language modeling and image text matching](https://huggingface.co/BridgeTower/bridgetower-base-itm-mlm) için kontrol noktaları yayınlandı.
- BridgeTower'ın Görsel Geri Getirme ve diğer aşağı akış görevlerindeki performansına ilişkin olarak [Tablo 5](https://huggingface.co/papers/2206.08657)'e bakın.
## BridgeTowerConfig[[transformers.BridgeTowerConfig]]
#### transformers.BridgeTowerConfig[[transformers.BridgeTowerConfig]]
```python
transformers.BridgeTowerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, share_cross_modal_transformer_layers: bool = True, hidden_act: str = 'gelu', hidden_size: int = 768, initializer_factor: float | int = 1, layer_norm_eps: float = 1e-05, share_link_tower_layers: bool = False, link_tower_type: str = 'add', num_attention_heads: int = 12, num_hidden_layers: int = 6, tie_word_embeddings: bool = False, init_layernorm_from_vision_encoder: bool = False, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/configuration_bridgetower.py#L104)
**Parametreler:**
share_cross_modal_transformer_layers (`bool`, *isteğe bağlı*, varsayılan `True`) : Çapraz modal dönüştürücü katmanlarının paylaşılıp paylaşılmadığı.
hidden_act (`str`, *isteğe bağlı*, varsayılan `gelu`) : Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
hidden_size (`int`, *isteğe bağlı*, varsayılan `768`) : Gizli temsillerin boyutu.
initializer_factor (`Union[float, int]`, *isteğe bağlı*, varsayılan `1`) : Tüm ağırlık matrislerini başlatmak için kullanılan bir çarpan (başlatma testleri için dahili olarak kullanılır, 1 olarak tutulmalıdır).
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-05`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
share_link_tower_layers (`bool`, *isteğe bağlı*, varsayılan `False`) : Köprü/bağ kulesi katmanlarının paylaşılıp paylaşılmadığı.
link_tower_type (`str`, *isteğe bağlı*, varsayılan `"add"`) : Köprü/bağlantı katmanı türü.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `6`) : Transformer decoder'ındaki gizli katman sayısı.
tie_word_embeddings (`bool`, *isteğe bağlı*, varsayılan `False`) : Ağırlık gömme bağlamalarının, modelin `tied_weights_keys` eşlemesine göre yapılıp yapılmayacağını belirtir.
init_layernorm_from_vision_encoder (`bool`, *isteğe bağlı*, varsayılan `False`) : LayerNorm'ün görme kodlayıcıdan başlatılıp başlatılmayacağı.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Metin omurgasının yapılandırma nesnesi veya sözlüğü.
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Görüntü iskeletinin yapılandırma nesnesi veya sözlüğü.
Bu, bir BridgeTowerModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Bridgetower modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılanlarla bir yapılandırma örneği oluşturmak, [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base) ile benzer bir yapılandırmaya yol açar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import BridgeTowerModel, BridgeTowerConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration
>>> configuration = BridgeTowerConfig()
>>> # Initializing a model from the BridgeTower/bridgetower-base style configuration
>>> model = BridgeTowerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## BridgeTowerTextConfig[[transformers.BridgeTowerTextConfig]]
#### transformers.BridgeTowerTextConfig[[transformers.BridgeTowerTextConfig]]
```python
transformers.BridgeTowerTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 50265, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, initializer_factor: float | int = 1, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 514, type_vocab_size: int = 1, layer_norm_eps: float = 1e-05, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, use_cache: bool = True, is_decoder: bool = False, add_cross_attention: bool = False)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/configuration_bridgetower.py#L65)
**Parametreler:**
vocab_size (`int`, *isteğe bağlı*, varsayılan `50265`) : Modelin sözlük boyutu. `input_ids` tarafından temsil edilebilecek farklı token sayısını tanımlar.
hidden_size (`int`, *isteğe bağlı*, varsayılan `768`) : Gizli temsillerin boyutu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki gizli katman sayısı.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
initializer_factor (`Union[float, int]`, *isteğe bağlı*, varsayılan `1`) : Tüm ağırlık matrislerini başlatmak için kullanılan bir çarpan (başlatma testleri için dahili olarak kullanılır, 1 olarak tutulmalıdır).
intermediate_size (`int`, *isteğe bağlı*, varsayılan `3072`) : MLP temsil boyutu.
hidden_act (`str`, *isteğe bağlı*, varsayılan `gelu`) : Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
hidden_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.1`) : Gömme, kodlayıcı ve havuzlayıcıdaki tüm tam bağlı katmanlar için dropout olasılığı.
attention_probs_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.1`) : Dikkat olasılıkları için dropout oranı.
max_position_embeddings (`int`, *isteğe bağlı*, varsayılan `514`) : Bu modelin kullanılabileceği en büyük dizi uzunluğu.
type_vocab_size (`int`, *isteğe bağlı*, varsayılan `1`) : `token_type_ids` için sözlük boyutu.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-05`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
pad_token_id (`int`, *isteğe bağlı*, varsayılan `1`) : Sözlükte dolgu için kullanılan token kimliği.
bos_token_id (`int`, *isteğe bağlı*, varsayılan `0`) : Sözlükte akış başlangıcı için kullanılan token kimliği.
eos_token_id (`Union[int, list[int]]`, *isteğe bağlı*, varsayılan `2`) : Sözlükte akış sonu için kullanılan token kimliği.
use_cache (`bool`, *isteğe bağlı*, varsayılan `True`) : Modelin son anahtar/değer dikkatlerini döndürüp döndürmeyeceğini belirtir (tüm modellerde kullanılmaz). Yalnızca `config.is_decoder=True` olduğunda veya model yalnızca çözücü tabanlı üretken bir model olduğunda geçerlidir.
is_decoder (`bool`, *isteğe bağlı*, varsayılan `False`) : Modelin bir çözücü olarak kullanılıp kullanılmadığı. `False` ise model, bir kodlayıcı olarak kullanılır.
add_cross_attention (`bool`, *isteğe bağlı*, varsayılan `False`) : Modelde çapraz dikkat katmanlarının eklenip eklenmeyeceğini belirtir.
Bu, bir BridgeTowerModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Bridgetower modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılanlarla bir yapılandırma örneği oluşturmak, [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base) ile benzer bir yapılandırmaya yol açar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import BridgeTowerTextConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration for the text model
>>> configuration = BridgeTowerTextConfig()
>>> # Accessing the configuration
>>> configuration
```
## BridgeTowerVisionConfig[[transformers.BridgeTowerVisionConfig]]
#### transformers.BridgeTowerVisionConfig[[transformers.BridgeTowerVisionConfig]]
```python
transformers.BridgeTowerVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_channels: int = 3, patch_size: int | list[int] | tuple[int, int] = 16, image_size: int | list[int] | tuple[int, int] = 288, initializer_factor: float | int = 1, layer_norm_eps: float = 1e-05, stop_gradient: bool = False, share_layernorm: bool = True, remove_last_layer: bool = False)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/configuration_bridgetower.py#L27)
**Parametreler:**
hidden_size (`int`, *isteğe bağlı*, varsayılan `768`) : Gizli temsillerin boyutu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki gizli katman sayısı.
num_channels (`int`, *opsiyonel*, varsayılan `3`) : Girdi kanal sayısı.
patch_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `16`) : Her yamanın boyutu (çözünürlüğü).
image_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `288`) : Her bir görüntünün boyutu (çözünürlüğü).
initializer_factor (`Union[float, int]`, *isteğe bağlı*, varsayılan `1`) : Tüm ağırlık matrislerini başlatmak için kullanılan bir çarpan (başlatma testleri için dahili olarak kullanılır, 1 olarak tutulmalıdır).
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-05`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
stop_gradient (`bool`, *isteğe bağlı*, varsayılan `False`) : Eğitim için gradyanı durdurulacak mı.
share_layernorm (`bool`, *isteğe bağlı*, varsayılan `True`) : LayerNorm katmanlarının paylaşılıp paylaşılmadığı.
remove_last_layer (`bool`, *isteğe bağlı*, varsayılan `False`) : Görüntü kodlayıcıdan son katmanın kaldırılıp kaldırılmayacağını belirtir.
Bu, bir BridgeTowerModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Bridgetower modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılanlarla bir yapılandırma örneği oluşturmak, [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base) ile benzer bir yapılandırmaya yol açar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import BridgeTowerVisionConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration for the vision model
>>> configuration = BridgeTowerVisionConfig()
>>> # Accessing the configuration
>>> configuration
```
## BridgeTowerImageProcessor[[transformers.BridgeTowerImageProcessor]]
#### transformers.BridgeTowerImageProcessor[[transformers.BridgeTowerImageProcessor]]
```python
transformers.BridgeTowerImageProcessor(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/image_processing_bridgetower.py#L76)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'shortest_edge' : 288}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'shortest_edge' : 288}`): `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `3`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.48145466, 0.4578275, 0.40821073]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.26862954, 0.26130258, 0.27577711]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
size_divisor (`int`, *kwargs*, varsayılan `32`) : Yükseklik ve genişliğin bu sayıya bölünebilir olmasını sağlamak için kullanılan boyut.
Bir BridgeTowerImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.BridgeTowerImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
image_like_kwargs (`dict[str, Any]`, *isteğe bağlı*) : Ek görüntü benzeri girdiler için geliştirici bayrağı; bu girdiler de ön işleme tabi tutulacaktır. Girdileri kwarg olarak geçirmenin çalışmadığı durumlarda kullanın. Örneğin, `preprocess(images, masks=masks)` tercih edilen seçenektir ancak bazı modellerde argüman öncelik sorunlarına yol açar. Bu durumlarda bunun yerine `preprocess(images, image_like_inputs={"masks": masks})` kullanılabilir.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
Bir görüntüyü veya bir görüntü grubunu ön işleme tabi tutun.
## BridgeTowerImageProcessorPil[[transformers.BridgeTowerImageProcessorPil]]
#### transformers.BridgeTowerImageProcessorPil[[transformers.BridgeTowerImageProcessorPil]]
```python
transformers.BridgeTowerImageProcessorPil(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/image_processing_pil_bridgetower.py#L70)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'shortest_edge' : 288}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'shortest_edge' : 288}`): `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `3`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.48145466, 0.4578275, 0.40821073]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.26862954, 0.26130258, 0.27577711]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
size_divisor (`int`, *kwargs*, varsayılan `32`) : Yükseklik ve genişliğin bu sayıya bölünebilir olmasını sağlamak için kullanılan boyut.
Bir BridgeTowerImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.BridgeTowerImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
image_like_kwargs (`dict[str, Any]`, *isteğe bağlı*) : Ek görüntü benzeri girdiler için geliştirici bayrağı; bu girdiler de ön işleme tabi tutulacaktır. Girdileri kwarg olarak geçirmenin çalışmadığı durumlarda kullanın. Örneğin, `preprocess(images, masks=masks)` tercih edilen seçenektir ancak bazı modellerde argüman öncelik sorunlarına yol açar. Bu durumlarda bunun yerine `preprocess(images, image_like_inputs={"masks": masks})` kullanılabilir.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
Bir görüntüyü veya bir görüntü grubunu ön işleme tabi tutun.
## BridgeTowerProcessor[[transformers.BridgeTowerProcessor]]
#### transformers.BridgeTowerProcessor[[transformers.BridgeTowerProcessor]]
```python
transformers.BridgeTowerProcessor(image_processor, tokenizer)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/processing_bridgetower.py#L24)
**Parametreler:**
image_processor (`BridgeTowerImageProcessor`) : Görüntü işleyici zorunlu bir girdidir.
tokenizer (`RobertaTokenizer`) : Tokenizer zorunlu bir girdidir.
Bir görüntü işleyiciyi ve bir belirteç oluşturucuyu tek bir işleyicide birleştiren bir BridgeTowerProcessor oluşturur.
[BridgeTowerProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerProcessor), [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) ve [RobertaTokenizer](/docs/transformers/v5.23.0/tr/model_doc/led#transformers.RobertaTokenizer) işlevlerinin tümünü sunar. Daha fazla bilgi için [~BridgeTowerImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) ve [~RobertaTokenizer](/docs/transformers/v5.23.0/tr/model_doc/led#transformers.RobertaTokenizer) belgelerine bakın.
#### __call__[[transformers.BridgeTowerProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L670)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *isteğe bağlı*) : Ön işleme tabi tutulacak görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
text (`Union[str, list[str], list[list[str]]]`, *isteğe bağlı*) : Kodlanacak dizi veya dizi topluluğu. Her dizi bir metin veya metin listesi (önceden tokenize edilmiş metin) olabilir. Önceden tokenize edilmiş bir girdi geçirirseniz, toplu girdilerle karışıklığı önlemek için `is_split_into_words=True` değerini ayarlayın.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *isteğe bağlı*) : Ön işleme tabi tutulacak video. Piksel değerleri 0 ile 255 arasında değişen tek bir video veya video grubu beklenir. Piksel değerleri 0 ile 1 arasında olan videoları geçiriyorsanız, `do_rescale=False` olarak ayarlayın.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *isteğe bağlı*) : Hazırlanacak ses veya sesler grubu. Her ses, bir NumPy dizisi veya PyTorch tensörü olabilir. NumPy dizisi/PyTorch tensörü durumunda, her sesin şekli (C, T) olmalıdır; burada C kanal sayısı, T ise sesin örnek uzunluğudur.
return_mm_token_type_ids (`bool`, *kwargs*) : Çok modlu yer tutucu token konumlarını gösteren çok modlu token türü kimliklerini döndürüp döndürmeyeceğini belirtir.
return_text_replacement_offsets (`bool`, *kwargs*) : Her çok modlu yer tutucu ve ikamesi için karakter ofsetlerinin döndürülüp döndürülmemesi.
return_tensors (`str` veya [TensorType](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.TensorType), *opsiyonel*) : Ayarlanırsa, belirli bir çerçeveye ait tensörleri döndürür. Kabul edilen değerler: - `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür. - `'np'`: NumPy `np.ndarray` nesnelerini döndürür.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/tr/main_classes/processors#transformers.ProcessingKwargs), *opsiyonel*) : Her modalite (metin, görüntüler, videolar, ses) için ek işleme seçenekleri. Modelle ilgili parametreler yukarıda listelenmiştir; desteklenen argümanların tam listesi için TypedDict sınıfına bakın.
## BridgeTowerModel[[transformers.BridgeTowerModel]]
#### transformers.BridgeTowerModel[[transformers.BridgeTowerModel]]
```python
transformers.BridgeTowerModel(config: BridgeTowerConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1079)
**Parametreler:**
config ([BridgeTowerConfig](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Herhangi bir özel başlık olmadan BridgeTowerModelOutput nesnesi üreten çıplak BridgeTower Model dönüştürücüsü
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.BridgeTowerModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, image_token_type_idx: int | None = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1152)
**Parametreler:**
input_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi belirteçlerinin (token) indeksleri. Varsayılan olarak dolgu (padding) yoksayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi kimlikları (input IDs) nedir?](../glossary#input-ids)
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdilerin ilk ve ikinci bölümlerini belirtmek için segment token dizinleri. Dizinler `[0, 1]` aralığından seçilir: - 0, *sentence A* token'ına karşılık gelir, - 1, *sentence B* token'ına karşılık gelir. [Token type ID'leri nelerdir?](../glossary#token-type-ids)
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [BridgeTowerImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([BridgeTowerProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerProcessor), görüntü işleme için [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) kullanır).
pixel_mask (`torch.LongTensor`, şekli `(batch_size, height, width)`, *isteğe bağlı*) : Dolgu piksel değerleri üzerinde dikkat işleminin uygulanmasını önlemek için maske. `[0, 1]` aralığında seçilen maske değerleri: - Gerçek (yani **maskelenmemiş**) pikseller için 1, - Dolgu (yani **maskelenmiş**) pikseller için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : `input_ids` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `input_ids` indekslerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisine kıyasla daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
image_embeds (`torch.Tensor`, şekli `(batch_size, num_patches, hidden_size)`, *isteğe bağlı*) : `pixel_values` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `pixel_values`'in yama gömülülerine (patch embeddings) nasıl dönüştürüleceği üzerinde daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
image_token_type_idx (`int`, *isteğe bağlı*) : - Görseller için token türü kimlikleri.
labels (`torch.LongTensor`, şekli `(batch_size,)`, *isteğe bağlı*) : Etiketler şu anda desteklenmiyor.
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
**Dönüş:** `BridgeTowerModelOutput` veya `tuple(torch.Tensor)`
A `BridgeTowerModelOutput` veya bir `torch.Tensor` tuple'ı (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda), yapılandırmaya ([BridgeTowerConfig](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[BridgeTowerModel](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **text_features** (`torch.Tensor`, şekli `(batch_size, text_sequence_length, hidden_size)`) -- Modelin son katmanının metin çıktısındaki gizli durumlar dizisi.
- **image_features** (`torch.Tensor`, şekli `(batch_size, image_sequence_length, hidden_size)`) -- Modelin son katmanının görüntü çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size x 2)`) -- Metin ve görüntü dizilerinin ilk token'larının (sınıflandırma token'ı) son katman gizli durumlarının, yardımcı ön eğitim görevleri için kullanılan katmanlardan ek işlemden geçirildikten sonra birleştirilmesi.
- **hidden_states** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren ve `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `(batch_size, num_heads, sequence_length, sequence_length)` biçiminde, her katman için bir adet içeren `torch.Tensor` demeti.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> # prepare image and text
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "hello world"
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base")
>>> model = BridgeTowerModel.from_pretrained("BridgeTower/bridgetower-base")
>>> inputs = processor(image, text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> outputs.keys()
odict_keys(['text_features', 'image_features', 'pooler_output'])
```
## BridgeTowerForContrastiveLearning[[transformers.BridgeTowerForContrastiveLearning]]
#### transformers.BridgeTowerForContrastiveLearning[[transformers.BridgeTowerForContrastiveLearning]]
```python
transformers.BridgeTowerForContrastiveLearning(config: BridgeTowerConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1603)
**Parametreler:**
config ([BridgeTowerConfig](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üzerinde görüntü-metin karşıtlık kaybı hesaplayan bir görüntü-metin karşıtlık başlığı bulunan BridgeTower Model.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.BridgeTowerForContrastiveLearning.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, return_loss: bool | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1617)
**Parametreler:**
input_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi belirteçlerinin (token) indeksleri. Varsayılan olarak dolgu (padding) yoksayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi kimlikları (input IDs) nedir?](../glossary#input-ids)
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdilerin ilk ve ikinci bölümlerini belirtmek için segment token dizinleri. Dizinler `[0, 1]` aralığından seçilir: - 0, *sentence A* token'ına karşılık gelir, - 1, *sentence B* token'ına karşılık gelir. [Token type ID'leri nelerdir?](../glossary#token-type-ids)
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [BridgeTowerImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([BridgeTowerProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerProcessor), görüntü işleme için [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) kullanır).
pixel_mask (`torch.LongTensor`, şekli `(batch_size, height, width)`, *isteğe bağlı*) : Dolgu piksel değerleri üzerinde dikkat işleminin uygulanmasını önlemek için maske. `[0, 1]` aralığında seçilen maske değerleri: - Gerçek (yani **maskelenmemiş**) pikseller için 1, - Dolgu (yani **maskelenmiş**) pikseller için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : `input_ids` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `input_ids` indekslerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisine kıyasla daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
image_embeds (`torch.Tensor`, şekli `(batch_size, num_patches, hidden_size)`, *isteğe bağlı*) : `pixel_values` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `pixel_values`'in yama gömülülerine (patch embeddings) nasıl dönüştürüleceği üzerinde daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
return_loss (`bool`, *isteğe bağlı*) : Karşıtlık kaybının (contrastive loss) döndürülüp döndürülmeyeceği.
**Dönüş:** `BridgeTowerContrastiveOutput` veya `tuple(torch.Tensor)`
`BridgeTowerContrastiveOutput` veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([BridgeTowerConfig](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[BridgeTowerForContrastiveLearning](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerForContrastiveLearning) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *opsiyonel*, `return_loss` `True` olduğunda döndürülür) -- Görsel-metin kontrastif kaybı.
- **logits** (`torch.Tensor`, şekli `(batch_size, sequence_length, config.vocab_size)`) -- Dil modelleme başlığının tahmin puanları (SoftMax öncesi her sözlük jetonu için puanlar).
- **text_embeds** (`torch.Tensor)`, *optional*, returned when model is initialized with `with_projection=True`) -- The text embeddings obtained by applying the projection layer to the pooler_output.
- **image_embeds** (`torch.Tensor)`, *optional*, returned when model is initialized with `with_projection=True`) -- The image embeddings obtained by applying the projection layer to the pooler_output.
- **cross_embeds** (`torch.Tensor)`, *optional*, returned when model is initialized with `with_projection=True`) -- The text-image cross-modal embeddings obtained by applying the projection layer to the pooler_output.
- **hidden_states** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren ve `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Örnekler:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForContrastiveLearning
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> image_urls = [
... "https://farm4.staticflickr.com/3395/3428278415_81c3e27f15_z.jpg",
... "http://images.cocodataset.org/val2017/000000039769.jpg",
... ]
>>> texts = ["two dogs in a car", "two cats sleeping on a couch"]
>>> with httpx.stream("GET", urls[0]) as response:
... image1 = Image.open(BytesIO(response.read()))
>>> with httpx.stream("GET", urls[1]) as response:
... image2 = Image.open(BytesIO(response.read()))
>>> images = [image1, image2]
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
>>> model = BridgeTowerForContrastiveLearning.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
>>> inputs = processor(images, texts, padding=True, return_tensors="pt")
>>> loss = model(**inputs, return_loss=True).loss
>>> inputs = processor(images, texts[::-1], padding=True, return_tensors="pt")
>>> loss_swapped = model(**inputs, return_loss=True).loss
>>> print("Loss", round(loss.item(), 4))
Loss 0.0019
>>> print("Loss with swapped images", round(loss_swapped.item(), 4))
Loss with swapped images 2.126
```
## BridgeTowerForMaskedLM[[transformers.BridgeTowerForMaskedLM]]
#### transformers.BridgeTowerForMaskedLM[[transformers.BridgeTowerForMaskedLM]]
```python
transformers.BridgeTowerForMaskedLM(config: BridgeTowerConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1404)
**Parametreler:**
config ([BridgeTowerConfig](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Ön eğitim sırasında yapıldığı gibi, üstünde bir dil modelleme kafası bulunan BridgeTower Model.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.BridgeTowerForMaskedLM.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1422)
**Parametreler:**
input_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi belirteçlerinin (token) indeksleri. Varsayılan olarak dolgu (padding) yoksayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi kimlikları (input IDs) nedir?](../glossary#input-ids)
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdilerin ilk ve ikinci bölümlerini belirtmek için segment token dizinleri. Dizinler `[0, 1]` aralığından seçilir: - 0, *sentence A* token'ına karşılık gelir, - 1, *sentence B* token'ına karşılık gelir. [Token type ID'leri nelerdir?](../glossary#token-type-ids)
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [BridgeTowerImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([BridgeTowerProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerProcessor), görüntü işleme için [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) kullanır).
pixel_mask (`torch.LongTensor`, şekli `(batch_size, height, width)`, *isteğe bağlı*) : Dolgu piksel değerleri üzerinde dikkat işleminin uygulanmasını önlemek için maske. `[0, 1]` aralığında seçilen maske değerleri: - Gerçek (yani **maskelenmemiş**) pikseller için 1, - Dolgu (yani **maskelenmiş**) pikseller için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : `input_ids` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `input_ids` indekslerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisine kıyasla daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
image_embeds (`torch.Tensor`, şekli `(batch_size, num_patches, hidden_size)`, *isteğe bağlı*) : `pixel_values` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `pixel_values`'in yama gömülülerine (patch embeddings) nasıl dönüştürüleceği üzerinde daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
labels (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Maskeli dil modelleme kaybını hesaplamak için etiketler. Endeksler `[-100, 0, ..., config.vocab_size]` aralığında olmalıdır (bkz. `input_ids` docstring). Endeksleri `-100` olarak ayarlanan tokenlar yok sayılır (maskelenir), kayıp yalnızca etiketleri `[0, ..., config.vocab_size]` aralığında olan tokenlar için hesaplanır.
**Dönüş:** [MaskedLMOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) veya `tuple(torch.Tensor)`
[MaskedLMOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([BridgeTowerConfig](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[BridgeTowerForMaskedLM](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerForMaskedLM) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür) -- Maskeli dil modelleme (MLM) kaybı.
- **logits** (`torch.Tensor`, şekli `(batch_size, sequence_length, config.vocab_size)`) -- Dil modelleme başlığının tahmin puanları (SoftMax öncesi her sözlük jetonu için puanlar).
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForMaskedLM
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000360943.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> text = "a looking out of the window"
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> model = BridgeTowerForMaskedLM.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**encoding)
>>> results = processor.decode(outputs.logits.argmax(dim=-1).squeeze(0).tolist())
>>> print(results)
.a cat looking out of the window.
```
## BridgeTowerForImageAndTextRetrieval[[transformers.BridgeTowerForImageAndTextRetrieval]]
#### transformers.BridgeTowerForImageAndTextRetrieval[[transformers.BridgeTowerForImageAndTextRetrieval]]
```python
transformers.BridgeTowerForImageAndTextRetrieval(config: BridgeTowerConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1501)
**Parametreler:**
config ([BridgeTowerConfig](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üzerinde bir sınıflandırıcı başlığı (CLS token'ının son gizli durumunun üzerine yerleştirilen doğrusal bir katman) bulunan, görüntüden metne eşleştirme için kullanılan BridgeTower Model transformer'ı.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.BridgeTowerForImageAndTextRetrieval.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1512)
**Parametreler:**
input_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi belirteçlerinin (token) indeksleri. Varsayılan olarak dolgu (padding) yoksayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi kimlikları (input IDs) nedir?](../glossary#input-ids)
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdilerin ilk ve ikinci bölümlerini belirtmek için segment token dizinleri. Dizinler `[0, 1]` aralığından seçilir: - 0, *sentence A* token'ına karşılık gelir, - 1, *sentence B* token'ına karşılık gelir. [Token type ID'leri nelerdir?](../glossary#token-type-ids)
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [BridgeTowerImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın ([BridgeTowerProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerProcessor), görüntü işleme için [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) kullanır).
pixel_mask (`torch.LongTensor`, şekli `(batch_size, height, width)`, *isteğe bağlı*) : Dolgu piksel değerleri üzerinde dikkat işleminin uygulanmasını önlemek için maske. `[0, 1]` aralığında seçilen maske değerleri: - Gerçek (yani **maskelenmemiş**) pikseller için 1, - Dolgu (yani **maskelenmiş**) pikseller için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : `input_ids` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `input_ids` indekslerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisine kıyasla daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
image_embeds (`torch.Tensor`, şekli `(batch_size, num_patches, hidden_size)`, *isteğe bağlı*) : `pixel_values` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `pixel_values`'in yama gömülülerine (patch embeddings) nasıl dönüştürüleceği üzerinde daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
labels (`torch.LongTensor`, şekli `(batch_size, 1)`, *isteğe bağlı*) : Görsel-metin eşleşme kaybını hesaplamak için etiketler. 0, çiftlerin eşleşmediğini; 1 ise eşleştiğini belirtir. 0 etiketli çiftler hesaplama sırasında atlanır.
**Dönüş:** [SequenceClassifierOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) veya `tuple(torch.Tensor)`
[SequenceClassifierOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([BridgeTowerConfig](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[BridgeTowerForImageAndTextRetrieval](/docs/transformers/v5.23.0/tr/model_doc/bridgetower#transformers.BridgeTowerForImageAndTextRetrieval) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür) -- Sınıflandırma (config.num_labels==1 ise regresyon) kaybı.
- **logits** (`torch.Tensor`, şekli `(batch_size, config.num_labels)`) -- Sınıflandırma (veya config.num_labels==1 ise regresyon) puanları (SoftMax öncesi).
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> # forward pass
>>> scores = dict()
>>> for text in texts:
... # prepare inputs
... encoding = processor(image, text, return_tensors="pt")
... outputs = model(**encoding)
... scores[text] = outputs.logits[0, 1].item()
```