# BridgeTower
## Обзор
Модель BridgeTower была предложена в статье [BridgeTower: Building Bridges Between Encoders in Vision-Language Representative Learning](https://huggingface.co/papers/2206.08657) авторами Xiao Xu, Chenfei Wu, Shachar Rosenman, Vasudev Lal, Wanxiang Che, Nan Duan. Целью этой модели является построение моста между каждым уни-модальным энкодером и кросс-модальным энкодером для обеспечения комплексного и детального взаимодействия на каждом слое кросс-модального энкодера, что позволяет достичь выдающихся результатов на различных задачах с почти пренебрежимо малыми дополнительными затратами производительности и вычислительных ресурсов.
Эта статья была принята к публикации на конференции [AAAI'23](https://aaai.org/Conferences/AAAI-23/).
Аннотация из статьи следующая:
*Модели «зрение-язык» (VL) с архитектурой TWO-TOWER доминируют в области обучения представлений для задач зрения и языка в последние годы. Современные VL-модели либо используют лёгкие уни-модальные энкодеры и одновременно обучаются извлечению, выравниванию и слиянию обоих модальностей в глубоком кросс-модальном энкодере, либо передают представления последнего слоя уни-модальных энкодеров из глубоких предобученных уни-модальных энкодеров в верхний кросс-модальный энкодер. Оба подхода потенциально ограничивают обучение представлений для задач зрения и языка и сдерживают производительность моделей. В данной статье мы предлагаем BRIDGETOWER, который вводит несколько мостовых слоёв, устанавливающих связь между верхними слоями уни-модальных энкодеров и каждым слоем кросс-модального энкодера. Это обеспечивает эффективное кросс-модальное выравнивание и слияние «снизу вверх» между визуальными и текстовыми представлениями разных семантических уровней предобученных уни-модальных энкодеров в кросс-модальном энкодере. Предобученный всего на 4 млн изображений, BRIDGETOWER демонстрирует наилучшие результаты на различных downstream-задачах зрения и языка. В частности, на тестовом наборе test-std VQAv2 BRIDGETOWER достигает точности 78,73%, превосходя предыдущую модель с наилучшими результатами METER на 1,09% при использовании тех же данных предобучения и практически пренебрежимо малых дополнительных параметров и вычислительных затрат. Примечательно, что при дальнейшем масштабировании модели BRIDGETOWER достигает точности 81,15%, превосходя модели, предобученные на наборах данных, превосходящих его по размеру на порядки.*
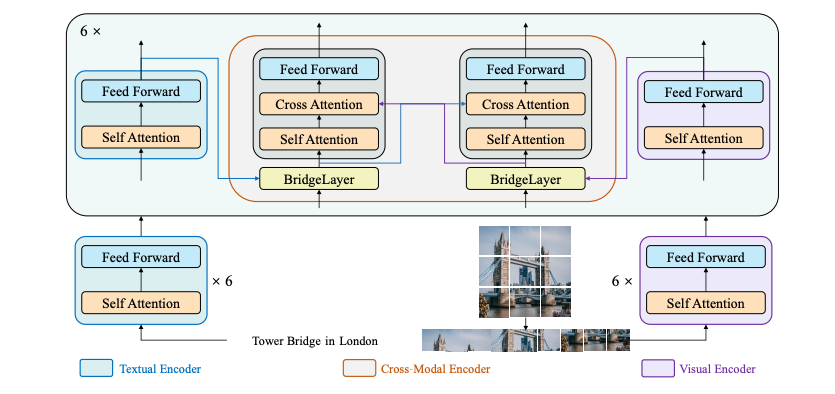 Архитектура BridgeTower. Взята из оригинальной статьи.
Эта модель была предоставлена [Anahita Bhiwandiwalla](https://huggingface.co/anahita-b), [Tiep Le](https://huggingface.co/Tile) и [Shaoyen Tseng](https://huggingface.co/shaoyent). Исходный код можно найти [здесь](https://github.com/microsoft/BridgeTower).
## Советы по использованию и примеры
BridgeTower состоит из визуального энкодера, текстового энкодера и кросс-модального энкодера с несколькими легковесными мостовыми слоями. Целью этого подхода было построить мост между каждым уни-модальным энкодером и кросс-модальным энкодером, чтобы обеспечить комплексное и детальное взаимодействие на каждом слое кросс-модального энкодера. В принципе, в предложенной архитектуре можно использовать любой визуальный, текстовый или кросс-модальный энкодер.
Класс [BridgeTowerProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerProcessor) объединяет [RobertaTokenizer](/docs/transformers/v5.23.0/ru/model_doc/led#transformers.RobertaTokenizer) и [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) в единый экземпляр для кодирования текста и подготовки изображений соответственно.
В следующем примере показано, как выполнять контрастное обучение с использованием [BridgeTowerProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerProcessor) и [BridgeTowerForContrastiveLearning](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerForContrastiveLearning).
```python
import requests
from PIL import Image
from transformers import BridgeTowerForContrastiveLearning, BridgeTowerProcessor
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
model = BridgeTowerForContrastiveLearning.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc", device_map="auto")
# forward pass
scores = dict()
for text in texts:
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
outputs = model(**encoding)
scores[text] = outputs
```
В следующем примере показано, как выполнять поиск изображений по тексту с помощью [BridgeTowerProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerProcessor) и [BridgeTowerForImageAndTextRetrieval](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerForImageAndTextRetrieval).
```python
import requests
from PIL import Image
from transformers import BridgeTowerForImageAndTextRetrieval, BridgeTowerProcessor
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm", device_map="auto")
# forward pass
scores = dict()
for text in texts:
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
outputs = model(**encoding)
scores[text] = outputs.logits[0, 1].item()
```
В следующем примере показано, как выполнить masked language modeling с использованием [BridgeTowerProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerProcessor) и [BridgeTowerForMaskedLM](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerForMaskedLM).
```python
from transformers import BridgeTowerProcessor, BridgeTowerForMaskedLM
from PIL import Image
import requests
url = "http://images.cocodataset.org/val2017/000000360943.jpg"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
text = "a looking out of the window"
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForMaskedLM.from_pretrained("BridgeTower/bridgetower-base-itm-mlm", device_map="auto")
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
# forward pass
outputs = model(**encoding)
results = processor.decode(outputs.logits.argmax(dim=-1).squeeze(0).tolist())
print(results)
.a cat looking out of the window.
```
Советы:
- Эта реализация BridgeTower использует [RobertaTokenizer](/docs/transformers/v5.23.0/ru/model_doc/led#transformers.RobertaTokenizer) для генерации текстовых эмбеддингов и модель CLIP/ViT от OpenAI для вычисления визуальных эмбеддингов.
- Опубликованы контрольные точки для предобученных моделей [bridgeTower-base](https://huggingface.co/BridgeTower/bridgetower-base) и [bridgetower masked language modeling and image text matching](https://huggingface.co/BridgeTower/bridgetower-base-itm-mlm).
- См. [Таблицу 5](https://huggingface.co/papers/2206.08657) для оценки производительности BridgeTower на задаче поиска изображений и других задачах нижнего уровня.
## BridgeTowerConfig[[transformers.BridgeTowerConfig]]
#### transformers.BridgeTowerConfig[[transformers.BridgeTowerConfig]]
```python
transformers.BridgeTowerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, share_cross_modal_transformer_layers: bool = True, hidden_act: str = 'gelu', hidden_size: int = 768, initializer_factor: float | int = 1, layer_norm_eps: float = 1e-05, share_link_tower_layers: bool = False, link_tower_type: str = 'add', num_attention_heads: int = 12, num_hidden_layers: int = 6, tie_word_embeddings: bool = False, init_layernorm_from_vision_encoder: bool = False, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/configuration_bridgetower.py#L104)
**Параметры:**
share_cross_modal_transformer_layers (`bool`, *необязательный*, по умолчанию `True`) : Указывает, используются ли общие слои трансформера для кросс-модальных данных.
hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
hidden_size (`int`, *optional*, по умолчанию `768`) : Размерность скрытых представлений.
initializer_factor (`Union[float, int]`, *необязательный*, по умолчанию `1`) : Коэффициент для инициализации всех матриц весов (должен оставаться равным 1, используется внутренне для тестирования инициализации).
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-05`) : Значение epsilon, используемое слоями нормализации.
share_link_tower_layers (`bool`, *необязательный*, по умолчанию `False`) : Указывает, используются ли общие слои моста/башни связи.
link_tower_type (`str`, *необязательный*, по умолчанию `"add"`) : Тип моста/канального уровня.
num_attention_heads (`int`, *необязательный*, по умолчанию `12`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
num_hidden_layers (`int`, *необязательный*, по умолчанию `6`) : Количество скрытых слоев в декодере Transformer.
tie_word_embeddings (`bool`, *необязательный*, по умолчанию `False`) : Связывать ли веса эмбеддингов согласно отображению `tied_weights_keys` модели.
init_layernorm_from_vision_encoder (`bool`, *необязательный*, по умолчанию `False`) : Инициализировать ли LayerNorm из визуального энкодера.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Объект конфигурации или словарь текстового бэкбона.
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Объект конфигурации или словарь для визуального бэкбона.
Это класс конфигурации для хранения настроек модели BridgeTowerModel. Он используется для создания модели Bridgetower в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации модели [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import BridgeTowerModel, BridgeTowerConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration
>>> configuration = BridgeTowerConfig()
>>> # Initializing a model from the BridgeTower/bridgetower-base style configuration
>>> model = BridgeTowerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## BridgeTowerTextConfig[[transformers.BridgeTowerTextConfig]]
#### transformers.BridgeTowerTextConfig[[transformers.BridgeTowerTextConfig]]
```python
transformers.BridgeTowerTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 50265, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, initializer_factor: float | int = 1, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 514, type_vocab_size: int = 1, layer_norm_eps: float = 1e-05, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, use_cache: bool = True, is_decoder: bool = False, add_cross_attention: bool = False)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/configuration_bridgetower.py#L65)
**Параметры:**
vocab_size (`int`, *необязательный*, по умолчанию `50265`) : Размер словаря модели. Определяет количество различных токенов, которые могут быть представлены в `input_ids`.
hidden_size (`int`, *optional*, по умолчанию `768`) : Размерность скрытых представлений.
num_hidden_layers (`int`, *необязательный*, по умолчанию `12`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `12`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
initializer_factor (`Union[float, int]`, *необязательный*, по умолчанию `1`) : Коэффициент для инициализации всех матриц весов (должен оставаться равным 1, используется внутренне для тестирования инициализации).
intermediate_size (`int`, *optional*, по умолчанию `3072`) : Размерность представлений MLP.
hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
hidden_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.1`) : Вероятность dropout для всех полносвязных слоев в эмбеддингах, энкодере и пулере.
attention_probs_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.1`) : Доля dropout для вероятностей внимания.
max_position_embeddings (`int`, *необязательный*, по умолчанию `514`) : Максимальная длина последовательности, с которой может использоваться данная модель.
type_vocab_size (`int`, *необязательный*, по умолчанию `1`) : Размер словаря для `token_type_ids`.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-05`) : Значение epsilon, используемое слоями нормализации.
pad_token_id (`int`, *необязательный*, по умолчанию `1`) : Идентификатор токена, используемый для выравнивания в словаре.
bos_token_id (`int`, *необязательный*, по умолчанию `0`) : Идентификатор токена, используемый для обозначения начала потока в словаре.
eos_token_id (`Union[int, list[int]]`, *необязательный*, по умолчанию `2`) : Идентификатор токена, используемого для обозначения конца потока в словаре.
use_cache (`bool`, *необязательный*, по умолчанию `True`) : Следует ли модели возвращать последние значения внимания key/values (не используется во всех моделях). Актуально только при `config.is_decoder=True` или если модель является генеративной моделью только с декодером.
is_decoder (`bool`, *необязательный*, по умолчанию `False`) : Указывает, используется ли модель в качестве декодера. Если `False`, модель используется как энкодер.
add_cross_attention (`bool`, *необязательный*, по умолчанию `False`) : Следует ли добавлять слои кросс-внимания в модель.
Это класс конфигурации для хранения настроек модели BridgeTowerModel. Он используется для создания модели Bridgetower в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации модели [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import BridgeTowerTextConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration for the text model
>>> configuration = BridgeTowerTextConfig()
>>> # Accessing the configuration
>>> configuration
```
## BridgeTowerVisionConfig[[transformers.BridgeTowerVisionConfig]]
#### transformers.BridgeTowerVisionConfig[[transformers.BridgeTowerVisionConfig]]
```python
transformers.BridgeTowerVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_channels: int = 3, patch_size: int | list[int] | tuple[int, int] = 16, image_size: int | list[int] | tuple[int, int] = 288, initializer_factor: float | int = 1, layer_norm_eps: float = 1e-05, stop_gradient: bool = False, share_layernorm: bool = True, remove_last_layer: bool = False)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/configuration_bridgetower.py#L27)
**Параметры:**
hidden_size (`int`, *optional*, по умолчанию `768`) : Размерность скрытых представлений.
num_hidden_layers (`int`, *необязательный*, по умолчанию `12`) : Количество скрытых слоев в декодере Transformer.
num_channels (`int`, *необязательный*, по умолчанию `3`) : Количество входных каналов.
patch_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `16`) : Размер (разрешение) каждого патча.
image_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `288`) : Размер (разрешение) каждого изображения.
initializer_factor (`Union[float, int]`, *необязательный*, по умолчанию `1`) : Коэффициент для инициализации всех матриц весов (должен оставаться равным 1, используется внутренне для тестирования инициализации).
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-05`) : Значение epsilon, используемое слоями нормализации.
stop_gradient (`bool`, *необязательный*, по умолчанию `False`) : Нужно ли останавливать градиент для обучения.
share_layernorm (`bool`, *необязательный*, по умолчанию `True`) : Указывает, используются ли общие слои LayerNorm.
remove_last_layer (`bool`, *необязательный*, по умолчанию `False`) : Указывает, следует ли удалить последний слой из визуального энкодера.
Это класс конфигурации для хранения настроек модели BridgeTowerModel. Он используется для создания модели Bridgetower в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации модели [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import BridgeTowerVisionConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration for the vision model
>>> configuration = BridgeTowerVisionConfig()
>>> # Accessing the configuration
>>> configuration
```
## BridgeTowerImageProcessor[[transformers.BridgeTowerImageProcessor]]
#### transformers.BridgeTowerImageProcessor[[transformers.BridgeTowerImageProcessor]]
```python
transformers.BridgeTowerImageProcessor(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/image_processing_bridgetower.py#L76)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 288}`): описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 288}`): Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `3`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Влияет только в том случае, если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.48145466, 0.4578275, 0.40821073]`) : Среднее значение изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.26862954, 0.26130258, 0.27577711]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли дополнять изображение. Дополнение выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия дополнения зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли выполнять центрированный кроп изображения.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
size_divisor (`int`, *kwargs*, по умолчанию `32`) : Размер, на который следует убедиться, что и высота, и ширина делятся без остатка.
Создаёт процессор изображений BridgeTowerImageProcessor.
#### preprocess[[transformers.BridgeTowerImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *необязательный*) : Флаг разработчика для дополнительных изображений и похожих на них входных данных, которые также будут предобработаны. Используйте этот параметр только в том случае, если передача входных данных через kwarg не работает. Например, `preprocess(images, masks=masks)` — предпочтительный вариант, но для некоторых моделей он приводит к проблемам с приоритетом аргументов. В таких случаях можно использовать `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
Предобработка изображения или пакета изображений.
## BridgeTowerImageProcessorPil[[transformers.BridgeTowerImageProcessorPil]]
#### transformers.BridgeTowerImageProcessorPil[[transformers.BridgeTowerImageProcessorPil]]
```python
transformers.BridgeTowerImageProcessorPil(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/image_processing_pil_bridgetower.py#L70)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 288}`): описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 288}`): Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `3`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Влияет только в том случае, если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.48145466, 0.4578275, 0.40821073]`) : Среднее значение изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.26862954, 0.26130258, 0.27577711]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли дополнять изображение. Дополнение выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия дополнения зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли выполнять центрированный кроп изображения.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
size_divisor (`int`, *kwargs*, по умолчанию `32`) : Размер, на который следует убедиться, что и высота, и ширина делятся без остатка.
Создаёт процессор изображений BridgeTowerImageProcessor.
#### preprocess[[transformers.BridgeTowerImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *необязательный*) : Флаг разработчика для дополнительных изображений и похожих на них входных данных, которые также будут предобработаны. Используйте этот параметр только в том случае, если передача входных данных через kwarg не работает. Например, `preprocess(images, masks=masks)` — предпочтительный вариант, но для некоторых моделей он приводит к проблемам с приоритетом аргументов. В таких случаях можно использовать `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
Предобработка изображения или пакета изображений.
## BridgeTowerProcessor[[transformers.BridgeTowerProcessor]]
#### transformers.BridgeTowerProcessor[[transformers.BridgeTowerProcessor]]
```python
transformers.BridgeTowerProcessor(image_processor, tokenizer)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/processing_bridgetower.py#L24)
**Параметры:**
image_processor (`BridgeTowerImageProcessor`) : процессор изображений является обязательным входным параметром.
tokenizer (`RobertaTokenizer`) : Токенизатор является обязательным входным параметром.
Создаёт BridgeTowerProcessor, который объединяет процессор изображений и токенизатор в единый процессор.
[BridgeTowerProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerProcessor) предоставляет все возможности [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) и [RobertaTokenizer](/docs/transformers/v5.23.0/ru/model_doc/led#transformers.RobertaTokenizer). Подробнее см. в [~BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) и [~RobertaTokenizer](/docs/transformers/v5.23.0/ru/model_doc/led#transformers.RobertaTokenizer).
#### __call__[[transformers.BridgeTowerProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L670)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *необязательный*) : Изображение для предварительной обработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *необязательный*) : Последовательность или батч последовательностей для кодирования. Каждая последовательность может быть строкой или списком строк (предтокенизированная строка). Если вы передаёте предтокенизированный вход, установите `is_split_into_words=True`, чтобы избежать неоднозначности с батчированными входами.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *optional*) : Видео для предобработки. Ожидается одно видео или батч видео со значениями пикселей в диапазоне от 0 до 255. Если передаются видео со значениями пикселей от 0 до 1, установите `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *необязательный*) : Аудио или пакет аудио для подготовки. Каждое аудио может быть массивом NumPy или тензором PyTorch. В случае массива NumPy/тензора PyTorch каждое аудио должно иметь форму (C, T), где C — количество каналов, а T — длина выборки аудио.
return_mm_token_type_ids (`bool`, *kwargs*) : Нужно ли возвращать идентификаторы типов мультимодальных токенов, указывающие на позиции мультимодальных плейсхолдер-токенов.
return_text_replacement_offsets (`bool`, *kwargs*) : Нужно ли возвращать смещения символов для каждого мультимодального плейсхолдера и его замены.
return_tensors (`str` или [TensorType](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.TensorType), *optional*) : Если задано, возвращает тензоры конкретного фреймворка. Допустимые значения: - `'pt'`: возвращает объекты `torch.Tensor` PyTorch. - `'np'`: возвращает объекты `np.ndarray` NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/ru/main_classes/processors#transformers.ProcessingKwargs), *optional*) : Дополнительные параметры обработки для каждой модальности (текст, изображения, видео, аудио). Специфичные для модели параметры перечислены выше; полный список поддерживаемых аргументов см. в классе TypedDict.
## BridgeTowerModel[[transformers.BridgeTowerModel]]
#### transformers.BridgeTowerModel[[transformers.BridgeTowerModel]]
```python
transformers.BridgeTowerModel(config: BridgeTowerConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1079)
**Параметры:**
config ([BridgeTowerConfig](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Базовый трансформер BridgeTower Model, возвращающий объект BridgeTowerModelOutput без какого-либо специализированного слоя
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.BridgeTowerModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, image_token_type_idx: int | None = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1152)
**Параметры:**
input_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы токенов сегментов для указания первой и второй частей входных данных. Индексы выбираются из `[0, 1]`: - 0 соответствует токену *предложения A*, - 1 соответствует токену *предложения B*. [Что такое идентификаторы типов токенов?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Подробности см. в [BridgeTowerImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([BridgeTowerProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerProcessor) использует [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) для обработки изображений).
pixel_mask (`torch.LongTensor` формы `(batch_size, height, width)`, *необязательно*) : Маска для исключения значений пикселей отступов из внимания. Значения маски выбираются из `[0, 1]`: - 1 для реальных пикселей (т. е. **не замаскированных**), - 0 для пикселей отступов (т. е. **замаскированных**). [Что такое маски внимания?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательно*) : По желанию, вместо передачи `input_ids` можно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексы `input_ids` преобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели.
image_embeds (`torch.Tensor` формы `(batch_size, num_patches, hidden_size)`, *необязательно*) : По желанию, вместо передачи `pixel_values`, вы можете напрямую передать встроенное представление. Это полезно, если вы хотите больше контролировать, как `pixel_values` преобразуются в эмбеддинги патчей.
image_token_type_idx (`int`, *optional*) : - Идентификаторы типов токенов для изображений.
labels (`torch.LongTensor` формы `(batch_size,)`, *необязательный*) : В настоящее время метки не поддерживаются.
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** `BridgeTowerModelOutput` или `tuple(torch.Tensor)`
Объект `BridgeTowerModelOutput` или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([BridgeTowerConfig](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerConfig)) и входных данных.
Метод forward модели [BridgeTowerModel](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **text_features** (`torch.Tensor` формы `(batch_size, text_sequence_length, hidden_size)`) -- Последовательность скрытых состояний на текстовом выходе последнего слоя модели.
- **image_features** (`torch.Tensor` формы `(batch_size, image_sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе изображения последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size x 2)`) -- Конкатенация скрытых состояний последнего слоя первого токена последовательности текста и изображения (токен классификации) соответственно, после дальнейшей обработки через слои, используемые для вспомогательных задач предварительного обучения.
- **hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> # prepare image and text
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "hello world"
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base")
>>> model = BridgeTowerModel.from_pretrained("BridgeTower/bridgetower-base")
>>> inputs = processor(image, text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> outputs.keys()
odict_keys(['text_features', 'image_features', 'pooler_output'])
```
## BridgeTowerForContrastiveLearning[[transformers.BridgeTowerForContrastiveLearning]]
#### transformers.BridgeTowerForContrastiveLearning[[transformers.BridgeTowerForContrastiveLearning]]
```python
transformers.BridgeTowerForContrastiveLearning(config: BridgeTowerConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1603)
**Параметры:**
config ([BridgeTowerConfig](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
BridgeTower Model с контрастной головой для изображений и текста, вычисляющей контрастную потерю для изображений и текста.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.BridgeTowerForContrastiveLearning.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, return_loss: bool | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1617)
**Параметры:**
input_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы токенов сегментов для указания первой и второй частей входных данных. Индексы выбираются из `[0, 1]`: - 0 соответствует токену *предложения A*, - 1 соответствует токену *предложения B*. [Что такое идентификаторы типов токенов?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Подробности см. в [BridgeTowerImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([BridgeTowerProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerProcessor) использует [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) для обработки изображений).
pixel_mask (`torch.LongTensor` формы `(batch_size, height, width)`, *необязательно*) : Маска для исключения значений пикселей отступов из внимания. Значения маски выбираются из `[0, 1]`: - 1 для реальных пикселей (т. е. **не замаскированных**), - 0 для пикселей отступов (т. е. **замаскированных**). [Что такое маски внимания?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательно*) : По желанию, вместо передачи `input_ids` можно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексы `input_ids` преобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели.
image_embeds (`torch.Tensor` формы `(batch_size, num_patches, hidden_size)`, *необязательно*) : По желанию, вместо передачи `pixel_values`, вы можете напрямую передать встроенное представление. Это полезно, если вы хотите больше контролировать, как `pixel_values` преобразуются в эмбеддинги патчей.
return_loss (`bool`, *необязательный*) : Нужно ли возвращать контрастную потерю.
**Возвращает:** `BridgeTowerContrastiveOutput` или `tuple(torch.Tensor)`
Объект `BridgeTowerContrastiveOutput` или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([BridgeTowerConfig](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerConfig)) и входных данных.
Метод forward класса [BridgeTowerForContrastiveLearning](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerForContrastiveLearning) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если `return_loss` равно `True`) -- Контрастная потеря для изображения и текста.
- **logits** (`torch.Tensor` формы `(batch_size, sequence_length, config.vocab_size)`) — Оценки предсказаний языковой модели (оценки для каждого токена словаря до применения SoftMax).
- **text_embeds** (`torch.Tensor)`, *optional*, returned when model is initialized with `with_projection=True`) -- The text embeddings obtained by applying the projection layer to the pooler_output.
- **image_embeds** (`torch.Tensor)`, *optional*, returned when model is initialized with `with_projection=True`) -- The image embeddings obtained by applying the projection layer to the pooler_output.
- **cross_embeds** (`torch.Tensor)`, *optional*, returned when model is initialized with `with_projection=True`) -- The text-image cross-modal embeddings obtained by applying the projection layer to the pooler_output.
- **hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Примеры:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForContrastiveLearning
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> image_urls = [
... "https://farm4.staticflickr.com/3395/3428278415_81c3e27f15_z.jpg",
... "http://images.cocodataset.org/val2017/000000039769.jpg",
... ]
>>> texts = ["two dogs in a car", "two cats sleeping on a couch"]
>>> with httpx.stream("GET", urls[0]) as response:
... image1 = Image.open(BytesIO(response.read()))
>>> with httpx.stream("GET", urls[1]) as response:
... image2 = Image.open(BytesIO(response.read()))
>>> images = [image1, image2]
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
>>> model = BridgeTowerForContrastiveLearning.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
>>> inputs = processor(images, texts, padding=True, return_tensors="pt")
>>> loss = model(**inputs, return_loss=True).loss
>>> inputs = processor(images, texts[::-1], padding=True, return_tensors="pt")
>>> loss_swapped = model(**inputs, return_loss=True).loss
>>> print("Loss", round(loss.item(), 4))
Loss 0.0019
>>> print("Loss with swapped images", round(loss_swapped.item(), 4))
Loss with swapped images 2.126
```
## BridgeTowerForMaskedLM[[transformers.BridgeTowerForMaskedLM]]
#### transformers.BridgeTowerForMaskedLM[[transformers.BridgeTowerForMaskedLM]]
```python
transformers.BridgeTowerForMaskedLM(config: BridgeTowerConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1404)
**Параметры:**
config ([BridgeTowerConfig](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
BridgeTower Model с головой для моделирования языка, как это было сделано во время предварительного обучения.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.BridgeTowerForMaskedLM.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1422)
**Параметры:**
input_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы токенов сегментов для указания первой и второй частей входных данных. Индексы выбираются из `[0, 1]`: - 0 соответствует токену *предложения A*, - 1 соответствует токену *предложения B*. [Что такое идентификаторы типов токенов?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Подробности см. в [BridgeTowerImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([BridgeTowerProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerProcessor) использует [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) для обработки изображений).
pixel_mask (`torch.LongTensor` формы `(batch_size, height, width)`, *необязательно*) : Маска для исключения значений пикселей отступов из внимания. Значения маски выбираются из `[0, 1]`: - 1 для реальных пикселей (т. е. **не замаскированных**), - 0 для пикселей отступов (т. е. **замаскированных**). [Что такое маски внимания?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательно*) : По желанию, вместо передачи `input_ids` можно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексы `input_ids` преобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели.
image_embeds (`torch.Tensor` формы `(batch_size, num_patches, hidden_size)`, *необязательно*) : По желанию, вместо передачи `pixel_values`, вы можете напрямую передать встроенное представление. Это полезно, если вы хотите больше контролировать, как `pixel_values` преобразуются в эмбеддинги патчей.
labels (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Метки для вычисления потерь маскированного языкового моделирования. Индексы должны находиться в диапазоне `[-100, 0, ..., config.vocab_size]` (см. docstring `input_ids`). Токены с индексами, установленными в `-100`, игнорируются (маскируются); потери вычисляются только для токенов с метками в диапазоне `[0, ..., config.vocab_size]`.
**Возвращает:** [MaskedLMOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) или `tuple(torch.Tensor)`
[MaskedLMOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([BridgeTowerConfig](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerConfig)) и входных данных.
Метод forward класса [BridgeTowerForMaskedLM](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerForMaskedLM) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери маскированного языкового моделирования (MLM).
- **logits** (`torch.Tensor` формы `(batch_size, sequence_length, config.vocab_size)`) — Оценки предсказаний языковой модели (оценки для каждого токена словаря до применения SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForMaskedLM
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000360943.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> text = "a looking out of the window"
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> model = BridgeTowerForMaskedLM.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**encoding)
>>> results = processor.decode(outputs.logits.argmax(dim=-1).squeeze(0).tolist())
>>> print(results)
.a cat looking out of the window.
```
## BridgeTowerForImageAndTextRetrieval[[transformers.BridgeTowerForImageAndTextRetrieval]]
#### transformers.BridgeTowerForImageAndTextRetrieval[[transformers.BridgeTowerForImageAndTextRetrieval]]
```python
transformers.BridgeTowerForImageAndTextRetrieval(config: BridgeTowerConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1501)
**Параметры:**
config ([BridgeTowerConfig](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
BridgeTower: модель-трансформер с классификатором на верхнем уровне (линейный слой поверх финального скрытого состояния токена [CLS]) для сопоставления изображений с текстом.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.BridgeTowerForImageAndTextRetrieval.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/bridgetower/modeling_bridgetower.py#L1512)
**Параметры:**
input_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы токенов сегментов для указания первой и второй частей входных данных. Индексы выбираются из `[0, 1]`: - 0 соответствует токену *предложения A*, - 1 соответствует токену *предложения B*. [Что такое идентификаторы типов токенов?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Подробности см. в [BridgeTowerImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([BridgeTowerProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerProcessor) использует [BridgeTowerImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) для обработки изображений).
pixel_mask (`torch.LongTensor` формы `(batch_size, height, width)`, *необязательно*) : Маска для исключения значений пикселей отступов из внимания. Значения маски выбираются из `[0, 1]`: - 1 для реальных пикселей (т. е. **не замаскированных**), - 0 для пикселей отступов (т. е. **замаскированных**). [Что такое маски внимания?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательно*) : По желанию, вместо передачи `input_ids` можно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексы `input_ids` преобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели.
image_embeds (`torch.Tensor` формы `(batch_size, num_patches, hidden_size)`, *необязательно*) : По желанию, вместо передачи `pixel_values`, вы можете напрямую передать встроенное представление. Это полезно, если вы хотите больше контролировать, как `pixel_values` преобразуются в эмбеддинги патчей.
labels (`torch.LongTensor` формы `(batch_size, 1)`, *необязательный*) : Метки для вычисления функции потерь соответствия изображения и текста. 0 означает, что пары не соответствуют друг другу, а 1 — что соответствуют. Пары с меткой 0 пропускаются при вычислении.
**Возвращает:** [SequenceClassifierOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) или `tuple(torch.Tensor)`
Объект [SequenceClassifierOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([BridgeTowerConfig](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerConfig)) и входных данных.
Метод forward класса [BridgeTowerForImageAndTextRetrieval](/docs/transformers/v5.23.0/ru/model_doc/bridgetower#transformers.BridgeTowerForImageAndTextRetrieval) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери классификации (или регрессии, если config.num_labels==1).
- **logits** (`torch.Tensor` формы `(batch_size, config.num_labels)`) — Оценки классификации (или регрессии, если config.num_labels==1) до применения SoftMax.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> # forward pass
>>> scores = dict()
>>> for text in texts:
... # prepare inputs
... encoding = processor(image, text, return_tensors="pt")
... outputs = model(**encoding)
... scores[text] = outputs.logits[0, 1].item()
```