# Audio Spectrogram Transformer
## Обзор
Модель Audio Spectrogram Transformer была предложена в работе [AST: Audio Spectrogram Transformer](https://huggingface.co/papers/2104.01778) Юань Гунгом, Ю-Ан Чунгом и Джеймсом Глассом. Audio Spectrogram Transformer применяет [Vision Transformer](vit) к аудио, преобразуя звук в изображение (спектрограмму). Модель демонстрирует наилучшие результаты для классификации аудио.
Аннотация из статьи следующая:
*За последнее десятилетие свёрточные нейронные сети (CNN) получили широкое распространение в качестве основного строительного блока для моделей классификации аудио, обученных end-to-end, которые стремятся выучить прямое отображение из спектрограмм аудио на соответствующие метки. Чтобы лучше улавливать глобальный контекст на больших расстояниях, в последнее время стало модным добавлять механизм self-attention поверх CNN, формируя гибридную модель CNN-attention. Однако неясно, является ли опора на CNN необходимой и достаточно ли нейронных сетей, основанных исключительно на attention, для достижения хороших результатов в классификации аудио. В данной статье мы отвечаем на этот вопрос, представляя Audio Spectrogram Transformer (AST) — первую модель для классификации аудио, не содержащую свёрток и основанную исключительно на attention. Мы оцениваем AST на различных бенчмарках классификации аудио, где он достигает новых рекордных результатов: 0.485 mAP на AudioSet, 95.6% точности на ESC-50 и 98.1% точности на Speech Commands V2.*
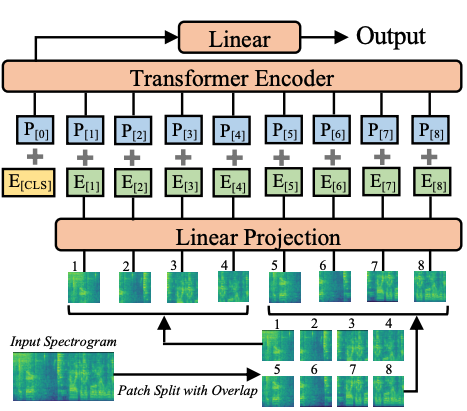 Архитектура Audio Spectrogram Transformer. Источник — оригинальная статья.
Эта модель была предоставлена пользователем [nielsr](https://huggingface.co/nielsr). Исходный код можно найти [здесь](https://github.com/YuanGongND/ast).
## Советы по использованию
- При дообучении Audio Spectrogram Transformer (AST) на собственном наборе данных рекомендуется позаботиться о нормализации входных данных (чтобы
уверены, что входные данные имеют среднее значение 0 и стандартное отклонение 0,5). [ASTFeatureExtractor](/docs/transformers/main/ru/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor) обеспечивает это. Обратите внимание, что по умолчанию используются среднее и стандартное отклонение AudioSet. Вы можете проверить [`ast/src/get_norm_stats.py`](https://github.com/YuanGongND/ast/blob/master/src/get_norm_stats.py), чтобы увидеть, как авторы вычисляют статистику для целевого набора данных.
- Обратите внимание, что AST требует низкой скорости обучения (авторы используют скорость обучения в 10 раз меньшую по сравнению с их моделью CNN, предложенной в
[статья PSLA](https://huggingface.co/papers/2102.01243)) и сходится быстро, поэтому подберите подходящую скорость обучения и планировщик скорости обучения для вашей задачи.
### Использование масштабированного внимания на основе скалярного произведения (SDPA)
PyTorch включает в себя нативный оператор масштабированного внимания на основе скалярного произведения (SDPA) в составе `torch.nn.functional`. Эта функция объединяет несколько реализаций, которые могут применяться в зависимости от входных данных и используемого оборудования. Подробнее см. в [официальной документации](https://pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention.html) или на странице [GPU Inference](https://huggingface.co/docs/transformers/main/en/perf_infer_gpu_one#pytorch-scaled-dot-product-attention).
SDPA используется по умолчанию для `torch>=2.1.1`, когда доступна соответствующая реализация, но вы также можете установить `attn_implementation="sdpa"` в `from_pretrained()`, чтобы явно запросить использование SDPA.
```python
from transformers import ASTForAudioClassification
model = ASTForAudioClassification.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593", attn_implementation="sdpa", device_map="auto")
...
```
Для достижения максимального ускорения мы рекомендуем загружать модель в половинной точности (например, `torch.float16` или `torch.bfloat16`).
На локальном бенчмарке (A100-40GB, PyTorch 2.3.0, ОС Ubuntu 22.04) с `float32` и моделью `MIT/ast-finetuned-audioset-10-10-0.4593` мы наблюдали следующие ускорения при инференсе.
| Размер пакета | Среднее время вывода (мс), режим eager | Среднее время инференса (мс), модель sdpa | Ускорение, Sdpa / Eager (x) |
|--------------|-------------------------------------------|-------------------------------------------|------------------------------|
| 1 | 27 | 6 | 4.5 |
| 2 | 12 | 6 | 2 |
| 4 | 21 | 8 | 2.62 |
| 8 | 40 | 14 | 2.86 |
## Ресурсы
Список официальных ресурсов Hugging Face и сообщества (отмечены значком 🌎), которые помогут вам начать работу с Audio Spectrogram Transformer.
- Ноутбук с примером инференса с использованием AST для классификации аудио можно найти [здесь](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/AST).
- [ASTForAudioClassification](/docs/transformers/main/ru/model_doc/audio-spectrogram-transformer#transformers.ASTForAudioClassification) поддерживается в этом [ноутбуке](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/audio_classification.ipynb).
- См. также: [Классификация аудио](../tasks/audio_classification).
Если вы хотите предложить ресурс для включения в этот раздел, пожалуйста, создайте Pull Request, и мы его рассмотрим! В идеале ресурс должен демонстрировать что-то новое, а не дублировать существующие материалы.
## ASTConfig[[transformers.ASTConfig]]
#### transformers.ASTConfig[[transformers.ASTConfig]]
```python
transformers.ASTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, patch_size: int | list[int] | tuple[int, int] = 16, qkv_bias: bool = True, frequency_stride: int = 10, time_stride: int = 10, max_length: int = 1024, num_mel_bins: int = 128)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/configuration_audio_spectrogram_transformer.py#L24)
**Параметры:**
hidden_size (`int`, *optional*, по умолчанию `768`) : Размерность скрытых представлений.
num_hidden_layers (`int`, *необязательный*, по умолчанию `12`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `12`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
intermediate_size (`int`, *optional*, по умолчанию `3072`) : Размерность представлений MLP.
hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
hidden_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Вероятность dropout для всех полносвязных слоёв в эмбеддингах, энкодере и пулере.
attention_probs_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Коэффициент dropout для вероятностей внимания.
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-12`) : Значение epsilon, используемое слоями нормализации.
patch_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `16`) : Размер (разрешение) каждого патча.
qkv_bias (`bool`, *необязательный*, по умолчанию `True`) : Добавлять ли смещение (bias) к запросам, ключам и значениям.
frequency_stride (`int`, *optional*, по умолчанию 10) : Шаг по частоте, используемый при преобразовании спектрограмм в патчи.
time_stride (`int`, *optional*, по умолчанию 10) : Временной шаг, используемый при преобразовании спектрограмм в патчи.
max_length (`int`, *необязательный*, по умолчанию 1024) : Временное измерение спектрограмм.
num_mel_bins (`int`, *optional*, по умолчанию `128`) : Количество мел-признаков, используемых на входной кадр. Должно соответствовать значению, используемому в классе `AutoFeatureExtractor`.
Это класс конфигурации для хранения настроек модели Audio Spectrogram Transformer. Он используется для создания модели Audio Spectrogram Transformer в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации модели [MIT/ast-finetuned-audioset-10-10-0.4593](https://huggingface.co/MIT/ast-finetuned-audioset-10-10-0.4593)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import ASTConfig, ASTModel
>>> # Initializing a AST MIT/ast-finetuned-audioset-10-10-0.4593 style configuration
>>> configuration = ASTConfig()
>>> # Initializing a model (with random weights) from the MIT/ast-finetuned-audioset-10-10-0.4593 style configuration
>>> model = ASTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ASTFeatureExtractor[[transformers.ASTFeatureExtractor]]
#### transformers.ASTFeatureExtractor[[transformers.ASTFeatureExtractor]]
```python
transformers.ASTFeatureExtractor(feature_size = 1, sampling_rate = 16000, num_mel_bins = 128, max_length = 1024, padding_value = 0.0, do_normalize = True, mean = -4.2677393, std = 4.5689974, return_attention_mask = False, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/feature_extraction_audio_spectrogram_transformer.py#L38)
**Параметры:**
feature_size (`int`, *optional*, по умолчанию 1) : Размерность признаков извлечённых признаков.
sampling_rate (`int`, *optional*, по умолчанию 16000) : Частота дискретизации, с которой аудиофайлы должны быть оцифрованы, выраженная в герцах (Гц).
num_mel_bins (`int`, *optional*, по умолчанию 128) : Количество Mel-частотных бинов.
max_length (`int`, *optional*, по умолчанию 1024) : Максимальная длина, до которой следует дополнять/обрезать извлечённые признаки.
do_normalize (`bool`, *необязательный*, по умолчанию `True`) : Нужно ли нормализовать log-Mel-признаки с помощью `mean` и `std`.
mean (`float`, *optional*, по умолчанию -4.2677393) : Среднее значение, используемое для нормализации лог-Мель-признаков. По умолчанию используется среднее значение AudioSet.
std (`float`, *optional*, по умолчанию 4.5689974) : Значение стандартного отклонения, используемое для нормализации лог-Мель-признаков. По умолчанию используется стандартное отклонение AudioSet.
return_attention_mask (`bool`, *необязательный*, по умолчанию `False`) : Следует ли [__call__()](/docs/transformers/main/ru/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__) возвращать `attention_mask`.
Создаёт экстрактор признаков Audio Spectrogram Transformer (AST).
Этот экстрактор признаков наследуется от [SequenceFeatureExtractor](/docs/transformers/main/ru/main_classes/feature_extractor#transformers.SequenceFeatureExtractor), который содержит большинство основных методов. За дополнительной информацией о них следует обращаться к этому суперклассу.
Этот класс извлекает характеристики банка мел-фильтров из сырых речевых данных с использованием TorchAudio, если он установлен, или numpy в противном случае, дополняет/обрезает их до фиксированной длины и нормализует с помощью среднего значения и стандартного отклонения.
#### __call__[[transformers.ASTFeatureExtractor.__call__]]
```python
__call__(raw_speech: numpy.ndarray | list[float] | list[numpy.ndarray] | list[list[float]], sampling_rate: int | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/feature_extraction_audio_spectrogram_transformer.py#L160)
**Параметры:**
raw_speech (`np.ndarray`, `list[float]`, `list[np.ndarray]`, `list[list[float]]`) : Последовательность или батч последовательностей, для которых требуется выравнивание. Каждая последовательность может быть массивом numpy, списком значений float, списком массивов numpy или списком списков значений float. Аудио должно быть моноканальным, а не стерео, то есть одно значение float на временной шаг.
sampling_rate (`int`, *optional*) : Частота дискретизации, с которой вход `raw_speech` был оцифрован. Настоятельно рекомендуется передавать `sampling_rate` при вызове forward, чтобы избежать скрытых ошибок.
return_tensors (`str` или [TensorType](/docs/transformers/main/ru/internal/file_utils#transformers.TensorType), *optional*) : Если задано, возвращает тензоры вместо списка целых чисел Python. Допустимые значения: - `'pt'`: Возвращает объекты `torch.Tensor` PyTorch. - `'np'`: Возвращает объекты `np.ndarray` Numpy.
Основной метод для создания признаков и подготовки одной или нескольких последовательностей для модели.
## ASTModel[[transformers.ASTModel]]
#### transformers.ASTModel[[transformers.ASTModel]]
```python
transformers.ASTModel(config: ASTConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L257)
**Параметры:**
config ([ASTConfig](/docs/transformers/main/ru/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Audio Spectrogram Transformer, выводящая необработанные скрытые состояния без какого-либо специализированного слоя на выходе.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.ASTModel.forward]]
```python
forward(input_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L273)
**Параметры:**
input_values (`torch.Tensor` формы `(batch_size, max_length, num_mel_bins)`) : Значения типа float, представляющие мел-фичи, извлечённые из исходной аудиоволны. Исходную аудиоволну можно получить, загрузив аудиофайл `.flac` или `.wav` в массив типа `list[float]`, `numpy.ndarray` или `torch.Tensor`, *например*, с помощью библиотеки torchcodec (`pip install torchcodec`) или библиотеки soundfile (`pip install soundfile`). Для подготовки массива в `input_features` следует использовать [AutoFeatureExtractor](/docs/transformers/main/ru/model_doc/auto#transformers.AutoFeatureExtractor) для извлечения мел-фич, дополнения (padding) и преобразования в тензор типа `torch.Tensor`. См. [__call__()](/docs/transformers/main/ru/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__)
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/main/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/main/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([ASTConfig](/docs/transformers/main/ru/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) и входных данных.
Метод forward класса [ASTModel](/docs/transformers/main/ru/model_doc/audio-spectrogram-transformer#transformers.ASTModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
## ASTForAudioClassification[[transformers.ASTForAudioClassification]]
#### transformers.ASTForAudioClassification[[transformers.ASTForAudioClassification]]
```python
transformers.ASTForAudioClassification(config: ASTConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L327)
**Параметры:**
config ([ASTConfig](/docs/transformers/main/ru/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Audio Spectrogram Transformer с головной частью для классификации аудио сверху (линейный слой поверх агрегированного вывода), например, для таких наборов данных, как AudioSet, Speech Commands v2.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.ASTForAudioClassification.forward]]
```python
forward(input_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L340)
**Параметры:**
input_values (`torch.Tensor` формы `(batch_size, max_length, num_mel_bins)`) : Значения типа float, представляющие мел-фичи, извлечённые из исходной аудиоволны. Исходную аудиоволну можно получить, загрузив аудиофайл `.flac` или `.wav` в массив типа `list[float]`, `numpy.ndarray` или `torch.Tensor`, *например*, с помощью библиотеки torchcodec (`pip install torchcodec`) или библиотеки soundfile (`pip install soundfile`). Для подготовки массива в `input_features` следует использовать [AutoFeatureExtractor](/docs/transformers/main/ru/model_doc/auto#transformers.AutoFeatureExtractor) для извлечения мел-фич, дополнения (padding) и преобразования в тензор типа `torch.Tensor`. См. [__call__()](/docs/transformers/main/ru/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__)
labels (`torch.LongTensor` формы `(batch_size,)`, *необязательный*) : Метки для вычисления функции потерь классификации/регрессии аудио. Индексы должны находиться в диапазоне `[0, ..., config.num_labels - 1]`. Если `config.num_labels == 1`, вычисляется функция потерь регрессии (среднеквадратичная ошибка), если `config.num_labels > 1` — функция потерь классификации (кросс-энтропия).
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
**Возвращает:** [SequenceClassifierOutput](/docs/transformers/main/ru/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) или `tuple(torch.Tensor)`
Объект [SequenceClassifierOutput](/docs/transformers/main/ru/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([ASTConfig](/docs/transformers/main/ru/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) и входных данных.
Метод forward класса [ASTForAudioClassification](/docs/transformers/main/ru/model_doc/audio-spectrogram-transformer#transformers.ASTForAudioClassification) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери классификации (или регрессии, если config.num_labels==1).
- **logits** (`torch.Tensor` формы `(batch_size, config.num_labels)`) — Оценки классификации (или регрессии, если config.num_labels==1) до применения SoftMax.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Пример:
```python
>>> from transformers import AutoFeatureExtractor, ASTForAudioClassification
>>> from datasets import load_dataset
>>> import torch
>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate
>>> feature_extractor = AutoFeatureExtractor.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
>>> model = ASTForAudioClassification.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
>>> # audio file is decoded on the fly
>>> inputs = feature_extractor(dataset[0]["audio"]["array"], sampling_rate=sampling_rate, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_class_ids = torch.argmax(logits, dim=-1).item()
>>> predicted_label = model.config.id2label[predicted_class_ids]
>>> predicted_label
...
>>> # compute loss - target_label is e.g. "down"
>>> target_label = model.config.id2label[0]
>>> inputs["labels"] = torch.tensor([model.config.label2id[target_label]])
>>> loss = model(**inputs).loss
>>> round(loss.item(), 2)
...
```