# TrOCR
[TrOCR](https://huggingface.co/papers/2109.10282)は、画像理解とテキスト生成の両方に対応するテキスト認識モデルです。画像処理や文字生成のために個別のモデルを必要としません。TrOCRは、transformerを用いて視覚的理解とテキスト生成を処理する、シンプルな単一のエンドツーエンドシステムです。
すべての元の TrOCR チェックポイントは、[Microsoft](https://huggingface.co/microsoft/models?search=trocr) 組織の下で確認できます。
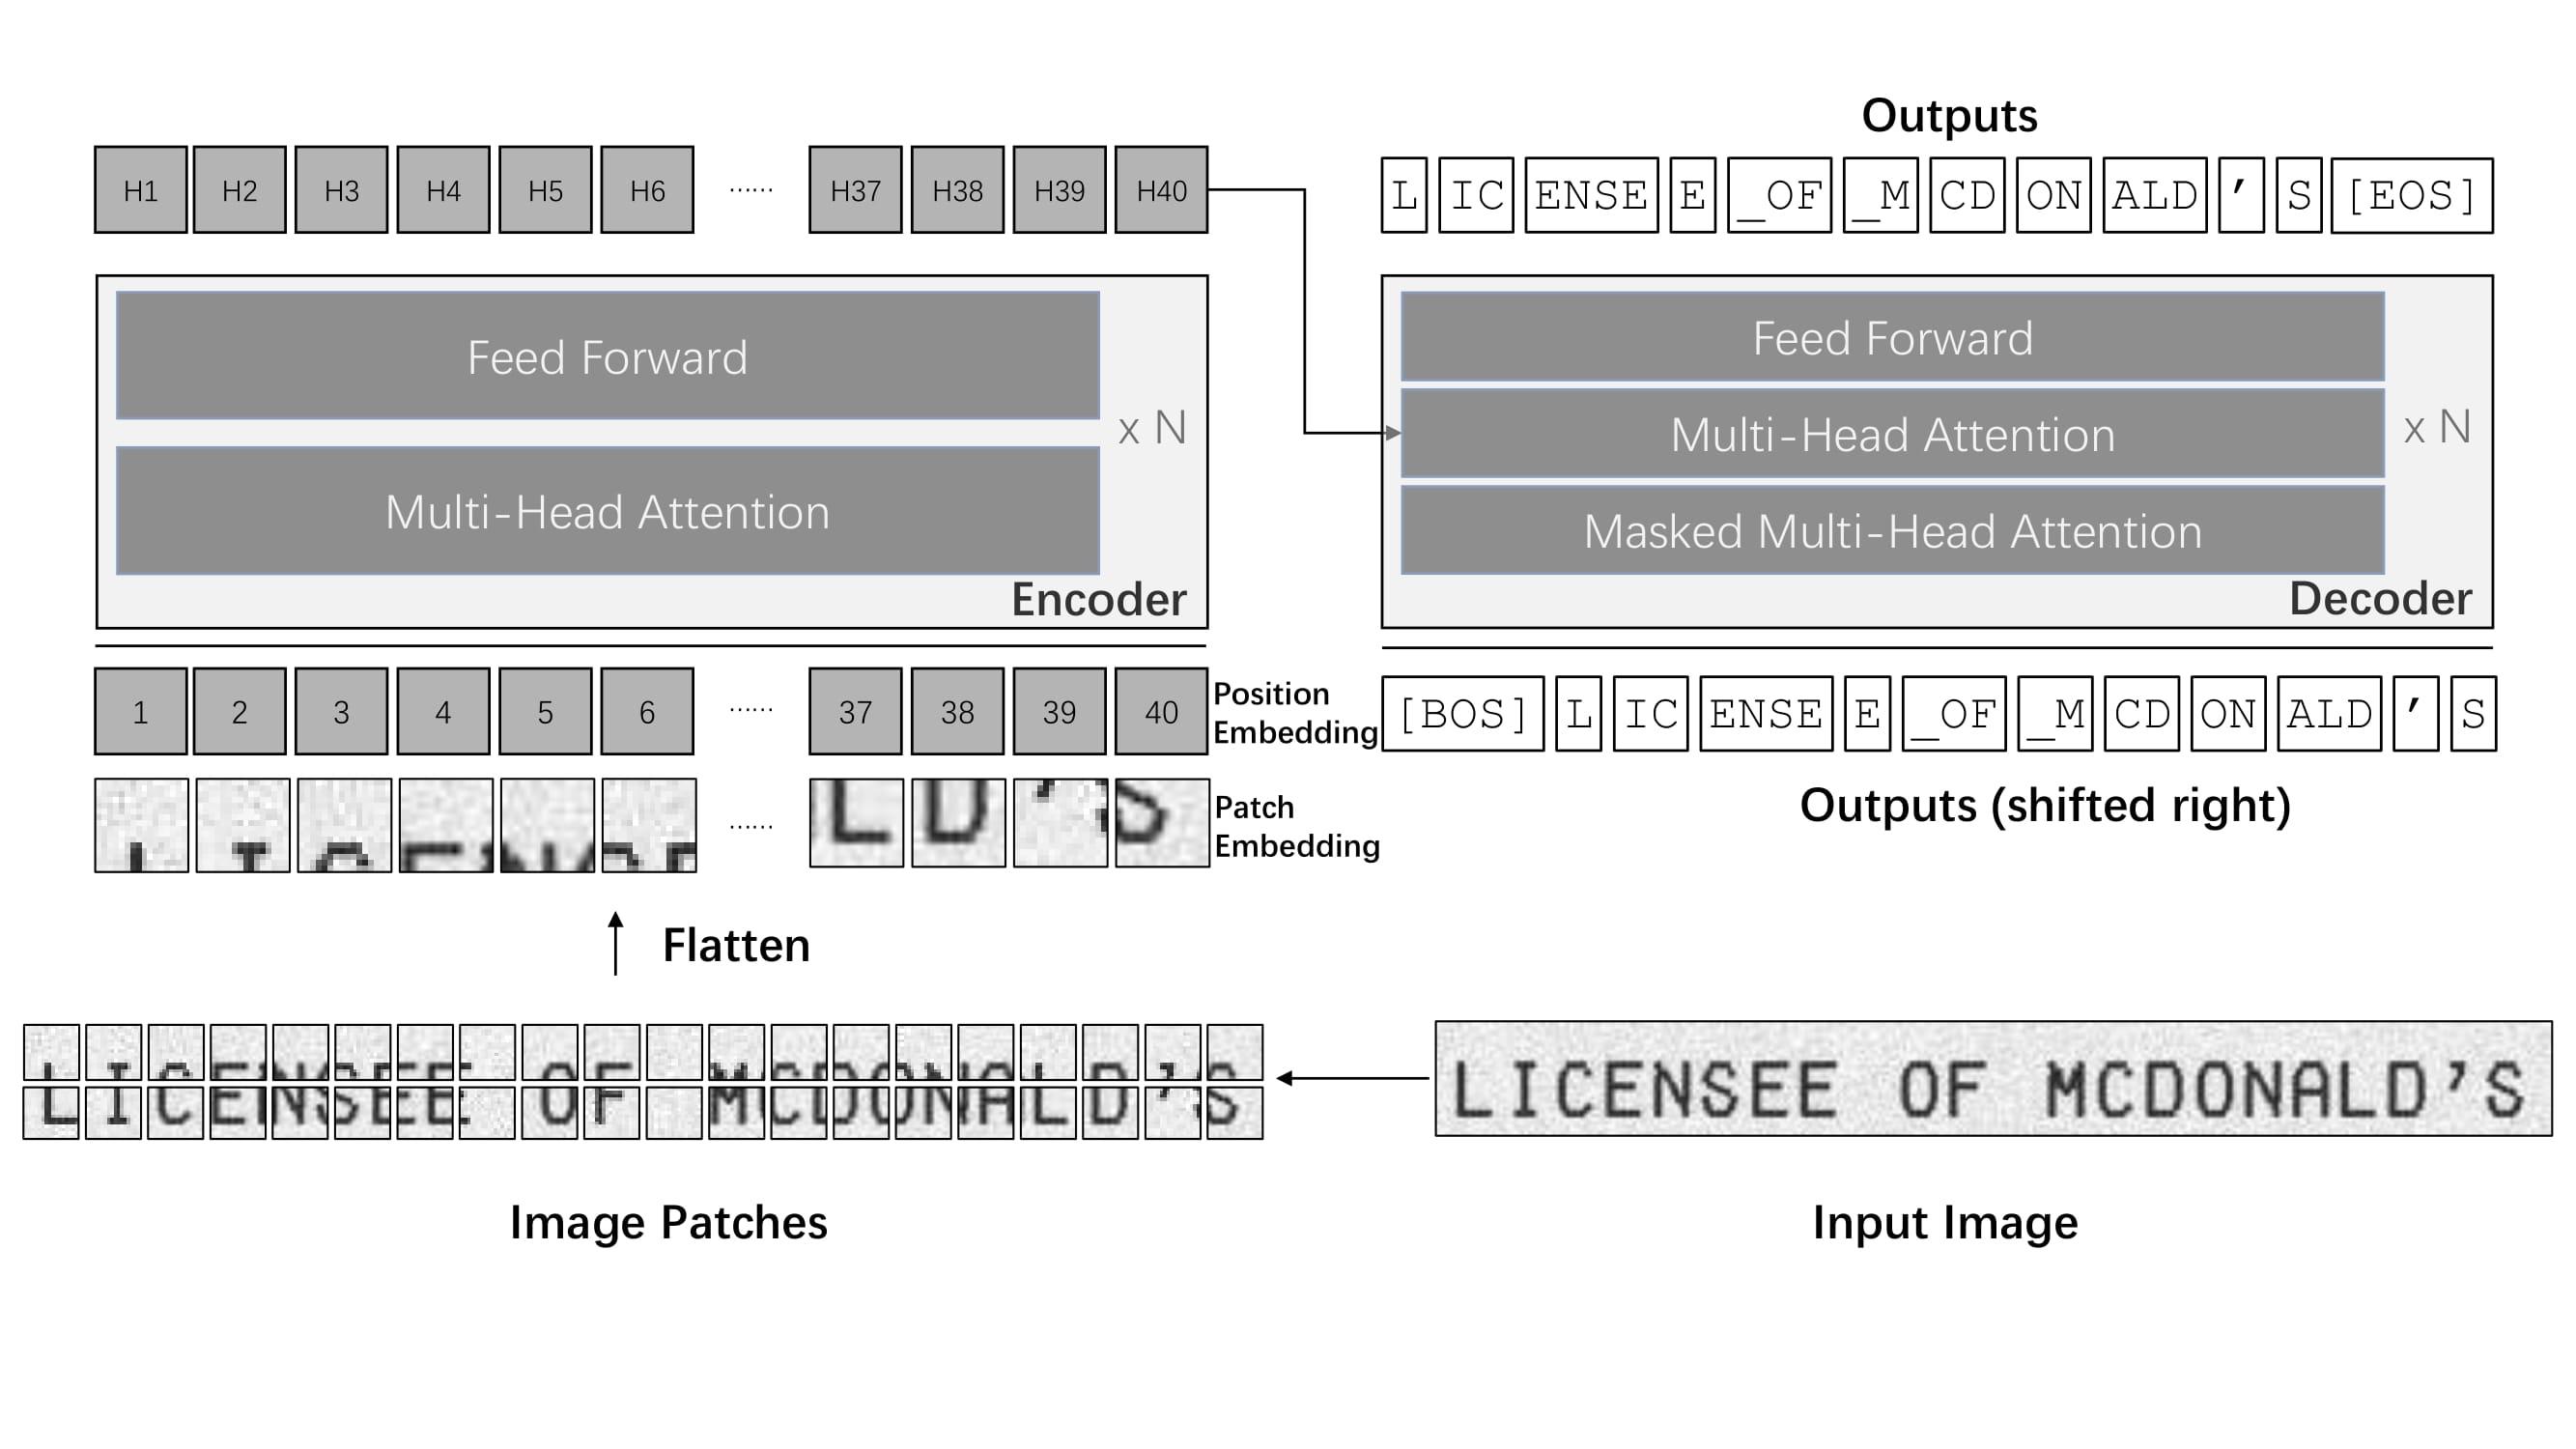 TrOCRのアーキテクチャ。元の論文から引用。
> [!TIP]
> このモデルは [nielsr](https://huggingface.co/nielsr) によって提供されました。
>
> TrOCR モデルの詳細については、右側のサイドバーをクリックしてください。画像やテキストの異なるタスクに TrOCR を適用する方法の例がさらに示されています。
以下の例では、[AutoModel](/docs/transformers/main/ja/model_doc/auto#transformers.AutoModel) クラスを使用して文字認識 (OCR) を実行する方法を示しています。
```python
import requests
from PIL import Image
from transformers import TrOCRProcessor, VisionEncoderDecoderModel
processor = TrOCRProcessor.from_pretrained("microsoft/trocr-base-handwritten")
model = VisionEncoderDecoderModel.from_pretrained("microsoft/trocr-base-handwritten", device_map="auto")
# load image from the IAM dataset
url = "https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
generated_ids = model.generate(pixel_values)
generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
print(generated_text)
```
## 量子化
Quantization は、重みを低精度で表現することで、大規模モデルのメモリ負荷を軽減します。利用可能な Quantization バックエンドの詳細については、[Quantization](../quantization/overview) の概要を参照してください。
以下の例では、[bitsandbytes](../quantization/bitsandbytes)を使用して重みを8ビットに量子化します。
```python
# pip install bitsandbytes accelerate
from transformers import TrOCRProcessor, VisionEncoderDecoderModel, BitsandBytesConfig
import requests
from PIL import Image
# Set up the quantization configuration
quantization_config = BitsandBytesConfig(load_in_8bit=True)
# Use a large checkpoint for a more noticeable impact
processor = TrOCRProcessor.from_pretrained("microsoft/trocr-large-handwritten")
model = VisionEncoderDecoderModel.from_pretrained(
"microsoft/trocr-large-handwritten",
quantization_config=quantization_config
device_map="auto")
# load image from the IAM dataset
url = "[https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg](https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg)"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
generated_ids = model.generate(pixel_values)
generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
print(generated_text)
```
## 注記
- TrOCR は、画像とテキストを処理するために、[ViTImageProcessor](/docs/transformers/main/ja/model_doc/vit#transformers.ViTImageProcessor)/[DeiTImageProcessor](/docs/transformers/main/ja/model_doc/deit#transformers.DeiTImageProcessor) と [RobertaTokenizer](/docs/transformers/main/ja/model_doc/led#transformers.RobertaTokenizer)/[XLMRobertaTokenizer](/docs/transformers/main/ja/model_doc/xlm-roberta#transformers.XLMRobertaTokenizer) を [TrOCRProcessor](/docs/transformers/main/ja/model_doc/trocr#transformers.TrOCRProcessor) の単一のインスタンスにまとめます。
- TrOCR は常に [VisionEncoderDecoder](vision-encoder-decoder) フレームワーク内で使用されます。
## リソース
- TrOCRによる[ドキュメントAIの高速化](https://huggingface.co/blog/document-ai)に関するブログ記事。
- [Document AI](https://github.com/philschmid/document-ai-transformers)をTrOCRで実現する方法に関するブログ記事。
- [Seq2SeqTrainer](https://colab.research.google.com/github/NielsRogge/Transformers-Tutorials/blob/master/TrOCR/Fine_tune_TrOCR_on_IAM_Handwriting_Database_using_Seq2SeqTrainer.ipynb)を使用してIAM Handwriting DatabaseでTrOCRをファインチューニングする方法を示すノートブック。
- [TrOCR 手書き文字認識](https://huggingface.co/spaces/nielsr/TrOCR-handwritten)のインタラクティブデモです。
- [TrOCR による推論](https://colab.research.google.com/github/NielsRogge/Transformers-Tutorials/blob/master/TrOCR/Inference_with_TrOCR_%2B_Gradio_demo.ipynb)に関するノートブックと Gradio デモ。
- [IAMテストセットでのTrOCRの評価](https://colab.research.google.com/github/NielsRogge/Transformers-Tutorials/blob/master/TrOCR/Evaluating_TrOCR_base_handwritten_on_the_IAM_test_set.ipynb)に関するノートブック。
## TrOCRConfig[[transformers.TrOCRConfig]]
#### transformers.TrOCRConfig[[transformers.TrOCRConfig]]
```python
transformers.TrOCRConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 50265, d_model: int = 1024, decoder_layers: int = 12, decoder_attention_heads: int = 16, decoder_ffn_dim: int = 4096, activation_function: str = 'gelu', max_position_embeddings: int = 512, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, decoder_start_token_id: int = 2, init_std: float = 0.02, decoder_layerdrop: float | int = 0.0, use_cache: bool = True, scale_embedding: bool = False, use_learned_position_embeddings: bool = True, layernorm_embedding: bool = True, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, cross_attention_hidden_size: int | None = None, is_decoder: bool = False, tie_word_embeddings: bool = True)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/configuration_trocr.py#L24)
**パラメータ:**
vocab_size (`int`、*任意*、デフォルトは`50265`) : モデルの語彙サイズ。`input_ids`で表現できるトークンの種類数を定義します。
d_model (`int`、*任意*、デフォルトは`1024`) : エンコーダ層とプーラー層のサイズ。
decoder_layers (`int`、*任意*、デフォルトは`12`) : Transformer デコーダーの隠れ層の数。設定されていない場合は、`num_layers` と同じ値が使用されます。
decoder_attention_heads (`int`、*任意*、デフォルトは`16`) : Transformerデコーダーの各アテンション層におけるアテンションヘッドの数。
decoder_ffn_dim (`int`、*任意*、デフォルトは `4096`) : デコーダー内の「intermediate」(feed-forward と呼ばれることが多い)層の次元数。
activation_function (`str`、*任意*、デフォルトは`gelu`) : デコーダーで使用する非線形活性化関数(関数または文字列)。例えば、`"gelu"`、`"relu"`、`"silu"`など。
max_position_embeddings (`int`、*任意*、デフォルトは`512`) : このモデルが使用される可能性のある最大シーケンス長。
dropout (`Union[float, int]`、*任意*、デフォルトは`0.1`) : すべての dropout 層の比率。
attention_dropout (`Union[float, int]`、*任意*、デフォルトは`0.0`) : 注意確率のドロップアウト率。
activation_dropout (`Union[float, int]`、*任意*、デフォルトは`0.0`) : 全結合層内の活性化に対する dropout 率。
decoder_start_token_id (`int`、*optional*、デフォルトは`2`) : エンコーダーデコーダーモデルが`bos`以外のトークンでデコーディングを開始する場合、そのトークンのID。
init_std (`float`、*任意*、デフォルトは`0.02`) : すべての重み行列を初期化するためのtruncated_normal_initializerの標準偏差です。
decoder_layerdrop (`Union[float, int]`、*任意*、デフォルトは`0.0`) : デコーダーの LayerDrop 確率です。詳細については、[LayerDrop の論文](see https://huggingface.co/papers/1909.11556)を参照してください。
use_cache (`bool`、*任意*、デフォルトは `True`) : モデルが最後のキー/バリューアテンションを返すかどうか(すべてのモデルで利用されるわけではありません)。`config.is_decoder=True` の場合、またはモデルがデコーダー専用の生成モデルである場合にのみ関連します。
scale_embedding (`bool`、*任意*、デフォルトは`False`) : sqrt(d_model) で割って埋め込みをスケーリングするかどうか。
use_learned_position_embeddings (`bool`、*任意*、デフォルトは`True`) : 学習された位置埋め込みを使用するかどうか。使用しない場合、正弦波位置埋め込みが使用されます。
layernorm_embedding (`bool`、*任意*、デフォルトは`True`) : ワード埋め込みと位置埋め込みの後にLayerNormを使用するかどうか。
pad_token_id (`int`, *任意*, デフォルトは `1`) : 語彙内でパディングに使用されるトークン ID。
bos_token_id (`int`, *optional*, デフォルトは `0`) : 語彙内でストリームの開始に使用されるトークン ID。
eos_token_id (`Union[int, list[int]]`、*任意*、デフォルトは`2`) : 語彙内でストリーム終了に使用されるトークン ID。
cross_attention_hidden_size (`int`, *optional*) : エンコーダーの出力の隠れ層サイズを、デコーダーのクロスアテンションのキー/バリュー空間に射影したサイズ。エンコーダーとデコーダーの隠れ層サイズが異なる場合に使用します。
is_decoder (`bool`, *任意*, デフォルトは `False`) : モデルがデコーダーとして使用されるかどうかを指定します。`False` の場合、モデルはエンコーダーとして使用されます。
tie_word_embeddings (`bool`、*任意*、デフォルトは`True`) : モデルの`tied_weights_keys`マッピングに従って重み埋め込みを共有するかどうか。
これは TrocrModel の設定を保存するための設定クラスです。指定された引数に基づいて Trocr モデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、[microsoft/trocr-base-handwritten](https://huggingface.co/microsoft/trocr-base-handwritten) と同様の設定が得られます。
設定オブジェクトは [PreTrainedConfig](/docs/transformers/main/ja/main_classes/configuration#transformers.PreTrainedConfig) を継承し、モデルの出力を制御するために使用できます。詳細については、[PreTrainedConfig](/docs/transformers/main/ja/main_classes/configuration#transformers.PreTrainedConfig) のドキュメントを参照してください。
例:
```python
>>> from transformers import TrOCRConfig, TrOCRForCausalLM
>>> # Initializing a TrOCR-base style configuration
>>> configuration = TrOCRConfig()
>>> # Initializing a model (with random weights) from the TrOCR-base style configuration
>>> model = TrOCRForCausalLM(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## TrOCRProcessor[[transformers.TrOCRProcessor]]
#### transformers.TrOCRProcessor[[transformers.TrOCRProcessor]]
```python
transformers.TrOCRProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/processing_trocr.py#L27)
**パラメータ:**
image_processor (`ViTImageProcessor`) : 画像プロセッサは必須の入力です。
tokenizer (`XLMRobertaTokenizer`) : トークナイザーは必須の入力です。
TrOCRProcessorを構築し、画像プロセッサとトークナイザーを単一のプロセッサにラップします。
[TrOCRProcessor](/docs/transformers/main/ja/model_doc/trocr#transformers.TrOCRProcessor) は、[ViTImageProcessor](/docs/transformers/main/ja/model_doc/vit#transformers.ViTImageProcessor) と [XLMRobertaTokenizer](/docs/transformers/main/ja/model_doc/xlm-roberta#transformers.XLMRobertaTokenizer) のすべての機能を提供します。詳細については、[~ViTImageProcessor](/docs/transformers/main/ja/model_doc/vit#transformers.ViTImageProcessor) および [~XLMRobertaTokenizer](/docs/transformers/main/ja/model_doc/xlm-roberta#transformers.XLMRobertaTokenizer) を参照してください。
#### __call__[[transformers.TrOCRProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/processing_trocr.py#L31)
**パラメータ:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *任意*) : 前処理を行う画像。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチの画像を想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、`do_rescale=False` を設定してください。
text (`Union[str, list[str], list[list[str]]]`、*任意*) : エンコード対象のシーケンスまたはシーケンスのバッチです。各シーケンスは文字列、または文字列のリスト(プレトークナイズ済み文字列)であることができます。プレトークナイズ済み入力を渡す場合は、バッチ入力との曖昧さを避けるために `is_split_into_words=True` を設定してください。
return_mm_token_type_ids (`bool`, *kwargs*) : マルチモーダルプレースホルダトークンの位置を示すマルチモーダルトークンタイプIDを返すかどうか。
return_text_replacement_offsets (`bool`, *kwargs*) : 各マルチモーダルプレースホルダーとその置換文字列の文字オフセットを返すかどうか。
return_tensors (`str` または [TensorType](/docs/transformers/main/ja/internal/file_utils#transformers.TensorType)、*optional*) : 設定されている場合、特定のフレームワークのテンソルを返します。受け入れ可能な値は以下の通りです: - `'pt'`: PyTorch の `torch.Tensor` オブジェクトを返します。 - `'np'`: NumPy の `np.ndarray` オブジェクトを返します。
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/ja/main_classes/processors#transformers.ProcessingKwargs), *optional*) : 各モダリティ(テキスト、画像、動画、音声)の追加処理オプション。モデル固有のパラメータは上記にリストされています。サポートされている引数の完全なリストについては、TypedDict クラスを参照してください。
**戻り値:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ メソッドによって返されるリスト/配列/テンソルの辞書('pixel_values' など)。
- **tensor_type** (`Union[None, str, TensorType]`、*省略可*) -- 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
#### from_pretrained[[transformers.TrOCRProcessor.from_pretrained]]
```python
from_pretrained(pretrained_model_name_or_path: str | os.PathLike, cache_dir: str | os.PathLike | None = None, force_download: bool = False, local_files_only: bool = False, token: str | bool | None = None, revision: str = 'main', **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1799)
**パラメータ:**
pretrained_model_name_or_path (`str` または `os.PathLike`) : 以下のいずれかです: - huggingface.co のモデルリポジトリにホストされている事前学習済み feature_extractor の *model id* を示す文字列。 - [save_pretrained()](/docs/transformers/main/ja/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) メソッドを使用して feature extractor ファイルを保存した *ディレクトリ* へのパス。例: `./my_model_directory/`。 - 保存された feature extractor の JSON *ファイル* へのパス。例: `./my_model_directory/preprocessor_config.json`。
- ****kwargs** : [from_pretrained()](/docs/transformers/main/ja/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) と `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained` の両方に渡される追加のキーワード引数。
事前学習済みモデルに関連付けられたプロセッサをインスタンス化します。
このクラスメソッドは、単にフィーチャーエクストラクターの [from_pretrained()](/docs/transformers/main/ja/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained)、イメージプロセッサーの [ImageProcessingMixin](/docs/transformers/main/ja/internal/image_processing_utils#transformers.ImageProcessingMixin)、およびトークナイザーの `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained` メソッドを呼び出しています。詳細については、上記のメソッドのドキュメント文字列を参照してください。
#### save_pretrained[[transformers.TrOCRProcessor.save_pretrained]]
```python
save_pretrained(save_directory, push_to_hub: bool = False, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1182)
**パラメータ:**
save_directory (`str` または `os.PathLike`) : 特徴量抽出器の JSON ファイルとトークナイザーのファイルを保存するディレクトリ(存在しない場合は作成されます)。
push_to_hub (`bool`、*任意*、デフォルトは`False`) : モデルを保存した後、Hugging Face モデルハブにプッシュするかどうかを指定します。プッシュ先のリポジトリは`repo_id`で指定できます(指定しない場合、`save_directory`の名前があなたのネームスペース内でデフォルトとして使用されます)。
kwargs (`dict[str, Any]`、*省略可*) : [push_to_hub()](/docs/transformers/main/ja/main_classes/model#transformers.utils.PushToHubMixin.push_to_hub) メソッドに渡される追加のキーワード引数。
このプロセッサ(フィーチャーエクストラクター、トークナイザーなど)の属性を指定されたディレクトリに保存し、[from_pretrained()](/docs/transformers/main/ja/model_doc/wav2vec2#transformers.Wav2Vec2Processor.from_pretrained) メソッドによって再読み込みできるようにします。
このクラスメソッドは、[save_pretrained()](/docs/transformers/main/ja/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained)と[save_pretrained()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.save_pretrained)を呼び出すだけです。詳細については、上記のメソッドのドキュメント文字列を参照してください。
#### batch_decode[[transformers.TrOCRProcessor.batch_decode]]
```python
batch_decode(*args, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L2054)
このメソッドは、すべての引数を PreTrainedTokenizer の [batch_decode()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.batch_decode) に転送します。詳細については、このメソッドのドキュメント文字列を参照してください。
#### decode[[transformers.TrOCRProcessor.decode]]
```python
decode(*args, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L2063)
このメソッドは、すべての引数を PreTrainedTokenizer の [decode()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.decode) に転送します。詳細については、このメソッドのドキュメント文字列を参照してください。
## TrOCRForCausalLM[[transformers.TrOCRForCausalLM]]
#### transformers.TrOCRForCausalLM[[transformers.TrOCRForCausalLM]]
```python
transformers.TrOCRForCausalLM(config: TrOCRConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/modeling_trocr.py#L641)
**パラメータ:**
config ([TrOCRConfig](/docs/transformers/main/ja/model_doc/trocr#transformers.TrOCRConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを確認してください。
言語モデリングヘッドを備えた TrOCR デコーダー。[EncoderDecoderModel](/docs/transformers/main/ja/model_doc/encoder-decoder#transformers.EncoderDecoderModel) のデコーダー部分として使用でき、
このモデルは [PreTrainedModel](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.TrOCRForCausalLM.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.LongTensor] = None, cache: transformers.cache_utils.Cache | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/trocr/modeling_trocr.py#L667)
**パラメータ:**
input_ids (`torch.LongTensor`、shape `(batch_size, sequence_length)`、*任意*) : 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスは [AutoTokenizer](/docs/transformers/main/ja/model_doc/auto#transformers.AutoTokenizer) を使用して取得できます。詳細については、[PreTrainedTokenizer.encode()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) および [PreTrainedTokenizer.__call__()](/docs/transformers/main/ja/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) を参照してください。 [入力IDとは何ですか?](../glossary#input-ids)
attention_mask (`torch.Tensor`、shape `(batch_size, sequence_length)`、*任意*) : padding トークンのインデックスに対する attention を回避するためのマスクです。マスクの値は `[0, 1]` から選択されます: - **マスクされない**トークンは 1、- **マスクされる**トークンは 0。 [attention マスクとは?](../glossary#attention-mask)
encoder_hidden_states (`torch.Tensor`、形状 `(batch_size, sequence_length, hidden_size)`、*任意*) : エンコーダーの最終層の出力における隠れ状態のシーケンス。モデルがデコーダーとして設定されている場合、クロスアテンションで使用されます。
encoder_attention_mask (`torch.LongTensor`、形状 `(batch_size, sequence_length)`、*任意*) : エンコーダー入力のパディングトークンインデックスに対するアテンションの適用を回避するためのマスクです。モデルがデコーダーとして設定されている場合、このマスクはクロスアテンションで使用されます。`[0, 1]` から選択されるマスクの値: - **マスクされていない**トークンは 1、- **マスクされている**トークンは 0。
cache (`~cache_utils.Cache`, *任意*) : 逐次的なデコーディングを高速化するために使用できる、事前計算された隠れ状態(自己注意ブロックおよび相互注意ブロック内のキーとバリュー)です。通常、`use_cache=True` または `config.use_cache=True` の場合、デコーディングの以前の段階でモデルが返した `cache` になります。入力として許可されるのは [Cache](/docs/transformers/main/ja/internal/generation_utils#transformers.Cache) インスタンスのみです。[kv cache ガイド](https://huggingface.co/docs/transformers/en/kv_cache) を参照してください。`cache` が渡されない場合、デフォルトで [DynamicCache](/docs/transformers/main/ja/internal/generation_utils#transformers.DynamicCache) が初期化されます。モデルは、入力として与えられたのと同じキャッシュ形式を出力します。`cache` を使用する場合、ユーザーは、このモデルに過去のキーバリュー状態が与えられていない未処理の `input_ids` のみを、`(batch_size, sequence_length)` の形状を持つすべての `input_ids` の代わりに、`(batch_size, unprocessed_length)` の形状で入力することが期待されます。
inputs_embeds (`torch.Tensor`、shape `(batch_size, sequence_length, hidden_size)`、*任意*) : `input_ids` を渡す代わりに、埋め込み表現を直接渡すこともできます。これは、モデル内部の埋め込み参照行列よりも、`input_ids` のインデックスを対応するベクトルに変換する方法をより細かく制御したい場合に有用です。
labels (`torch.LongTensor`、形状 `(batch_size, sequence_length)`、*任意*) : 言語モデリング損失の計算に使用するラベル。インデックスは `[0, ..., config.vocab_size]` の範囲内、または -100 である必要があります(`input_ids` のドキュメント文字列を参照)。インデックスが `-100` に設定されたトークンは無視(マスク)され、損失は `[0, ..., config.vocab_size]` の範囲内のラベルを持つトークンに対してのみ計算されます。モデル内部ではラベルは**シフトされません**。`labels[..., i]` は `logits[..., i, :]` のターゲットとなるため、次のトークン予測を行う場合は、ラベルは `input_ids` に対して既に 1 位置左にシフトされている必要があります。
use_cache (`bool`, *任意*) : `True`に設定すると、`cache`のキーとバリューの状態が返され、デコーディングの高速化に使用できます(`cache`を参照)。
output_attentions (`bool`, *任意*) : すべてのアテンション層のアテンションテンソルを返すかどうか。詳細は、返されるテンソルの `attentions` を参照してください。
output_hidden_states (`bool`, *任意*) : 全レイヤーの hidden states を返すかどうかを指定します。詳細は、返されるテンソルの `hidden_states` を参照してください。
return_dict (`bool`, *任意*) : プレーンなタプルではなく [ModelOutput](/docs/transformers/main/ja/main_classes/output#transformers.utils.ModelOutput) を返すかどうか。
**戻り値:** [CausalLMOutputWithCrossAttentions](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) または `tuple(torch.Tensor)`
`None` や入力に応じて、さまざまな要素で構成される、[CausalLMOutputWithCrossAttentions](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) または `torch.Tensor` のタプル(`return_dict=False` が渡された場合、または `config.return_dict=False` の場合)。
[TrOCRForCausalLM](/docs/transformers/main/ja/model_doc/trocr#transformers.TrOCRForCausalLM)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **loss** (`torch.Tensor`、形状 `(1,)`、*任意*、`labels` が指定された場合に返されます) -- 言語モデリングの損失(次のトークンの予測用)。
- **logits** (`torch.Tensor`、形状 `(batch_size, sequence_length, config.vocab_size)`) -- 言語モデリングヘッドの予測スコア(SoftMax 適用前の各語彙トークンのスコア)。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
- **attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
- **cross_attentions** (`tuple(torch.Tensor)`、*optional*、`output_attentions=True` が渡された場合または `config.output_attentions=True` の場合に返されます) -- `torch.Tensor` のタプル(各レイヤーごとに1つ)、形状は `(batch_size, num_heads, sequence_length, sequence_length)`。
クロスアテンションのsoftmax後の重み。クロスアテンションヘッドにおける加重平均の計算に使用されます。
- **cache** (`Cache`、*任意*、`use_cache=True` が渡された場合または `config.use_cache=True` の場合に返されます) -- [Cache](/docs/transformers/main/ja/internal/generation_utils#transformers.Cache) のインスタンスです。詳細については、[kv cache ガイド](https://huggingface.co/docs/transformers/en/kv_cache)を参照してください。
シーケンシャルなデコーディングを高速化するために使用できる(`cache` 入力参照)、事前計算済みの隠れ状態(アテンションブロック内のキーとバリュー)が含まれています。
例:
```python
>>> from transformers import (
... TrOCRConfig,
... TrOCRProcessor,
... TrOCRForCausalLM,
... ViTConfig,
... ViTModel,
... VisionEncoderDecoderModel,
... )
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> # TrOCR is a decoder model and should be used within a VisionEncoderDecoderModel
>>> # init vision2text model with random weights
>>> encoder = ViTModel(ViTConfig())
>>> decoder = TrOCRForCausalLM(TrOCRConfig())
>>> model = VisionEncoderDecoderModel(encoder=encoder, decoder=decoder)
>>> # If you want to start from the pretrained model, load the checkpoint with `VisionEncoderDecoderModel`
>>> processor = TrOCRProcessor.from_pretrained("microsoft/trocr-base-handwritten")
>>> model = VisionEncoderDecoderModel.from_pretrained("microsoft/trocr-base-handwritten")
>>> # load image from the IAM dataset
>>> url = "https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> pixel_values = processor(image, return_tensors="pt").pixel_values
>>> text = "industry, ' Mr. Brown commented icily. ' Let us have a"
>>> # training
>>> model.config.decoder_start_token_id = processor.tokenizer.eos_token_id
>>> model.config.pad_token_id = processor.tokenizer.pad_token_id
>>> model.config.vocab_size = model.config.decoder.vocab_size
>>> labels = processor.tokenizer(text, return_tensors="pt").input_ids
>>> outputs = model(pixel_values, labels=labels)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
5.30
>>> # inference
>>> generated_ids = model.generate(pixel_values)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
>>> generated_text
'industry, " Mr. Brown commented icily. " Let us have a'
```