# BEiT
## Ikhtisar
Model BEiT diusulkan dalam [BEiT: BERT Pre-Training of Image Transformers](https://huggingface.co/papers/2106.08254) oleh Hangbo Bao, Li Dong, dan Furu Wei. Terinspirasi oleh BERT, BEiT adalah makalah pertama yang membuat pre-training self-supervised dari Vision Transformers (ViTs) melampaui pre-training supervised. Alih-alih pre-training model untuk memprediksi kelas dari sebuah gambar (seperti yang dilakukan dalam [makalah ViT asli](https://huggingface.co/papers/2010.11929)), model BEiT di-pre-train untuk memprediksi visual tokens dari codebook model [DALL-E](https://huggingface.co/papers/2102.12092) milik OpenAI berdasarkan patch yang di-mask.
Abstrak dari makalah tersebut adalah sebagai berikut:
*Kami memperkenalkan model representasi visual self-supervised BEiT, yang merupakan singkatan dari Bidirectional Encoder representation from Image Transformers. Mengikuti BERT yang dikembangkan di bidang pemrosesan bahasa alami, kami mengusulkan tugas pemodelan gambar ber-mask untuk melatih awal (pretrain) vision Transformers. Secara spesifik, setiap gambar memiliki dua tampilan dalam pre-training kami, yaitu patch gambar (misalnya 16x16 piksel), dan token visual (yaitu, token diskrit). Pertama, kami "men-tokenisasi" gambar asli menjadi token visual. Kemudian, kami secara acak mem-mask beberapa patch gambar dan memasukkannya ke dalam backbone Transformer. Tujuan pre-training adalah untuk memulihkan token visual asli berdasarkan patch gambar yang rusak. Setelah pre-training BEiT, kami langsung melakukan fine-tuning parameter model pada tugas turunan (downstream tasks) dengan menambahkan lapisan tugas di atas encoder yang telah dilatih awal. Hasil eksperimen pada klasifikasi gambar dan segmentasi semantik menunjukkan bahwa model kami mencapai hasil yang kompetitif dengan metode pre-training sebelumnya. Misalnya, BEiT berukuran base mencapai akurasi top-1 83,2% pada ImageNet-1K, yang secara signifikan melampaui pelatihan DeiT dari nol (81,8%) dengan setup yang sama. Selain itu, BEiT berukuran large memperoleh 86,3% hanya menggunakan ImageNet-1K, bahkan melampaui ViT-L dengan pre-training supervised pada ImageNet-22K (85,2%).*
Model ini disumbangkan oleh [nielsr](https://huggingface.co/nielsr). Kode aslinya dapat ditemukan [di sini](https://github.com/microsoft/unilm/tree/master/beit).
## Tips penggunaan
- Model BEiT adalah Vision Transformer reguler, tetapi dilatih secara pra-pelatihan dengan cara self-supervised, bukan supervised. Model ini melampaui kinerja [model asli (ViT)](vit) maupun [Data-efficient Image Transformers (DeiT)](deit) saat di-fine-tune pada ImageNet-1K dan CIFAR-100. Anda dapat melihat notebook demo terkait inferensi serta fine-tuning pada data kustom [di sini](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/VisionTransformer) (Anda cukup mengganti [ViTImageProcessor](/docs/transformers/main/id/model_doc/vit#transformers.ViTImageProcessor) dengan [BeitImageProcessor](/docs/transformers/main/id/model_doc/beit#transformers.BeitImageProcessor) dan [ViTForImageClassification](/docs/transformers/main/id/model_doc/vit#transformers.ViTForImageClassification) dengan [BeitForImageClassification](/docs/transformers/main/id/model_doc/beit#transformers.BeitForImageClassification)).
- Tersedia juga notebook demo yang menunjukkan cara menggabungkan tokenizer gambar DALL-E dengan BEiT untuk melakukan pemodelan gambar tersembunyi (masked image modeling). Anda dapat menemukannya di [sini](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/BEiT).
- Karena model BEiT mengharapkan setiap gambar memiliki ukuran (resolusi) yang sama, Anda dapat menggunakan [BeitImageProcessor](/docs/transformers/main/id/model_doc/beit#transformers.BeitImageProcessor) untuk mengubah ukuran (atau skala) dan menormalisasi gambar untuk model.
- Resolusi patch dan resolusi gambar yang digunakan selama pra-pelatihan atau penyesuaian halus sama-sama tercermin dalam nama setiap checkpoint. Sebagai contoh, `microsoft/beit-base-patch16-224` merujuk pada arsitektur berukuran dasar dengan resolusi patch 16x16 dan resolusi penyesuaian halus 224x224. Semua checkpoint dapat ditemukan di [hub](https://huggingface.co/models?search=microsoft/beit).
- Checkpoint yang tersedia adalah (1) hanya pre-trained pada [ImageNet-22k](http://www.image-net.org/) (kumpulan 14 juta gambar dan 22k kelas), (2) juga fine-tuned pada ImageNet-22k, atau (3) juga fine-tuned pada [ImageNet-1k](http://www.image-net.org/challenges/LSVRC/2012/) (juga disebut ILSVRC 2012, kumpulan 1,3 juta gambar dan 1.000 kelas).
- BEiT menggunakan penanam posisi relatif, terinspirasi dari model T5. Selama pra-pelatihan, para penulis membagikan bias posisi relatif di antara beberapa lapisan self-attention. Selama penyesuaian halus, bias posisi relatif dari setiap lapisan diinisialisasi dengan bias posisi relatif bersama yang diperoleh setelah pra-pelatihan. Perhatikan bahwa, jika seseorang ingin melatih ulang model dari awal, seseorang perlu mengatur atribut `use_relative_position_bias` atau `use_relative_position_bias` dari [BeitConfig](/docs/transformers/main/id/model_doc/beit#transformers.BeitConfig) menjadi `True` untuk menambahkan penanam posisi.
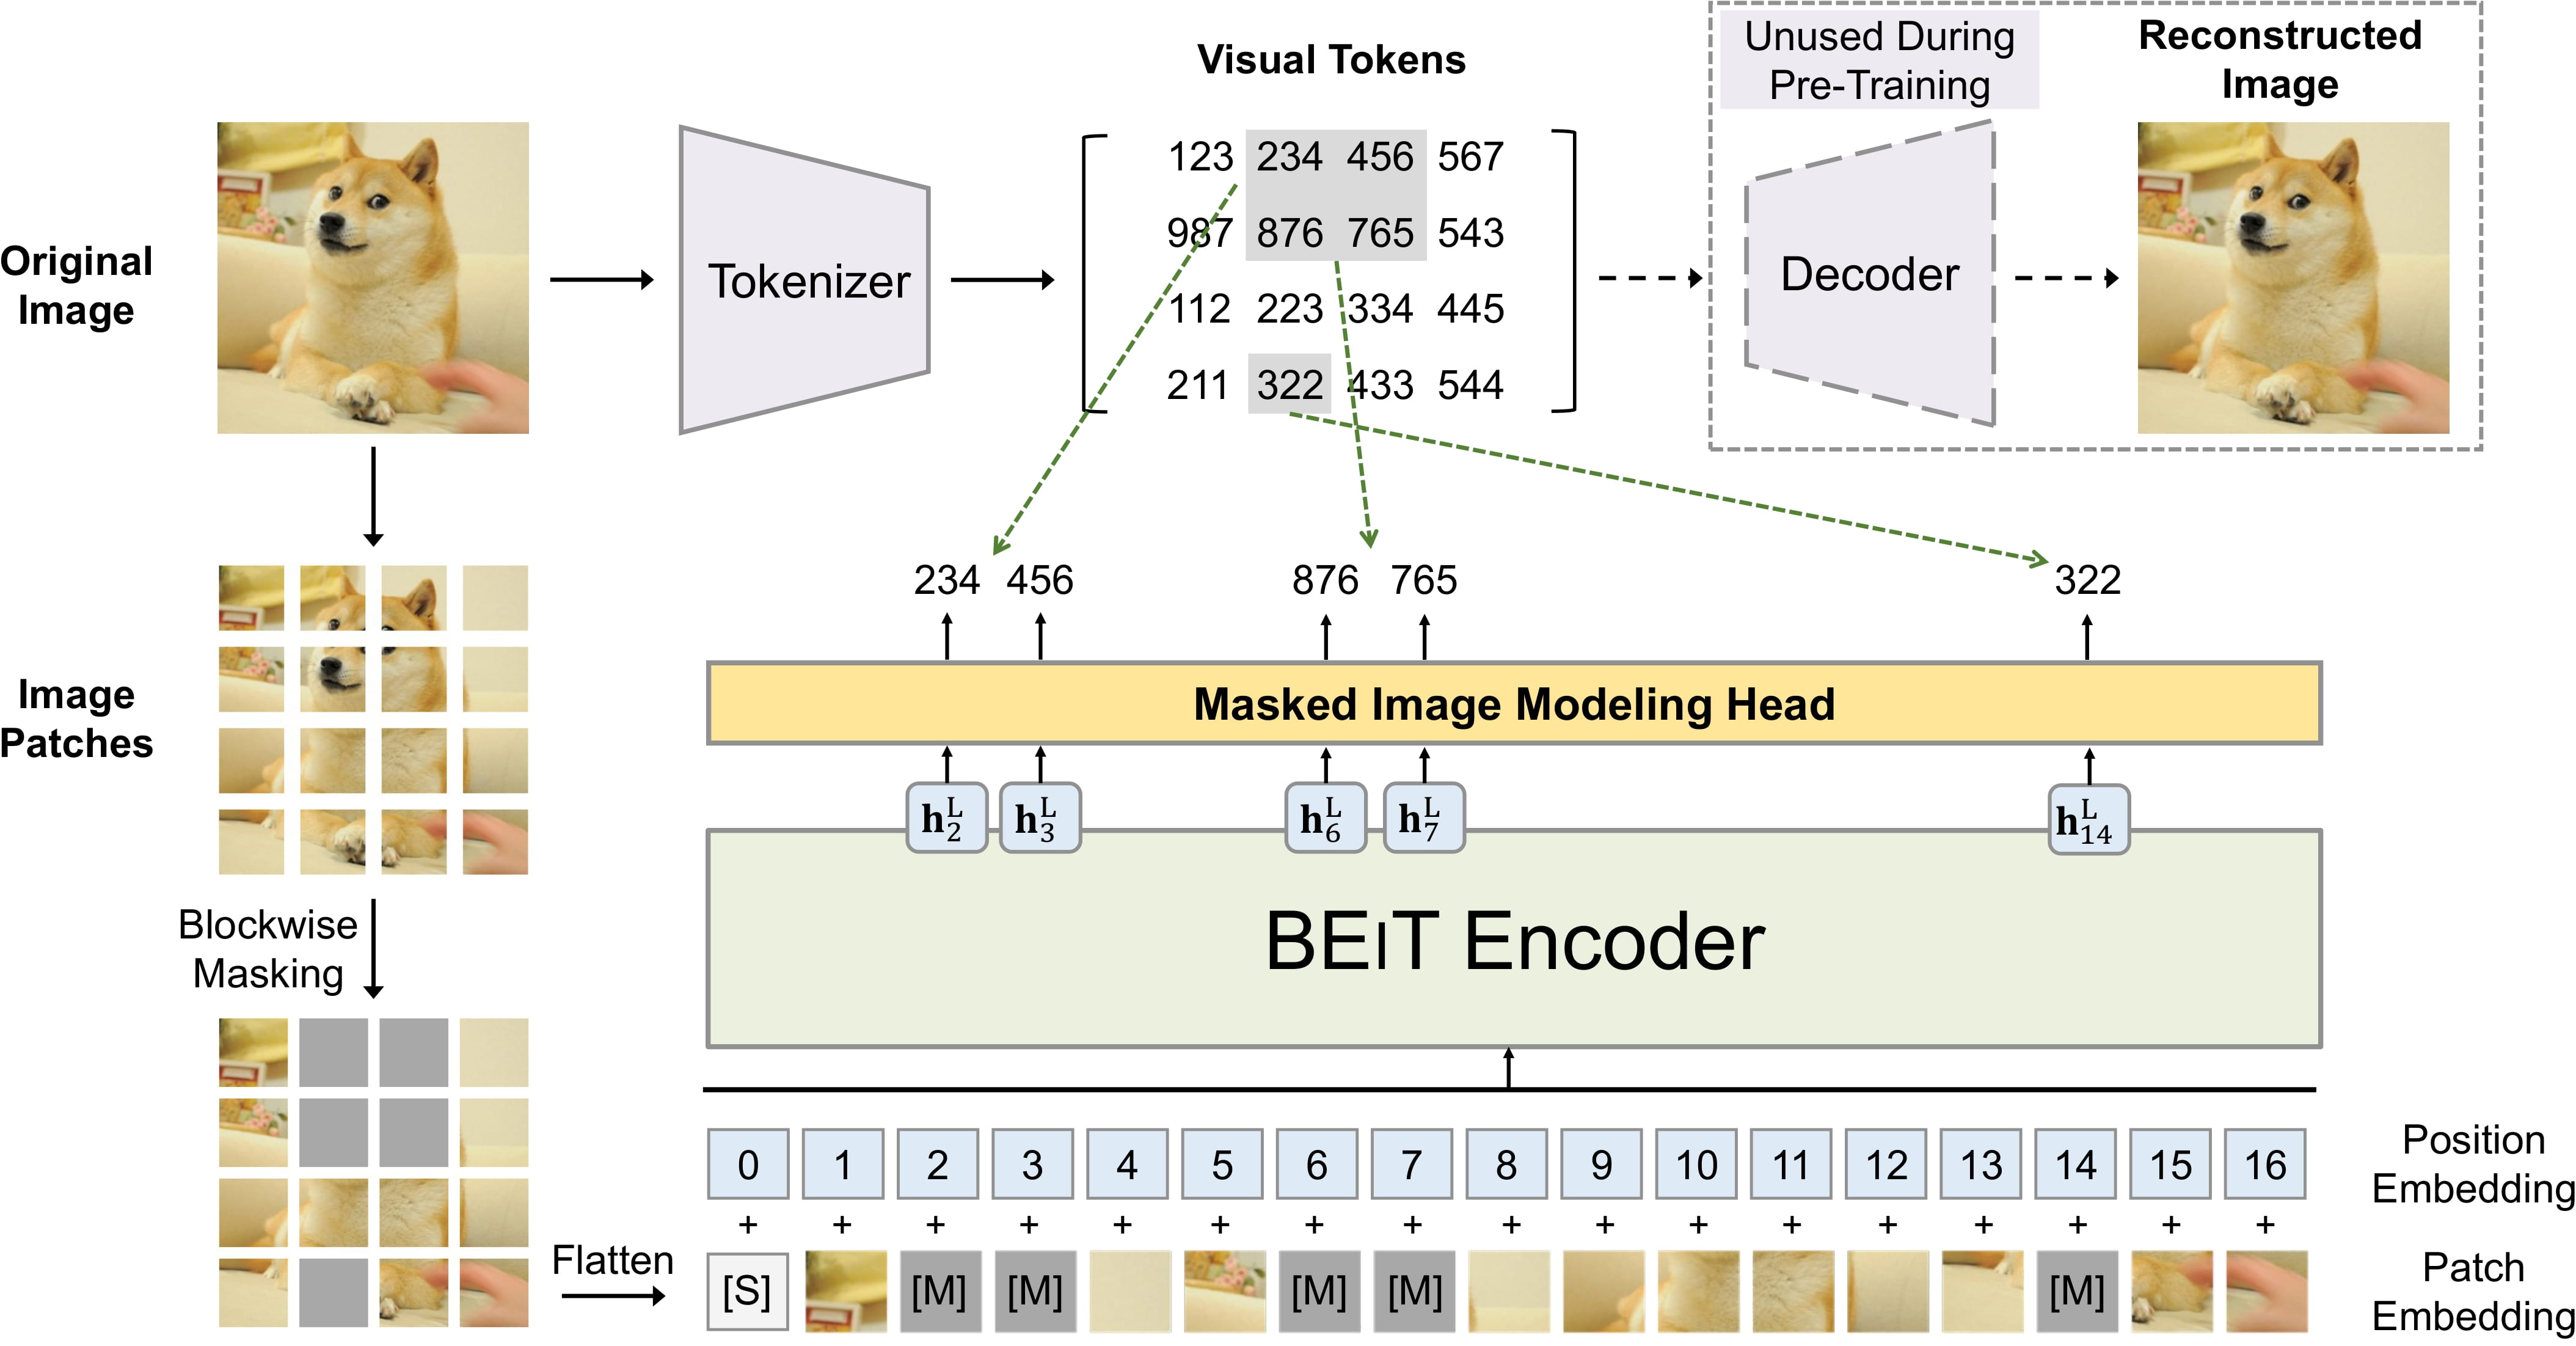 Pre-training BEiT. Diambil dari paper aslinya.
### Menggunakan Scaled Dot Product Attention (SDPA)
PyTorch menyertakan operator scaled dot-product attention (SDPA) native sebagai bagian dari `torch.nn.functional`. Fungsi ini mencakup beberapa implementasi yang dapat diterapkan tergantung pada input dan perangkat keras yang digunakan. Lihat [dokumentasi resmi](https://pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention.html) atau halaman [GPU Inference](https://huggingface.co/docs/transformers/main/en/perf_infer_gpu_one#pytorch-scaled-dot-product-attention) untuk informasi lebih lanjut.
SDPA digunakan secara default untuk `torch>=2.1.1` ketika implementasi tersedia, tetapi Anda juga dapat mengatur `attn_implementation="sdpa"` di `from_pretrained()` untuk secara eksplisit meminta penggunaan SDPA.
```python
from transformers import BeitForImageClassification
model = BeitForImageClassification.from_pretrained("microsoft/beit-base-patch16-224", attn_implementation="sdpa", device_map="auto")
...
```
Untuk percepatan terbaik, kami merekomendasikan memuat model dalam presisi setengah (misalnya `torch.float16` atau `torch.bfloat16`).
Pada benchmark lokal (NVIDIA GeForce RTX 2060-8GB, PyTorch 2.5.1, OS Ubuntu 20.04) dengan `float16` dan model `microsoft/beit-base-patch16-224`, kami melihat peningkatan berikut selama pelatihan dan inferensi:
#### Pelatihan
| num_training_steps | batch_size | image_size | is_cuda | Waktu per batch (eager - s) | Waktu per batch (sdpa - s) | Percepatan (%) | Puncak memori Eager (MB) | Mem puncak SDPA (MB) | Penghematan memori (%) |
|--------------------|------------|--------------|---------|----------------------------|---------------------------|-------------|----------------------|--------------------|----------------|
| 50 | 2 | (1048, 640) | Benar | 0.984 | 0.746 | 31.975 | 6738.915 | 4319.886 | 55.998 |
#### Inferensi
| Ukuran batch gambar | Eager (s/iterasi) | Eager CI, % | Memori Eager (MB) | SDPA (s/iter) | SDPA CI, % | Memori SDPA (MB) | Percepatan SDPA | Memori SDPA yang dihemat (%) |
|-------------------:|-----------------:|:--------------|--------------------:|----------------:|:-------------|-------------------:|---------------:|----------------------:|
| 1 | 0.012 | ±0.3% | 3.76657e+08 | 0.011 | ±0.5% | 3.75739e+08 | 1.05 | 0.244 |
| 4 | 0.013 | ±0.1% | 4.03147e+08 | 0.011 | ±0.2% | 3.90554e+08 | 1.178 | 3.225 |
| 16 | 0.045 | ±0.1% | 4.96697e+08 | 0.035 | ±0.1% | 4.51232e+08 | 1.304 | 10.076 |
| 32 | 0.088 | ±0.1% | 6.24417e+08 | 0.066 | ±0.1% | 5.33488e+08 | 1.325 | 17.044 |
## Sumber daya
Daftar sumber resmi Hugging Face dan komunitas (ditandai dengan 🌎) untuk membantu Anda memulai dengan BEiT.
- [BeitForImageClassification](/docs/transformers/main/id/model_doc/beit#transformers.BeitForImageClassification) didukung oleh [notebook](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb) ini.
- Lihat juga: [Panduan tugas klasifikasi gambar](../tasks/image_classification)
**Segmentasi semantik**
- [Panduan tugas segmentasi semantik](../tasks/semantic_segmentation)
Jika Anda tertarik untuk mengirimkan sumber daya agar disertakan di sini, silakan buka Pull Request dan kami akan meninjaunya! Sumber daya tersebut sebaiknya mendemonstrasikan sesuatu yang baru, bukan menduplikasi sumber daya yang sudah ada.
## Output khusus BEiT[[transformers.models.beit.modeling_beit.BeitModelOutputWithPooling]]
#### transformers.models.beit.modeling_beit.BeitModelOutputWithPooling[[transformers.models.beit.modeling_beit.BeitModelOutputWithPooling]]
```python
transformers.models.beit.modeling_beit.BeitModelOutputWithPooling(last_hidden_state: typing.Optional[torch.Tensor] = None, pooler_output: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor, ...] | None = None, attentions: tuple[torch.Tensor, ...] | None = None)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L54)
**Parameter:**
last_hidden_state (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) : Urutan hidden-states pada output dari lapisan terakhir model.
pooler_output (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) : Rata-rata dari hidden states lapisan terakhir dari patch tokens (tidak termasuk token *[CLS]*) jika *config.use_mean_pooling* diatur ke True. Jika diatur ke False, maka final hidden state dari token *[CLS]* akan dikembalikan.
hidden_states (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) : Tuple dari `torch.Tensor` (satu untuk output embeddings, jika model memiliki lapisan embedding, + satu untuk output setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`. Hidden-states model pada output setiap lapisan ditambah output embedding awal yang opsional.
attentions (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) : Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`. Bobot perhatian setelah softmax perhatian, yang digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Kelas untuk output dari [BeitModel](/docs/transformers/main/id/model_doc/beit#transformers.BeitModel).
## BeitConfig[[transformers.BeitConfig]]
#### transformers.BeitConfig[[transformers.BeitConfig]]
```python
transformers.BeitConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 8192, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, use_mask_token: bool = False, use_absolute_position_embeddings: bool = False, use_relative_position_bias: bool = False, use_shared_relative_position_bias: bool = False, layer_scale_init_value: float = 0.1, drop_path_rate: float | int = 0.1, use_mean_pooling: bool = True, pool_scales: list[int] | tuple[int, ...] = (1, 2, 3, 6), use_auxiliary_head: bool = True, auxiliary_loss_weight: float = 0.4, auxiliary_channels: int = 256, auxiliary_num_convs: int = 1, auxiliary_concat_input: bool = False, semantic_loss_ignore_index: int = 255, _out_features: list[str] | None = None, _out_indices: list[int] | None = None, add_fpn: bool = False, reshape_hidden_states: bool = True)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/configuration_beit.py#L25)
**Parameter:**
vocab_size (`int`, *opsional*, defaultnya `8192`) : Ukuran kosakata model. Menentukan jumlah token berbeda yang dapat direpresentasikan oleh `input_ids`.
hidden_size (`int`, *opsional*, defaultnya `768`) : Dimensi dari representasi tersembunyi.
num_hidden_layers (`int`, *opsional*, defaultnya `12`) : Jumlah lapisan tersembunyi dalam decoder Transformer.
num_attention_heads (`int`, *opsional*, defaultnya `12`) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer.
intermediate_size (`int`, *opsional*, defaultnya `3072`) : Dimensi dari representasi MLP.
hidden_act (`str`, *opsional*, defaultnya `gelu`) : Fungsi aktivasi non-linear (fungsi atau string) di decoder. Misalnya, `"gelu"`, `"relu"`, `"silu"`, dan sebagainya.
hidden_dropout_prob (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Probabilitas dropout untuk semua lapisan fully connected di embeddings, encoder, dan pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Rasio dropout untuk probabilitas perhatian.
initializer_range (`float`, *opsional*, defaultnya `0.02`) : Deviasi standar dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot.
layer_norm_eps (`float`, *opsional*, defaultnya `1e-12`) : Epsilon yang digunakan oleh lapisan normalisasi lapisan.
image_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `224`) : Ukuran (resolusi) dari setiap gambar.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `16`) : Ukuran (resolusi) dari setiap patch.
num_channels (`int`, *opsional*, default `3`) : Jumlah saluran input.
use_mask_token (`bool`, *opsional*, defaultnya `False`) : Apakah akan menggunakan token masker untuk pemodelan gambar tersembunyi (masked image modeling).
use_absolute_position_embeddings (`bool`, *opsional*, defaultnya `False`) : Apakah akan menggunakan embedding posisi absolut.
use_relative_position_bias (`bool`, *opsional*, defaultnya `False`) : Apakah akan menggunakan relative position embeddings bergaya T5 di lapisan self-attention.
use_shared_relative_position_bias (`bool`, *opsional*, defaultnya `False`) : Apakah akan menggunakan embedding posisi relatif yang sama di semua lapisan self-attention dari Transformer.
layer_scale_init_value (`float`, *opsional*, default `0.1`) : Skala yang digunakan pada lapisan self-attention. 0.1 untuk base, 1e-6 untuk large. Setel 0 untuk menonaktifkan layer scale.
drop_path_rate (`Union[float, int]`, *opsional*, defaultnya `0.1`) : Tingkat drop path untuk fusi patch.
use_mean_pooling (`bool`, *opsional*, defaultnya `True`) : Apakah akan melakukan mean pooling pada hidden state akhir dari patch-patch, alih-alih menggunakan hidden state akhir dari token CLS, sebelum menerapkan kepala klasifikasi.
pool_scales (`tuple[int]`, *opsional*, defaultnya `[1, 2, 3, 6]`) : Skala pooling yang digunakan dalam Pooling Pyramid Module yang diterapkan pada peta fitur terakhir.
use_auxiliary_head (`bool`, *opsional*, defaultnya `True`) : Apakah akan menggunakan kepala bantu selama pelatihan.
auxiliary_loss_weight (`float`, *opsional*, default 0.4) : Bobot dari cross-entropy loss dari auxiliary head.
auxiliary_channels (`int`, *opsional*, default 256) : Jumlah channel yang digunakan di kepala bantu.
auxiliary_num_convs (`int`, *opsional*, default 1) : Jumlah lapisan konvolusional yang digunakan di kepala bantu.
auxiliary_concat_input (`bool`, *opsional*, defaultnya `False`) : Apakah akan menggabungkan output dari kepala bantu dengan input sebelum lapisan klasifikasi.
semantic_loss_ignore_index (`int`, *opsional*, defaultnya `255`) : Indeks yang diabaikan oleh fungsi loss dari model segmentasi semantik.
add_fpn (`bool`, *opsional*, defaultnya `False`) : Apakah akan menambahkan FPN sebagai bagian dari backbone. Hanya relevan untuk `BeitBackbone`.
reshape_hidden_states (`bool`, *opsional*, defaultnya `True`) : Apakah akan membentuk ulang peta fitur menjadi tensor 4D dengan bentuk `(batch_size, hidden_size, height, width)` jika model digunakan sebagai backbone. Jika `False`, peta fitur akan berupa tensor 3D dengan bentuk `(batch_size, seq_len, hidden_size)`. Hanya relevan untuk `BeitBackbone`.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari BeitModel. Kelas ini digunakan untuk membuat instans model Beit sesuai dengan argumen yang ditentukan, sehingga mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [microsoft/beit-base-patch16-224-pt22k](https://huggingface.co/microsoft/beit-base-patch16-224-pt22k)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import BeitConfig, BeitModel
>>> # Initializing a BEiT beit-base-patch16-224-pt22k style configuration
>>> configuration = BeitConfig()
>>> # Initializing a model (with random weights) from the beit-base-patch16-224-pt22k style configuration
>>> model = BeitModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## BeitImageProcessor[[transformers.BeitImageProcessor]]
#### transformers.BeitImageProcessor[[transformers.BeitImageProcessor]]
```python
transformers.BeitImageProcessor(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_beit.py#L50)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 224, 'width': 224}`): Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 224, 'width': 224}`): Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, defaultnya `3`) : Filter resampling yang digunakan jika mengubah ukuran gambar. Ini bisa berupa salah satu enum `PILImageResampling`. Hanya berdampak jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
do_reduce_labels (`bool`, *kwargs*, *opsional*, defaultnya `self.do_reduce_labels`) : Apakah akan mengurangi semua nilai label pada peta segmentasi sebesar 1. Biasanya digunakan untuk dataset di mana 0 digunakan untuk latar belakang, dan latar belakang itu sendiri tidak termasuk dalam semua kelas dataset (mis. ADE20k). Label latar belakang akan diganti dengan 255.
Membangun pemroses gambar BeitImageProcessor.
#### preprocess[[transformers.BeitImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_beit.py#L70)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Gambar yang akan dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
segmentation_maps (`ImageInput`, *opsional*) : Peta segmentasi yang akan dipreprocess.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
do_reduce_labels (`bool`, *kwargs*, *opsional*, defaultnya `self.do_reduce_labels`) : Apakah akan mengurangi semua nilai label pada peta segmentasi sebesar 1. Biasanya digunakan untuk dataset di mana 0 digunakan untuk latar belakang, dan latar belakang itu sendiri tidak termasuk dalam semua kelas dataset (mis. ADE20k). Label latar belakang akan diganti dengan 255.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
#### post_process_semantic_segmentation[[transformers.BeitImageProcessor.post_process_semantic_segmentation]]
```python
post_process_semantic_segmentation(outputs, target_sizes: list[tuple] | None = None, return_segmentation_scores: bool = False)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_beit.py#L183)
**Parameter:**
outputs ([BeitForSemanticSegmentation](/docs/transformers/main/id/model_doc/beit#transformers.BeitForSemanticSegmentation)) : Output mentah dari model.
target_sizes (`list[Tuple]` dengan panjang `batch_size`, *opsional*) : Daftar tuple yang sesuai dengan ukuran akhir (tinggi, lebar) yang diminta untuk setiap prediksi. Jika tidak disetel, prediksi tidak akan di-resize.
return_segmentation_scores (`bool`, *opsional*, defaultnya `False`) : Apakah akan mengembalikan skor segmentasi bersama dengan peta segmentasi. Ketika `True`, setiap elemen dari daftar yang dikembalikan adalah `SemanticSegmentationPostProcessorOutput` dengan field `segmentation` (ID kelas, bentuk `(height, width)`) dan `segmentation_scores` (bentuk `(num_classes, height, width)`).
**Mengembalikan:** `list[torch.Tensor]` atau `list[SemanticSegmentationPostProcessorOutput]`
Ketika `return_segmentation_scores=False` (default), sebuah daftar dengan panjang `batch_size` di mana setiap item adalah peta segmentasi dengan bentuk `(height, width)` berisi ID kelas. Ketika `return_segmentation_scores=True`, sebuah daftar `SemanticSegmentationPostProcessorOutput` dengan bidang `segmentation` (ID kelas, bentuk `(height, width)`) dan `segmentation_scores` (bentuk `(num_classes, height, width)`). Dalam kedua kasus, `(height, width)` sesuai dengan ukuran target (jika `target_sizes` ditentukan).
Mengonversi output dari [BeitForSemanticSegmentation](/docs/transformers/main/id/model_doc/beit#transformers.BeitForSemanticSegmentation) menjadi peta segmentasi semantik.
## BeitImageProcessorPil[[transformers.BeitImageProcessorPil]]
#### transformers.BeitImageProcessorPil[[transformers.BeitImageProcessorPil]]
```python
transformers.BeitImageProcessorPil(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_pil_beit.py#L53)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 224, 'width': 224}`): Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 224, 'width': 224}`): Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, defaultnya `3`) : Filter resampling yang digunakan jika mengubah ukuran gambar. Ini bisa berupa salah satu enum `PILImageResampling`. Hanya berdampak jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
do_reduce_labels (`bool`, *kwargs*, *opsional*, defaultnya `self.do_reduce_labels`) : Apakah akan mengurangi semua nilai label pada peta segmentasi sebesar 1. Biasanya digunakan untuk dataset di mana 0 digunakan untuk latar belakang, dan latar belakang itu sendiri tidak termasuk dalam semua kelas dataset (mis. ADE20k). Label latar belakang akan diganti dengan 255.
Membangun pemroses gambar BeitImageProcessor.
#### preprocess[[transformers.BeitImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_pil_beit.py#L73)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Gambar yang akan dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
segmentation_maps (`ImageInput`, *opsional*) : Peta segmentasi yang akan dipreprocess.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
do_reduce_labels (`bool`, *kwargs*, *opsional*, defaultnya `self.do_reduce_labels`) : Apakah akan mengurangi semua nilai label pada peta segmentasi sebesar 1. Biasanya digunakan untuk dataset di mana 0 digunakan untuk latar belakang, dan latar belakang itu sendiri tidak termasuk dalam semua kelas dataset (mis. ADE20k). Label latar belakang akan diganti dengan 255.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
#### post_process_semantic_segmentation[[transformers.BeitImageProcessorPil.post_process_semantic_segmentation]]
```python
post_process_semantic_segmentation(outputs, target_sizes: list[tuple] | None = None, return_segmentation_scores: bool = False)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_pil_beit.py#L169)
**Parameter:**
outputs ([BeitForSemanticSegmentation](/docs/transformers/main/id/model_doc/beit#transformers.BeitForSemanticSegmentation)) : Output mentah dari model.
target_sizes (`list[Tuple]` dengan panjang `batch_size`, *opsional*) : Daftar tuple yang sesuai dengan ukuran akhir (tinggi, lebar) yang diminta untuk setiap prediksi. Jika tidak disetel, prediksi tidak akan di-resize.
return_segmentation_scores (`bool`, *opsional*, defaultnya `False`) : Apakah akan mengembalikan skor segmentasi bersama dengan peta segmentasi. Ketika `True`, setiap elemen dari daftar yang dikembalikan adalah `SemanticSegmentationPostProcessorOutput` dengan field `segmentation` (ID kelas, bentuk `(height, width)`) dan `segmentation_scores` (bentuk `(num_classes, height, width)`).
**Mengembalikan:** `list[torch.Tensor]` atau `list[SemanticSegmentationPostProcessorOutput]`
Ketika `return_segmentation_scores=False` (default), sebuah daftar dengan panjang `batch_size` di mana setiap item adalah peta segmentasi dengan bentuk `(height, width)` berisi ID kelas. Ketika `return_segmentation_scores=True`, sebuah daftar `SemanticSegmentationPostProcessorOutput` dengan bidang `segmentation` (ID kelas, bentuk `(height, width)`) dan `segmentation_scores` (bentuk `(num_classes, height, width)`). Dalam kedua kasus, `(height, width)` sesuai dengan ukuran target (jika `target_sizes` ditentukan).
Mengonversi output dari [BeitForSemanticSegmentation](/docs/transformers/main/id/model_doc/beit#transformers.BeitForSemanticSegmentation) menjadi peta segmentasi semantik.
## BeitModel[[transformers.BeitModel]]
#### transformers.BeitModel[[transformers.BeitModel]]
```python
transformers.BeitModel(config: BeitConfig, add_pooling_layer: bool = True)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L486)
**Parameter:**
config ([BeitConfig](/docs/transformers/main/id/model_doc/beit#transformers.BeitConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
add_pooling_layer (`bool`, *opsional*, defaultnya `True`) : Apakah akan menambahkan lapisan pooling
Model Beit polos yang menghasilkan hidden-states mentah tanpa head spesifik di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.BeitModel.forward]]
```python
forward(pixel_values: Tensor, bool_masked_pos: typing.Optional[torch.BoolTensor] = None, interpolate_pos_encoding: bool = False, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L512)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [BeitImageProcessor](/docs/transformers/main/id/model_doc/beit#transformers.BeitImageProcessor). Lihat [BeitImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya (`processor_class` menggunakan [BeitImageProcessor](/docs/transformers/main/id/model_doc/beit#transformers.BeitImageProcessor) untuk memproses gambar).
bool_masked_pos (`torch.BoolTensor` dengan bentuk `(batch_size, num_patches)`, *opsional*) : Posisi yang dimask secara boolean. Menunjukkan patch mana yang dimask (1) dan mana yang tidak (0).
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
**Mengembalikan:** [BeitModelOutputWithPooling](/docs/transformers/main/id/model_doc/beit#transformers.models.beit.modeling_beit.BeitModelOutputWithPooling) atau `tuple(torch.Tensor)`
[BeitModelOutputWithPooling](/docs/transformers/main/id/model_doc/beit#transformers.models.beit.modeling_beit.BeitModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([BeitConfig](/docs/transformers/main/id/model_doc/beit#transformers.BeitConfig)) dan input.
Metode forward dari [BeitModel](/docs/transformers/main/id/model_doc/beit#transformers.BeitModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Rata-rata dari hidden states lapisan terakhir dari token patch (tidak termasuk token *[CLS]*) jika *config.use_mean_pooling* diatur ke True. Jika diatur ke False, maka hidden state akhir dari token *[CLS]* akan dikembalikan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
```
## BeitForMaskedImageModeling[[transformers.BeitForMaskedImageModeling]]
#### transformers.BeitForMaskedImageModeling[[transformers.BeitForMaskedImageModeling]]
```python
transformers.BeitForMaskedImageModeling(config: BeitConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L583)
**Parameter:**
config ([BeitConfig](/docs/transformers/main/id/model_doc/beit#transformers.BeitConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model transformer Beit dengan kepala pemodelan 'bahasa' di atasnya. BEiT melakukan pemodelan gambar tersembunyi (masked image modeling) dengan memprediksi token visual dari Vector-Quantize Variational Autoencoder (VQ-VAE), sedangkan model visi lainnya seperti ViT dan DeiT memprediksi nilai piksel RGB. Akibatnya, kelas ini tidak kompatibel dengan [AutoModelForMaskedImageModeling](/docs/transformers/main/id/model_doc/auto#transformers.AutoModelForMaskedImageModeling), sehingga Anda perlu menggunakan [BeitForMaskedImageModeling](/docs/transformers/main/id/model_doc/beit#transformers.BeitForMaskedImageModeling) secara langsung jika ingin melakukan pemodelan gambar tersembunyi dengan BEiT.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.BeitForMaskedImageModeling.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, bool_masked_pos: typing.Optional[torch.BoolTensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L600)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [BeitImageProcessor](/docs/transformers/main/id/model_doc/beit#transformers.BeitImageProcessor). Lihat [BeitImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya (`processor_class` menggunakan [BeitImageProcessor](/docs/transformers/main/id/model_doc/beit#transformers.BeitImageProcessor) untuk memproses gambar).
bool_masked_pos (`torch.BoolTensor` dengan bentuk `(batch_size, num_patches)`) : Posisi yang dimasker secara Boolean. Menunjukkan patch mana yang dimasker (1) dan mana yang tidak (0).
labels (`torch.LongTensor` dengan bentuk `(batch_size,)`, *opsional*) : Label untuk menghitung loss klasifikasi/regresi gambar. Indeks harus berada dalam `[0, ..., config.num_labels - 1]`. Jika `config.num_labels == 1`, loss regresi dihitung (Mean-Square loss). Jika `config.num_labels > 1`, loss klasifikasi dihitung (Cross-Entropy).
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
**Mengembalikan:** [MaskedLMOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) atau `tuple(torch.Tensor)`
Sebuah [MaskedLMOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([BeitConfig](/docs/transformers/main/id/model_doc/beit#transformers.BeitConfig)) dan input.
Metode forward dari [BeitForMaskedImageModeling](/docs/transformers/main/id/model_doc/beit#transformers.BeitForMaskedImageModeling) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan ketika `labels` diberikan) -- Masked language modeling (MLM) loss.
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, config.vocab_size)`) -- Skor prediksi dari kepala pemodelan bahasa (skor untuk setiap token kosakata sebelum SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import AutoImageProcessor, BeitForMaskedImageModeling
>>> import torch
>>> from PIL import Image
>>> import requests
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> model = BeitForMaskedImageModeling.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> num_patches = (model.config.image_size // model.config.patch_size) ** 2
>>> pixel_values = image_processor(images=image, return_tensors="pt").pixel_values
>>> # create random boolean mask of shape (batch_size, num_patches)
>>> bool_masked_pos = torch.randint(low=0, high=2, size=(1, num_patches)).bool()
>>> outputs = model(pixel_values, bool_masked_pos=bool_masked_pos)
>>> loss, logits = outputs.loss, outputs.logits
>>> list(logits.shape)
[1, 196, 8192]
```
## BeitForImageClassification[[transformers.BeitForImageClassification]]
#### transformers.BeitForImageClassification[[transformers.BeitForImageClassification]]
```python
transformers.BeitForImageClassification(config: BeitConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L675)
**Parameter:**
config ([BeitConfig](/docs/transformers/main/id/model_doc/beit#transformers.BeitConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model transformer Beit dengan kepala klasifikasi gambar di atasnya (lapisan linear di atas rata-rata dari keadaan tersembunyi akhir dari token patch), misalnya untuk ImageNet.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.BeitForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L688)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [BeitImageProcessor](/docs/transformers/main/id/model_doc/beit#transformers.BeitImageProcessor). Lihat [BeitImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya (`processor_class` menggunakan [BeitImageProcessor](/docs/transformers/main/id/model_doc/beit#transformers.BeitImageProcessor) untuk memproses gambar).
labels (`torch.LongTensor` dengan bentuk `(batch_size,)`, *opsional*) : Label untuk menghitung loss klasifikasi/regresi gambar. Indeks harus berada dalam `[0, ..., config.num_labels - 1]`. Jika `config.num_labels == 1`, loss regresi dihitung (Mean-Square loss). Jika `config.num_labels > 1`, loss klasifikasi dihitung (Cross-Entropy).
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** [ImageClassifierOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) atau `tuple(torch.Tensor)`
A [ImageClassifierOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([BeitConfig](/docs/transformers/main/id/model_doc/beit#transformers.BeitConfig)) dan input.
Metode forward dari [BeitForImageClassification](/docs/transformers/main/id/model_doc/beit#transformers.BeitForImageClassification) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan saat `labels` disediakan) -- Loss klasifikasi (atau regresi jika config.num_labels==1).
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, config.num_labels)`) -- Skor klasifikasi (atau regresi jika config.num_labels==1) (sebelum SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap tahap) dengan bentuk `(batch_size, sequence_length, hidden_size)`. Hidden-states (juga disebut feature maps) dari model pada output dari setiap tahap.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, patch_size, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import AutoImageProcessor, BeitForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> model = BeitForImageClassification.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```
## BeitForSemanticSegmentation[[transformers.BeitForSemanticSegmentation]]
#### transformers.BeitForSemanticSegmentation[[transformers.BeitForSemanticSegmentation]]
```python
transformers.BeitForSemanticSegmentation(config: BeitConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L978)
**Parameter:**
config ([BeitConfig](/docs/transformers/main/id/model_doc/beit#transformers.BeitConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model Beit dengan kepala segmentasi semantik di atasnya, misalnya untuk ADE20K, CityScapes.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.BeitForSemanticSegmentation.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L1000)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [BeitImageProcessor](/docs/transformers/main/id/model_doc/beit#transformers.BeitImageProcessor). Lihat [BeitImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya (`processor_class` menggunakan [BeitImageProcessor](/docs/transformers/main/id/model_doc/beit#transformers.BeitImageProcessor) untuk memproses gambar).
labels (`torch.LongTensor` dengan bentuk `(batch_size, height, width)`, *opsional*) : Peta segmentasi semantik ground truth untuk menghitung loss. Indeks harus berada dalam `[0, ..., config.num_labels - 1]`. Jika `config.num_labels > 1`, loss klasifikasi dihitung (Cross-Entropy).
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** [SemanticSegmenterOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.SemanticSegmenterOutput) atau `tuple(torch.Tensor)`
Sebuah [SemanticSegmenterOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.SemanticSegmenterOutput) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([BeitConfig](/docs/transformers/main/id/model_doc/beit#transformers.BeitConfig)) dan input.
Metode forward dari [BeitForSemanticSegmentation](/docs/transformers/main/id/model_doc/beit#transformers.BeitForSemanticSegmentation) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan saat `labels` disediakan) -- Loss klasifikasi (atau regresi jika config.num_labels==1).
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, config.num_labels, logits_height, logits_width)`) -- Skor klasifikasi untuk setiap piksel.
Logits yang dikembalikan tidak selalu memiliki ukuran yang sama dengan `pixel_values` yang diberikan sebagai input. Hal ini dilakukan untuk menghindari dua kali interpolasi dan kehilangan kualitas ketika pengguna perlu mengubah ukuran logits ke ukuran gambar asli sebagai pascapemrosesan. Anda harus selalu memeriksa bentuk logits Anda dan mengubah ukurannya sesuai kebutuhan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, patch_size, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, patch_size, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import AutoImageProcessor, BeitForSemanticSegmentation
>>> from PIL import Image
>>> import requests
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-finetuned-ade-640-640")
>>> model = BeitForSemanticSegmentation.from_pretrained("microsoft/beit-base-finetuned-ade-640-640")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # logits are of shape (batch_size, num_labels, height, width)
>>> logits = outputs.logits
```