# InstructBlipVideo
## Aperçu
InstructBLIPVideo est une extension des modèles proposés dans [InstructBLIP: Towards General-purpose Vision-Language Models with Instruction Tuning](https://huggingface.co/papers/2305.06500) par Wenliang Dai, Junnan Li, Dongxu Li, Anthony Meng Huat Tiong, Junqi Zhao, Weisheng Wang, Boyang Li, Pascale Fung, Steven Hoi. InstructBLIPVideo utilise la même architecture que [InstructBLIP](instructblip) et fonctionne avec les mêmes points de contrôle que [InstructBLIP](instructblip). La seule différence réside dans la capacité de traiter des vidéos.
L'abstract de l'article est le suivant :
*Des modèles de langage à usage général, capables de résoudre diverses tâches du domaine du langage, ont émergé grâce au pipeline de pré-entraînement et d’instruction-tuning. Toutefois, la construction de modèles vision-langage à usage général reste un défi, en raison de la divergence accrue des tâches introduite par l’entrée visuelle supplémentaire. Bien que le pré-entraînement vision-langage ait fait l’objet d’études approfondies, l’instruction-tuning vision-langage demeure relativement peu exploré. Dans cet article, nous menons une étude systématique et exhaustive sur l’instruction-tuning vision-langage, fondée sur les modèles BLIP-2 pré-entraînés. Nous rassemblons une grande variété de 26 jeux de données publics, les transformons au format d’instruction-tuning et les classons en deux clusters : l’un pour l’instruction-tuning sur les données retenues (held-in), l’autre pour l’évaluation zéro-shot sur les données exclues (held-out). De plus, nous introduisons l’extraction de caractéristiques visuelles consciente des instructions, une méthode cruciale qui permet au modèle d’extraire des caractéristiques informatives adaptées à l’instruction donnée. Les modèles InstructBLIP résultants atteignent des performances zéro-shot de l’état de l’art sur les 13 jeux de données held-out, surpassant nettement BLIP-2 et le modèle plus volumineux Flamingo. Nos modèles obtiennent également des performances de l’état de l’art lorsqu’ils sont affinés sur des tâches aval individuelles (par exemple, 90,7 % de précision sur ScienceQA IMG). Enfin, nous démontrons qualitativement les avantages d’InstructBLIP par rapport aux modèles multimodaux concurrents.*
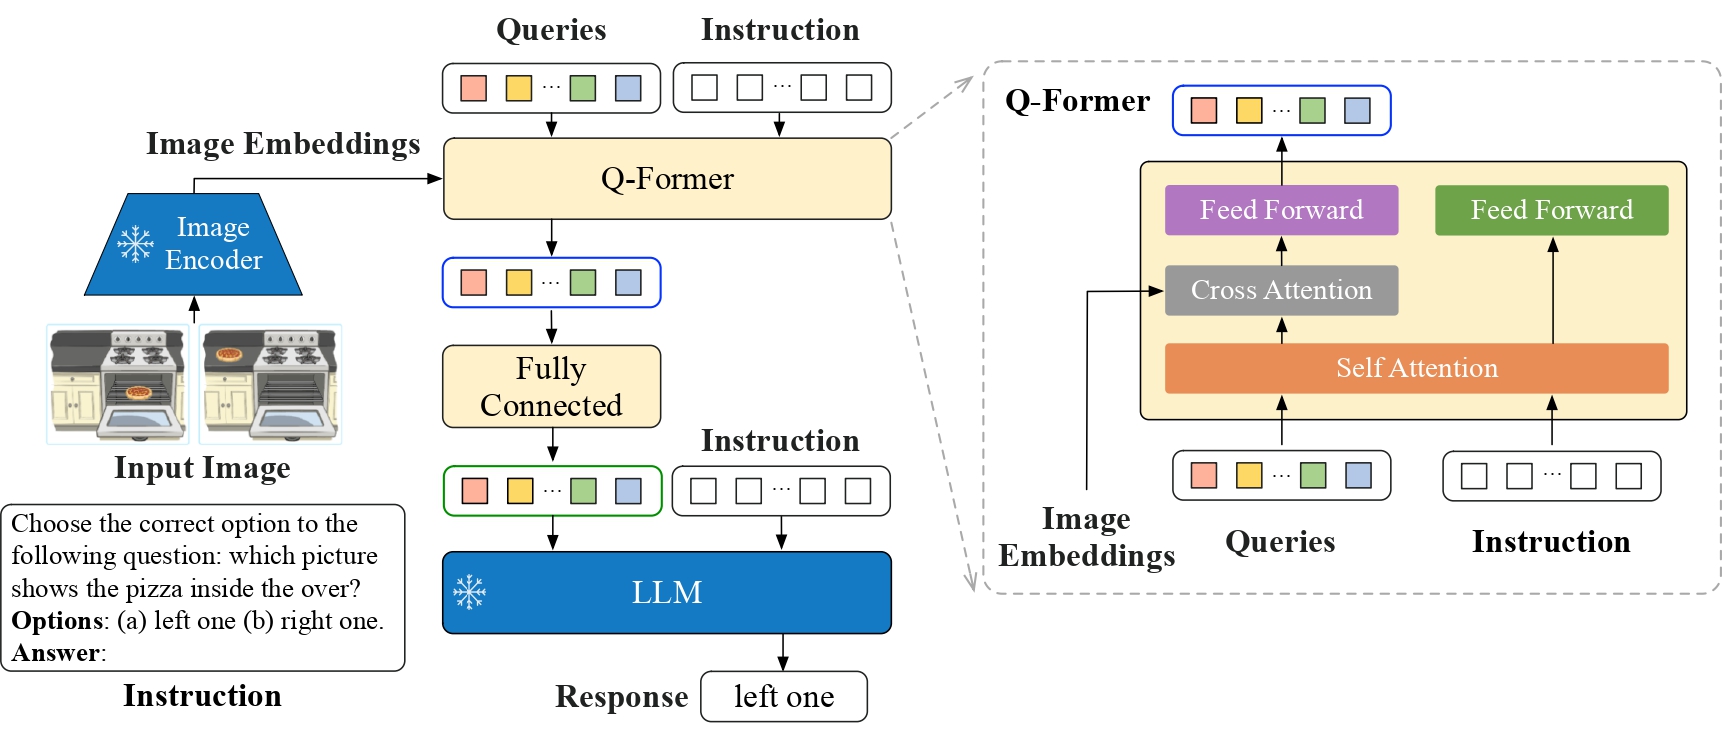 Architecture d’InstructBLIPVideo. Issue de l’article original.
Ce modèle a été contribué par [RaushanTurganbay](https://huggingface.co/RaushanTurganbay). Le code d'origine peut être trouvé [ici](https://github.com/salesforce/LAVIS/tree/main/projects/instructblip).
## Conseils d'utilisation
- Le modèle a été entraîné en échantillonnant 4 images par vidéo, il est donc recommandé d'échantillonner 4 images
> [!NOTE]
> Les modèles BLIP publiés après la version v4.46 émettront des avertissements concernant l'ajout de `processor.num_query_tokens = {{num_query_tokens}}` et l'extension de la couche d'embeddings du modèle pour ajouter le jeton spécial ``. Il est vivement recommandé d'ajouter ces attributs au processeur si vous possédez le point de contrôle du modèle, ou d'ouvrir une PR s'il ne vous appartient pas. L'ajout de ces attributs signifie que BLIP ajoutera le nombre de jetons de requête requis par image et étendra le texte avec autant de placeholders `` qu'il y aura de jetons de requête. Généralement, il s'agit d'environ 500 jetons par image, veillez donc à ce que le texte ne soit pas tronqué, car sinon une erreur se produira lors de la fusion des embeddings.
Les attributs peuvent être obtenus à partir de la configuration du modèle, comme `model.config.num_query_tokens`, et l'expansion des embeddings du modèle peut être réalisée en suivant [ce lien](https://gist.github.com/zucchini-nlp/e9f20b054fa322f84ac9311d9ab67042).
## InstructBlipVideoConfig[[transformers.InstructBlipVideoConfig]]
#### transformers.InstructBlipVideoConfig[[transformers.InstructBlipVideoConfig]]
```python
transformers.InstructBlipVideoConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, qformer_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_query_tokens: int = 32, initializer_factor: float = 1.0, initializer_range: float = 0.02, video_token_index: int | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/configuration_instructblipvideo.py#L109)
**Paramètres :**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone visuel.
qformer_config (`dict`, *facultatif*) : Dictionnaire des options de configuration utilisées pour initialiser [InstructBlipVideoQFormerConfig](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoQFormerConfig).
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone de texte.
num_query_tokens (`int`, *facultatif*, valeur par défaut : 32) : Le nombre de jetons de requête transmis au Transformer.
initializer_factor (`float`, *facultatif*, par défaut `1.0`) : Un facteur pour l'initialisation de toutes les matrices de poids (doit être maintenu à 1, utilisé en interne pour les tests d'initialisation).
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
video_token_index (`int`, *facultatif*) : L'index du jeton vidéo utilisé comme espace réservé pour les vidéos d'entrée.
Il s'agit de la classe de configuration destinée à stocker la configuration d'un InstructBlipVideoModel. Elle est utilisée pour instancier un modèle Instructblipvideo en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import (
... InstructBlipVideoVisionConfig,
... InstructBlipVideoQFormerConfig,
... OPTConfig,
... InstructBlipVideoConfig,
... InstructBlipVideoForConditionalGeneration,
... )
>>> # Initializing a InstructBlipVideoConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVideoConfig()
>>> # Initializing a InstructBlipVideoForConditionalGeneration (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVideoForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a InstructBlipVideoConfig from a InstructBlipVideoVisionConfig, InstructBlipVideoQFormerConfig and any PreTrainedConfig
>>> # Initializing Instructblipvideo vision, Instructblipvideo Q-Former and language model configurations
>>> vision_config = InstructBlipVideoVisionConfig()
>>> qformer_config = InstructBlipVideoQFormerConfig()
>>> text_config = OPTConfig()
>>> config = InstructBlipVideoConfig(vision_config=vision_config, qformer_config=qformer_config, text_config=text_config)
```
## InstructBlipVideoVisionConfig[[transformers.InstructBlipVideoVisionConfig]]
#### transformers.InstructBlipVideoVisionConfig[[transformers.InstructBlipVideoVisionConfig]]
```python
transformers.InstructBlipVideoVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 1408, intermediate_size: int = 6144, num_hidden_layers: int = 39, num_attention_heads: int = 16, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 14, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/configuration_instructblipvideo.py#L32)
**Paramètres :**
hidden_size (`int`, *facultatif*, valeur par défaut `1408`) : Dimension des représentations cachées.
intermediate_size (`int`, *facultatif*, valeur par défaut `6144`) : Dimension des représentations MLP.
num_hidden_layers (`int`, *facultatif*, valeur par défaut `39`) : Nombre de couches cachées dans le décodeur Transformer.
num_attention_heads (`int`, *facultatif*, valeur par défaut `16`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
image_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `224`) : La taille (résolution) de chaque image.
patch_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `14`) : La taille (résolution) de chaque patch.
hidden_act (`str`, *facultatif*, par défaut `gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *facultatif*, par défaut `1e-06`) : L'épsilon utilisé par les couches de normalisation par couche.
attention_dropout (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout appliqué aux probabilités d'attention.
initializer_range (`float`, *facultatif*, valeur par défaut `1e-10`) : L'écart-type de truncated_normal_initializer pour l'initialisation de toutes les matrices de poids.
qkv_bias (`bool`, *facultatif*, par défaut `True`) : Indique s'il faut ajouter un biais aux requêtes, clés et valeurs.
Il s'agit de la classe de configuration destinée à stocker la configuration d'un InstructBlipVideoModel. Elle est utilisée pour instancier un modèle Instructblipvideo en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import InstructBlipVideoVisionConfig, InstructBlipVideoVisionModel
>>> # Initializing a InstructBlipVideoVisionConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVideoVisionConfig()
>>> # Initializing a InstructBlipVideoVisionModel (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVideoVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## InstructBlipVideoQFormerConfig[[transformers.InstructBlipVideoQFormerConfig]]
#### transformers.InstructBlipVideoQFormerConfig[[transformers.InstructBlipVideoQFormerConfig]]
```python
transformers.InstructBlipVideoQFormerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, cross_attention_frequency: int = 2, encoder_hidden_size: int = 1408)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/configuration_instructblipvideo.py#L67)
**Paramètres :**
vocab_size (`int`, *facultatif*, valeur par défaut `30522`) : Taille du vocabulaire du modèle. Définit le nombre de jetons différents qui peuvent être représentés par `input_ids`.
hidden_size (`int`, *facultatif*, par défaut `768`) : Dimension des représentations cachées.
num_hidden_layers (`int`, *facultatif*, par défaut `12`) : Nombre de couches cachées dans le décodeur Transformer.
num_attention_heads (`int`, *facultatif*, valeur par défaut `12`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
intermediate_size (`int`, *facultatif*, par défaut `3072`) : Dimension des représentations MLP.
hidden_act (`str`, *facultatif*, par défaut `gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *facultatif*, valeur par défaut `0.1`) : La probabilité de dropout pour toutes les couches entièrement connectées des embeddings, de l'encodeur et du pooler.
attention_probs_dropout_prob (`Union[float, int]`, *facultatif*, valeur par défaut `0.1`) : Le taux de dropout appliqué aux probabilités d'attention.
max_position_embeddings (`int`, *facultatif*, valeur par défaut `512`) : La longueur de séquence maximale avec laquelle ce modèle pourrait être utilisé.
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
layer_norm_eps (`float`, *facultatif*, par défaut `1e-12`) : L'épsilon utilisé par les couches de normalisation par couche.
pad_token_id (`int`, *facultatif*, valeur par défaut `0`) : Identifiant du jeton utilisé pour le bourrage dans le vocabulaire.
cross_attention_frequency (`int`, *facultatif*, valeur par défaut : 2) : La fréquence d'ajout de l'attention croisée aux couches du Transformer.
encoder_hidden_size (`int`, *facultatif*, valeur par défaut 1408) : La taille cachée des états cachés pour l'attention croisée.
Il s'agit de la classe de configuration destinée à stocker la configuration d'un InstructBlipVideoModel. Elle est utilisée pour instancier un modèle Instructblipvideo en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemples :
```python
>>> from transformers import InstructBlipVideoQFormerConfig, InstructBlipVideoQFormerModel
>>> # Initializing a InstructBlipVideo Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVideoQFormerConfig()
>>> # Initializing a model (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVideoQFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## InstructBlipVideoProcessor[[transformers.InstructBlipVideoProcessor]]
#### transformers.InstructBlipVideoProcessor[[transformers.InstructBlipVideoProcessor]]
```python
transformers.InstructBlipVideoProcessor(video_processor, tokenizer, qformer_tokenizer, num_query_tokens = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/processing_instructblipvideo.py#L35)
**Paramètres :**
video_processor (`InstructBlipVideoVideoProcessor`) : le processeur vidéo est une entrée obligatoire.
tokenizer (`GPT2Tokenizer`) : le tokenizer est une entrée obligatoire.
qformer_tokenizer (`AutoTokenizer`) : une instance de ['PreTrainedTokenizer`]. Le tokenizer du Q-Former est une entrée obligatoire.
num_query_tokens (`int`, *facultatif*) : Nombre de jetons utilisés par le Qformer en tant que requêtes, doit être identique à celui de la configuration du modèle.
Construit un InstructBlipVideoProcessor qui encapsule un processeur de vidéo, un tokeniseur et un tokeniseur qformer en un seul processeur.
[InstructBlipVideoProcessor](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoProcessor) offre toutes les fonctionnalités de [InstructBlipVideoVideoProcessor](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoVideoProcessor), [GPT2Tokenizer](/docs/transformers/main/fr/model_doc/gpt2#transformers.GPT2Tokenizer) et `{qformer_tokenizer_class}`. Consultez [~InstructBlipVideoVideoProcessor](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoVideoProcessor), [~GPT2Tokenizer](/docs/transformers/main/fr/model_doc/gpt2#transformers.GPT2Tokenizer) et `~{qformer_tokenizer_class}` pour plus d’informations.
## InstructBlipVideoVideoProcessor[[transformers.InstructBlipVideoVideoProcessor]]
#### transformers.InstructBlipVideoVideoProcessor[[transformers.InstructBlipVideoVideoProcessor]]
```python
transformers.InstructBlipVideoVideoProcessor(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/video_processing_instructblipvideo.py#L30)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 384, 'width': 384}`) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `3`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir de l'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.48145466, 0.4578275, 0.40821073]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.26862954, 0.26130258, 0.27577711]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
do_sample_frames (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut échantillonner des images de la vidéo avant le traitement ou traiter la vidéo entière.
video_metadata (`Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None]`, *kwargs*) : Métadonnées de la vidéo contenant des informations sur la durée totale, le fps et le nombre total d'images. Elles seront utilisées pour échantillonner des images à partir de la vidéo ou pour calculer des horodatages. Ne passez aucune métadonnée à moins de tenter de décoder manuellement la vidéo avant le traitement.
fps (`Annotated[int | float | None, None]`, *kwargs*) : Nombre de cibles à échantillonner par seconde lorsque `do_sample_frames=True`.
num_frames (`Annotated[int | None, None]`, *kwargs*) : Nombre maximal d'images à échantillonner lorsque `do_sample_frames=True`.
return_metadata (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut renvoyer les métadonnées de la vidéo ou non. Les métadonnées de la vidéo sont un objet contenant des informations sur la durée de la vidéo, le nombre d'images par seconde, le backend de décodage, etc.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Si défini, renverra des tenseurs d'un framework particulier. Les valeurs acceptables sont : - `'pt'` : Renvoie des objets `torch.Tensor` de PyTorch. - `'np'` : Renvoie des objets `np.ndarray` de NumPy.
- ****kwargs** ([VideosKwargs](/docs/transformers/main/fr/main_classes/processors#transformers.VideosKwargs), *facultatif*) : Options de traitement supplémentaires pour chaque modalité (texte, images, vidéos, audio). Les paramètres spécifiques au modèle sont répertoriés ci-dessus ; consultez la classe TypedDict pour la liste complète des arguments pris en charge.
Construit un processeur vidéo InstructBlipVideoVideoProcessor.
#### prétraiter[[transformers.InstructBlipVideoVideoProcessor.preprocess]]
```python
preprocess(videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]]], **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/video_processing_utils.py#L98)
**Paramètres :**
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`) : Vidéo à prétraiter. S'attend à une vidéo unique ou à un lot de vidéos dont les valeurs de pixels vont de 0 à 255. Si vous transmettez des vidéos dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
do_sample_frames (`bool`, *kwargs*, *facultatif*) : Indique s'il faut échantillonner des images de la vidéo avant le traitement ou traiter la vidéo entière.
video_metadata (`Annotated[~video_utils.VideoMetadata | dict | list[dict | ~video_utils.VideoMetadata] | list[list[dict | ~video_utils.VideoMetadata]] | None, None]`, *kwargs*) : Métadonnées de la vidéo contenant des informations sur la durée totale, le fps et le nombre total d'images. Elles seront utilisées pour échantillonner des images à partir de la vidéo ou pour calculer des horodatages. Ne passez aucune métadonnée à moins de tenter de décoder manuellement la vidéo avant le traitement.
fps (`Annotated[int | float | None, None]`, *kwargs*) : Nombre de cibles à échantillonner par seconde lorsque `do_sample_frames=True`.
num_frames (`Annotated[int | None, None]`, *kwargs*) : Nombre maximal d'images à échantillonner lorsque `do_sample_frames=True`.
return_metadata (`bool`, *kwargs*, *facultatif*) : Indique s'il faut renvoyer les métadonnées de la vidéo ou non. Les métadonnées de la vidéo sont un objet contenant des informations sur la durée de la vidéo, le nombre d'images par seconde, le backend de décodage, etc.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
## InstructBlipVideoVisionModel[[transformers.InstructBlipVideoVisionModel]]
#### transformers.InstructBlipVideoVisionModel[[transformers.InstructBlipVideoVisionModel]]
```python
transformers.InstructBlipVideoVisionModel(config: InstructBlipVideoVisionConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L394)
#### forward[[transformers.InstructBlipVideoVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L414)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs des pixels peuvent être obtenues à l'aide de `image_processor_class`. Voir `image_processor_class.__call__` pour plus de détails ([InstructBlipVideoProcessor](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoProcessor) utilise `image_processor_class` pour le traitement des images).
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([InstructBlipVideoConfig](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoConfig)) et les entrées.
La méthode forward du [InstructBlipVideoVisionModel](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoVisionModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
## InstructBlipVideoQFormerModel[[transformers.InstructBlipVideoQFormerModel]]
#### transformers.InstructBlipVideoQFormerModel[[transformers.InstructBlipVideoQFormerModel]]
```python
transformers.InstructBlipVideoQFormerModel(config: InstructBlipVideoQFormerConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L709)
Querying Transformer (Q-Former), utilisé dans InstructBlipVideo. Légèrement modifié par rapport à BLIP-2, car il prend également l'instruction en entrée.
#### forward[[transformers.InstructBlipVideoQFormerModel.forward]]
```python
forward(input_ids: LongTensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, query_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L747)
**Paramètres :**
input_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage est ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
position_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des positions des jetons de chaque séquence d'entrée dans les embeddings de position. Sélectionnés dans l'intervalle `[0, config.n_positions - 1]`. [Que sont les identifiants de position ?](../glossary#position-ids)
query_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) : États cachés à utiliser dans le calcul de l'attention. En cas d'attention croisée, ils seront utilisés pour la requête (c'est-à-dire que la clé et la valeur utiliseront encoder_hidden_states).
encoder_hidden_states (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Séquence d'états cachés à la sortie de la dernière couche de l'encodeur. Utilisée dans l'attention croisée si le modèle est configuré comme un décodeur.
encoder_attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage de l'entrée de l'encodeur. Ce masque est utilisé dans l'attention croisée si le modèle est configuré comme un décodeur. Valeurs du masque sélectionnées dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**.
**Retourne :** [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) ou `tuple(torch.Tensor)`
Un [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([InstructBlipVideoConfig](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoConfig)) et les entrées.
La méthode forward du modèle [InstructBlipVideoQFormerModel](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoQFormerModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **cross_attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` et `config.add_cross_attention=True` sont passés ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
- **cache** (`Cache`, *facultatif*, renvoyé lorsque `use_cache=True` est passé ou lorsque `config.use_cache=True`) -- Il s'agit d'une instance de [Cache](/docs/transformers/main/fr/internal/generation_utils#transformers.Cache). Pour plus de détails, consultez notre [guide sur le cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contient des états cachés précalculés (clés et valeurs dans les blocs d'auto-attention et, le cas échéant, si `config.is_encoder_decoder=True`, dans les blocs d'attention croisée) qui peuvent être utilisés (voir l'entrée `cache`) pour accélérer le décodage séquentiel.
## InstructBlipVideoModel[[transformers.InstructBlipVideoModel]]
#### transformers.InstructBlipVideoModel[[transformers.InstructBlipVideoModel]]
```python
transformers.InstructBlipVideoModel(config: InstructBlipVideoConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L850)
**Paramètres :**
config ([InstructBlipVideoConfig](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Modèle de base InstructBlipVideo composé d'un modèle de langage, d'un qformer et d'un encodeur visuel.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.InstructBlipVideoModel.forward]]
```python
forward(pixel_values: Tensor, qformer_input_ids: Tensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, use_cache: bool | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L902)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d'entrée. Les valeurs des pixels peuvent être obtenues à l'aide de `image_processor_class`. Consultez `image_processor_class.__call__` pour plus de détails ([InstructBlipVideoProcessor](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoProcessor) utilise `image_processor_class` pour le traitement des images).
qformer_input_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire du Q-Former. Des jetons d'entrée peuvent être fournis facultativement pour servir de prompt texte, que le modèle Q-Former encodera. Les indices peuvent être obtenus à l'aide de [InstructBlipVideoProcessor](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoProcessor). Consultez `InstructBlipVideoProcessor.__call__()` pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
qformer_attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
input_ids (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
attention_mask (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` de forme `(batch_size, target_sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée du décodeur dans le vocabulaire. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Quelles sont les identifiants d'entrée du décodeur ?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor` de forme `(batch_size, target_sequence_length)`, *facultatif*) : Comportement par défaut : générer un tenseur qui ignore les jetons de remplissage dans `decoder_input_ids`. Un masque causal sera également utilisé par défaut. Pertinent uniquement si un modèle de langage encodeur-décodeur (comme T5) est utilisé.
inputs_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer `input_ids`, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir les indices `input_ids` en vecteurs associés, par rapport à la matrice de recherche d'intégration interne du modèle.
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
use_cache (`bool`, *facultatif*) : Si défini sur `True`, les états des valeurs de clé de `cache` sont renvoyés et peuvent être utilisés pour accélérer le décodage (voir `cache`).
**Retourne :** `InstructBlipVideoForConditionalGenerationModelOutput` ou `tuple(torch.Tensor)`
Un `InstructBlipVideoForConditionalGenerationModelOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([InstructBlipVideoConfig](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoConfig)) et les entrées.
La méthode forward du modèle [InstructBlipVideoModel](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor`, *facultatif*, renvoyé lorsque `labels` est fourni, `torch.Tensor` de forme `(1,)`) -- Perte de modélisation du langage issue du modèle de langage.
- **logits** (`torch.Tensor` de forme `(batch_size, sequence_length, config.vocab_size)`) -- Scores de prédiction de la tête de modélisation du langage du modèle de langage.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *facultatif*) -- Sorties de l'encodeur visuel.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *facultatif*) -- Sorties du Q-Former (Querying Transformer).
- **language_model_outputs** (`CausalLMOutputWithPast` ou `Seq2SeqLMOutput`) -- Sorties du modèle de langage.
## InstructBlipVideoForConditionalGeneration[[transformers.InstructBlipVideoForConditionalGeneration]]
#### transformers.InstructBlipVideoForConditionalGeneration[[transformers.InstructBlipVideoForConditionalGeneration]]
```python
transformers.InstructBlipVideoForConditionalGeneration(config: InstructBlipVideoConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L1043)
**Paramètres :**
config ([InstructBlipVideoConfig](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Modèle InstructBlipVideo pour générer du texte à partir d'une image et d'un prompt texte facultatif. Le modèle est composé d'un encodeur visuel, d'un Querying Transformer (Q-Former) et d'un modèle de langage.
On peut éventuellement passer `input_ids` au modèle, qui servent de prompt de texte, afin de faire en sorte que le modèle de langage poursuive le prompt. Sinon, le modèle de langage commence à générer du texte à partir du jeton [BOS] (beginning-of-sequence).
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.InstructBlipVideoForConditionalGeneration.forward]]
```python
forward(pixel_values: Tensor, qformer_input_ids: Tensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, use_cache: bool | None = None, mm_encoder_outputs: transformers.modeling_outputs.BaseModelOutputWithPooling | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L1120)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d'entrée. Les valeurs des pixels peuvent être obtenues à l'aide de `image_processor_class`. Consultez `image_processor_class.__call__` pour plus de détails ([InstructBlipVideoProcessor](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoProcessor) utilise `image_processor_class` pour le traitement des images).
qformer_input_ids (`torch.LongTensor` de forme (batch_size, sequence_length)) : La séquence utilisée comme invite à fournir au module Q-Former.
qformer_attention_mask (`torch.LongTensor` de forme (batch_size, sequence_length), *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage.
input_ids (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
attention_mask (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` de forme `(batch_size, target_sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée du décodeur dans le vocabulaire. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Quelles sont les identifiants d'entrée du décodeur ?](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.LongTensor` de forme `(batch_size, target_sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention à certains indices de jetons. Par défaut, un masque causal est utilisé afin de s'assurer que le modèle ne peut consulter que les entrées précédentes pour prédire le futur.
inputs_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer `input_ids`, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir les indices `input_ids` en vecteurs associés, par rapport à la matrice de recherche d'intégration interne du modèle.
labels (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Étiquettes pour le calcul de la perte de modélisation de langage masquée. Les indices doivent être compris dans `[0, ..., config.vocab_size]` ou égaux à -100 (voir la docstring de `input_ids`). Les jetons dont l'indice est défini sur `-100` sont ignorés (masqués) ; la perte n'est calculée que pour les jetons dont l'étiquette est comprise dans `[0, ..., config.vocab_size]`.
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
use_cache (`bool`, *facultatif*) : Si défini sur `True`, les états des valeurs de clé de `cache` sont renvoyés et peuvent être utilisés pour accélérer le décodage (voir `cache`).
mm_encoder_outputs (`~modeling_outputs.BaseModelOutputWithPooling`, *facultatif*) : Dict dont les clés sont les modalités prises en charge et les valeurs sont les sorties encodées pour cette modalité. Chaque sortie encodée est un tuple composé de (`pooler_output`, *facultatif* : `last_hidden_states`, *facultatif* : `hidden_states`, *facultatif* : `attentions`) `pooler_output` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) est une séquence de fonctionnalités multimodales de l'encodeur fusionnées dans les embeddings de texte.
**Retourne :** `InstructBlipVideoForConditionalGenerationModelOutput` ou `tuple(torch.Tensor)`
Un `InstructBlipVideoForConditionalGenerationModelOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([InstructBlipVideoConfig](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoConfig)) et les entrées.
La méthode forward de [InstructBlipVideoForConditionalGeneration](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoForConditionalGeneration) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor`, *facultatif*, renvoyé lorsque `labels` est fourni, `torch.Tensor` de forme `(1,)`) -- Perte de modélisation du langage issue du modèle de langage.
- **logits** (`torch.Tensor` de forme `(batch_size, sequence_length, config.vocab_size)`) -- Scores de prédiction de la tête de modélisation du langage du modèle de langage.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *facultatif*) -- Sorties de l'encodeur visuel.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *facultatif*) -- Sorties du Q-Former (Querying Transformer).
- **language_model_outputs** (`CausalLMOutputWithPast` ou `Seq2SeqLMOutput`) -- Sorties du modèle de langage.
Exemples :
```python
>>> from transformers import InstructBlipVideoProcessor, InstructBlipVideoForConditionalGeneration
>>> import torch
>>> from huggingface_hub import hf_hub_download
>>> import av
>>> import numpy as np
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> model = InstructBlipVideoForConditionalGeneration.from_pretrained("Salesforce/instructblip-vicuna-7b", device_map="auto")
>>> processor = InstructBlipVideoProcessor.from_pretrained("Salesforce/instructblip-vicuna-7b")
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample uniformly 4 frames from the video
>>> total_frames = container.streams.video[0].frames
>>> indices = np.arange(0, total_frames, total_frames / 4).astype(int)
>>> clip = read_video_pyav(container, indices)
>>> prompt = "What is happening in the video?"
>>> inputs = processor(text=prompt, images=clip, return_tensors="pt").to(model.device)
>>> outputs = model.generate(
... **inputs,
... do_sample=False,
... num_beams=5,
... max_length=256,
... repetition_penalty=1.5,
... length_penalty=1.0,
... )
>>> generated_text = processor.batch_decode(outputs, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
"A person is eating a bowl of pasta, and they are using a fork to eat it. The person is sitting at a table, and the plate of pasta is on the table in front"
```
#### generate[[transformers.InstructBlipVideoForConditionalGeneration.generate]]
```python
generate(pixel_values: Tensor, qformer_input_ids: typing.Optional[torch.LongTensor] = None, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **generate_kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L1262)
**Paramètres :**
pixel_values (`torch.Tensor` de forme (batch_size, num_channels, height, width) ou : (batch_size, num_frames, num_channels, height, width)) : Images ou vidéos d'entrée à traiter.
qformer_input_ids (`torch.LongTensor` de forme (batch_size, sequence_length), *facultatif*) : La séquence utilisée comme invite à fournir au module Q-Former.
qformer_attention_mask (`torch.LongTensor` de forme (batch_size, sequence_length), *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage.
input_ids (`torch.LongTensor` de forme (batch_size, sequence_length), *facultatif*) : La séquence utilisée comme invite pour la génération.
attention_mask (`torch.LongTensor` de forme (batch_size, sequence_length), *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage.
inputs_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) : Représentation intégrée des entrées. Doit être de type float, et non des jetons int.
interpolate_pos_encoding (`bool`, *facultatif*, par défaut `False`) : Indique s'il faut interpoler le codage positionnel des embeddings d'image.
**Retourne :** `captions (list)`
Une liste de chaînes de caractères de longueur batch_size * num_captions.
Remplace la fonction `generate` pour pouvoir utiliser le modèle comme générateur conditionnel.
#### get_video_features[[transformers.InstructBlipVideoForConditionalGeneration.get_video_features]]
```python
get_video_features(pixel_values: Tensor, qformer_input_ids: LongTensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/instructblipvideo/modeling_instructblipvideo.py#L1332)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d'entrée.
qformer_input_ids (`torch.LongTensor` de forme (batch_size, sequence_length)) : La séquence utilisée comme invite à fournir au module Q-Former.
qformer_attention_mask (`torch.LongTensor` de forme (batch_size, sequence_length), *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage.
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** `BaseModelOutputWithVisionQformerOutputs` ou `tuple(torch.Tensor)`
Un `BaseModelOutputWithVisionQformerOutputs` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([InstructBlipVideoConfig](/docs/transformers/main/fr/model_doc/instructblipvideo#transformers.InstructBlipVideoConfig)) et les entrées.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *facultatif*) -- Sorties de l'encodeur visuel.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`, *facultatif*) -- Sorties du Q-Former (Querying Transformer).
Exemple :
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, InstructBlipVideoForConditionalGeneration
>>> model = InstructBlipVideoForConditionalGeneration.from_pretrained("Salesforce/instructblip-flan-t5-xl")
>>> processor = AutoProcessor.from_pretrained("Salesforce/instructblip-flan-t5-xl")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```