# DETR conditionnel
## Aperçu
Le modèle Conditional DETR a été proposé dans [Conditional DETR for Fast Training Convergence](https://huggingface.co/papers/2108.06152) par Depu Meng, Xiaokang Chen, Zejia Fan, Gang Zeng, Houqiang Li, Yuhui Yuan, Lei Sun, Jingdong Wang. Conditional DETR présente un mécanisme d'attention croisée conditionnelle pour une formation rapide de DETR. Conditional DETR converge 6,7 à 10 fois plus vite que DETR.
L'abstract de l'article est le suivant :
*L’approche DETR, développée récemment, applique l’architecture encodeur-décodeur des transformers à la détection d’objets et obtient des performances prometteuses. Dans cet article, nous traitons le problème critique de la convergence lente de l’entraînement et présentons un mécanisme d’attention croisée conditionnelle pour un entraînement rapide de DETR. Notre approche est motivée par le fait que l’attention croisée dans DETR repose fortement sur les embeddings de contenu pour localiser les quatre extrémités et prédire la boîte, ce qui augmente le besoin d’embeddings de contenu de haute qualité et donc la difficulté de l’entraînement. Notre approche, nommée conditional DETR, apprend une requête spatiale conditionnelle à partir de l’embedding du décodeur pour l’attention croisée multi-têtes du décodeur. L’avantage est que, grâce à la requête spatiale conditionnelle, chaque tête d’attention croisée est en mesure de se concentrer sur une bande contenant une région distincte, par exemple une extrémité d’objet ou une région à l’intérieur de la boîte de l’objet. Cela restreint la plage spatiale pour localiser les régions distinctes pour la classification d’objets et la régression de boîte, réduisant ainsi la dépendance aux embeddings de contenu et facilitant l’entraînement. Les résultats empiriques montrent que conditional DETR converge 6,7× plus vite pour les backbones R50 et R101 et 10× plus vite pour les backbones plus puissants DC5-R50 et DC5-R101. Le code est disponible à l’adresse https://github.com/Atten4Vis/ConditionalDETR.*
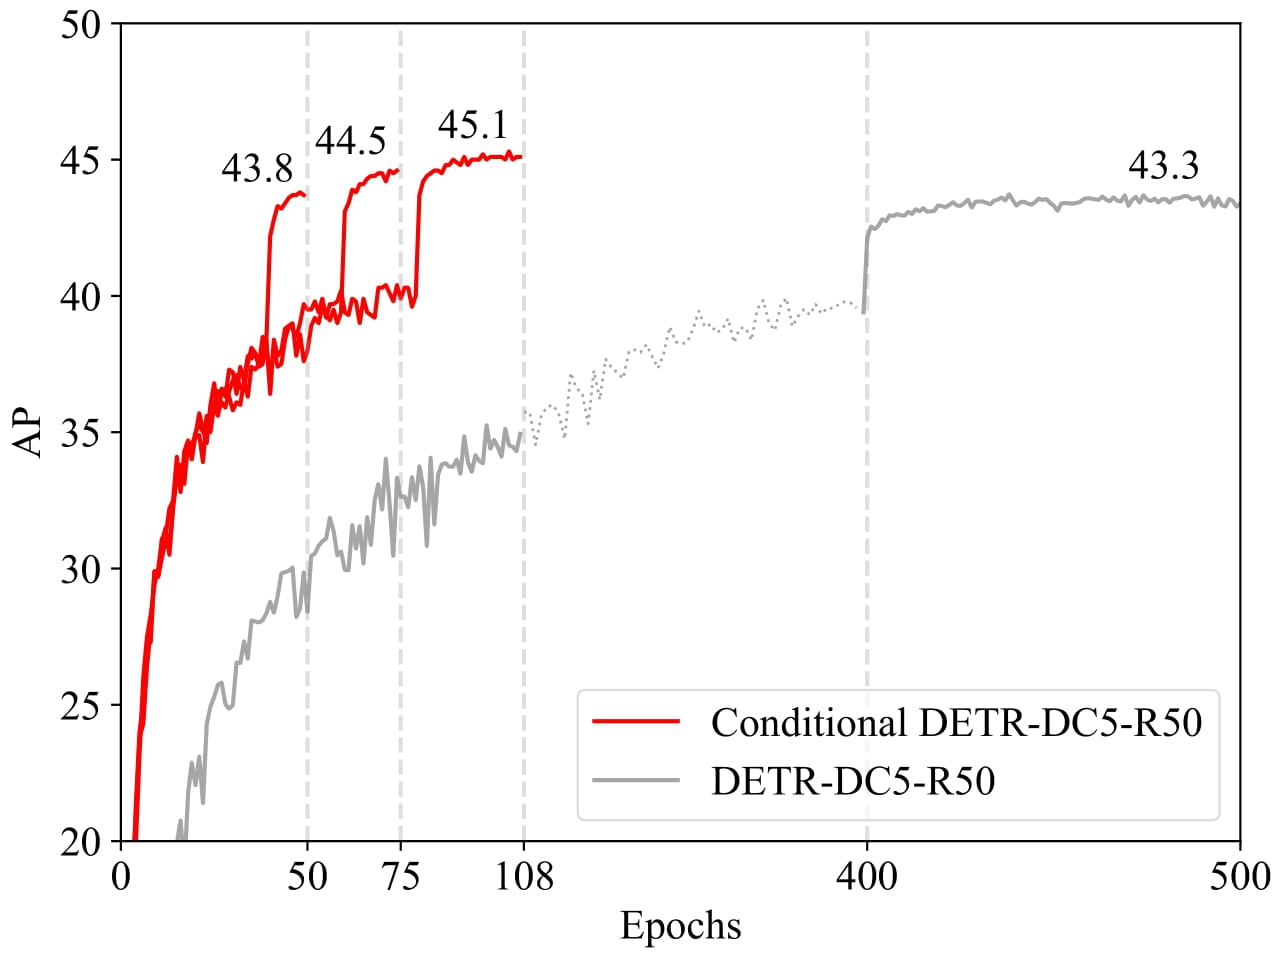 Conditional DETR présente une convergence beaucoup plus rapide par rapport à DETR d’origine. Tiré de l’article original.
Ce modèle a été contribué par [DepuMeng](https://huggingface.co/DepuMeng). Le code d'origine peut être trouvé [ici](https://github.com/Atten4Vis/ConditionalDETR).
## Ressources
- Voir aussi : [Guide de la tâche de détection d'objets](../tasks/object_detection).
## ConditionalDetrConfig[[transformers.ConditionalDetrConfig]]
#### transformers.ConditionalDetrConfig[[transformers.ConditionalDetrConfig]]
```python
transformers.ConditionalDetrConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_channels: int = 3, num_queries: int = 300, encoder_layers: int = 6, encoder_ffn_dim: int = 2048, encoder_attention_heads: int = 8, decoder_layers: int = 6, decoder_ffn_dim: int = 2048, decoder_attention_heads: int = 8, encoder_layerdrop: float | int = 0.0, decoder_layerdrop: float | int = 0.0, activation_function: str = 'relu', d_model: int = 256, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, init_std: float = 0.02, init_xavier_std: float = 1.0, auxiliary_loss: bool = False, position_embedding_type: str = 'sine', dilation: bool = False, class_cost: int = 2, bbox_cost: int = 5, giou_cost: int = 2, mask_loss_coefficient: int = 1, dice_loss_coefficient: int = 1, cls_loss_coefficient: int = 2, bbox_loss_coefficient: int = 5, giou_loss_coefficient: int = 2, focal_alpha: float = 0.25)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/configuration_conditional_detr.py#L25)
**Paramètres :**
is_encoder_decoder (`bool`, *facultatif*, valeur par défaut `True`) : Indique si le modèle est utilisé comme encodeur/décodeur ou non.
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : La configuration du modèle de base.
num_channels (`int`, *facultatif*, par défaut `3`) : Le nombre de canaux d'entrée.
num_queries (`int`, *facultatif*, valeur par défaut : 300) : Nombre de requêtes d'objets, c'est-à-dire de slots de détection. Il s'agit du nombre maximal d'objets que [ConditionalDetrModel](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrModel) peut détecter dans une image unique. Pour COCO, nous recommandons 100 requêtes.
encoder_layers (`int`, *facultatif*, valeur par défaut `6`) : Nombre de couches cachées dans l'encodeur Transformer. Utilise la même valeur que `num_layers` si non défini.
encoder_ffn_dim (`int`, *facultatif*, valeur par défaut `2048`) : Dimension de la couche « intermédiaire » (souvent appelée couche feed-forward) dans l'encodeur.
encoder_attention_heads (`int`, *facultatif*, valeur par défaut `8`) : Nombre de têtes d'attention pour chaque couche d'attention dans l'encodeur Transformer.
decoder_layers (`int`, *facultatif*, valeur par défaut `6`) : Nombre de couches cachées dans le décodeur Transformer. Utilise la même valeur que `num_layers` si non défini.
decoder_ffn_dim (`int`, *facultatif*, valeur par défaut `2048`) : Dimension de la couche « intermédiaire » (souvent appelée couche feed-forward) du décodeur.
decoder_attention_heads (`int`, *facultatif*, valeur par défaut `8`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
encoder_layerdrop (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Probabilité de LayerDrop pour l'encodeur. Consultez l'article [LayerDrop](see https://huggingface.co/papers/1909.11556) pour plus de détails.
decoder_layerdrop (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Probabilité de LayerDrop pour le décodeur. Consultez l'article [LayerDrop](see https://huggingface.co/papers/1909.11556) pour plus de détails.
activation_function (`str`, *facultatif*, par défaut `relu`) : Fonction d'activation non linéaire (fonction ou chaîne de caractères) du décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
d_model (`int`, *facultatif*, par défaut `256`) : Taille des couches d'encodeur et de la couche pooler.
dropout (`Union[float, int]`, *facultatif*, valeur par défaut `0.1`) : Le ratio pour toutes les couches de dropout.
attention_dropout (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout appliqué aux probabilités d'attention.
activation_dropout (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout pour les activations à l'intérieur de la couche entièrement connectée.
init_std (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
init_xavier_std (`float`, *facultatif*, par défaut `1.0`) : Le facteur d'échelle utilisé pour l'initialisation de Xavier des poids de l'attention croisée.
auxiliary_loss (`bool`, *facultatif*, par défaut `False`) : Indique si les pertes de décodage auxiliaires (perte à chaque couche du décodeur) doivent être utilisées.
position_embedding_type (`str`, *facultatif*, par défaut `"sine"`) : Type d'embeddings de position à utiliser sur les caractéristiques de l'image. Soit `"sine"` ou `"learned"`.
dilation (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut remplacer le pas (stride) par la dilatation dans le dernier bloc convolutif (DC5). Pris en charge uniquement lorsque `use_timm_backbone` = `True`.
class_cost (`int`, *facultatif*, valeur par défaut `2`) : Poids relatif de l'erreur de classification dans le coût d'appariement hongrois.
bbox_cost (`int`, *facultatif*, valeur par défaut `5`) : Poids relatif de l'erreur de boîte englobante L1 dans le coût d'appariement hongrois.
giou_cost (`int`, *facultatif*, valeur par défaut `2`) : Poids relatif de la perte d'IoU généralisée dans le coût d'appariement hongrois.
mask_loss_coefficient (`int`, *facultatif*, valeur par défaut `1`) : Poids relatif de la focal loss dans la perte de segmentation panoptique.
dice_loss_coefficient (`int`, *facultatif*, valeur par défaut `1`) : Poids relatif de la perte dice dans la perte de segmentation panoptique.
cls_loss_coefficient (`int`, *facultatif*, valeur par défaut `2`) : Poids relatif de la perte de classification dans la perte de segmentation panoptique.
bbox_loss_coefficient (`int`, *facultatif*, valeur par défaut `5`) : Poids relatif de la perte de boîte englobante L1 dans la perte de segmentation panoptique.
giou_loss_coefficient (`int`, *facultatif*, valeur par défaut `2`) : Poids relatif de la perte IoU généralisée dans la perte de segmentation panoptique.
focal_alpha (`float`, *facultatif*, valeur par défaut `0.25`) : Paramètre alpha de la focal loss.
Il s'agit de la classe de configuration destinée à stocker la configuration d'un ConditionalDetrModel. Elle est utilisée pour instancier un modèle Conditional Detr en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [microsoft/conditional-detr-resnet-50](https://huggingface.co/microsoft/conditional-detr-resnet-50)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemples :
```python
>>> from transformers import ConditionalDetrConfig, ConditionalDetrModel
>>> # Initializing a Conditional DETR microsoft/conditional-detr-resnet-50 style configuration
>>> configuration = ConditionalDetrConfig()
>>> # Initializing a model (with random weights) from the microsoft/conditional-detr-resnet-50 style configuration
>>> model = ConditionalDetrModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ConditionalDetrImageProcessor[[transformers.ConditionalDetrImageProcessor]]
#### transformers.ConditionalDetrImageProcessor[[transformers.ConditionalDetrImageProcessor]]
```python
transformers.ConditionalDetrImageProcessor(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/image_processing_conditional_detr.py#L428)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'shortest_edge' : 800, 'longest_edge': 1333}`) : Décrit les dimensions d'entrée maximales pour le modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `2`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.485, 0.456, 0.406]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.229, 0.224, 0.225]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
format (`str`, *kwargs*, *facultatif*, par défaut `AnnotationFormat.COCO_DETECTION`) : Format des données des annotations. L'une des valeurs "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Contrôle la conversion des annotations au format attendu par le modèle CONDITIONAL_DETR. Convertit les boîtes englobantes au format `(center_x, center_y, width, height)` et dans l'intervalle `[0, 1]`. Peut être remplacé par le paramètre `do_convert_annotations` de la méthode `preprocess`.
Construit un processeur d’images ConditionalDetrImageProcessor.
#### prétraiter[[transformers.ConditionalDetrImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/image_processing_conditional_detr.py#L683)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
annotations (`AnnotationType` ou `list[AnnotationType]`, *facultatif*) : Annotations à transformer en fonction du bourrage appliqué aux images.
return_segmentation_masks (`bool`, *facultatif*, par défaut `self.return_segmentation_masks`) : Indique s'il faut retourner les masques de segmentation.
masks_path (`str` ou `pathlib.Path`, *facultatif*) : Chemin vers le répertoire contenant les masques de segmentation.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
format (`str`, *kwargs*, *facultatif*, par défaut `AnnotationFormat.COCO_DETECTION`) : Format des données des annotations. L'une des valeurs "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Contrôle la conversion des annotations au format attendu par le modèle CONDITIONAL_DETR. Convertit les boîtes englobantes au format `(center_x, center_y, width, height)` et dans l'intervalle `[0, 1]`. Peut être remplacé par le paramètre `do_convert_annotations` de la méthode `preprocess`.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
## ConditionalDetrImageProcessorPil[[transformers.ConditionalDetrImageProcessorPil]]
#### transformers.ConditionalDetrImageProcessorPil[[transformers.ConditionalDetrImageProcessorPil]]
```python
transformers.ConditionalDetrImageProcessorPil(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/image_processing_pil_conditional_detr.py#L429)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'shortest_edge' : 800, 'longest_edge': 1333}`) : Décrit les dimensions d'entrée maximales pour le modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `2`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.485, 0.456, 0.406]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.229, 0.224, 0.225]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
format (`str`, *kwargs*, *facultatif*, par défaut `AnnotationFormat.COCO_DETECTION`) : Format des données des annotations. L'une des valeurs "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Contrôle la conversion des annotations au format attendu par le modèle CONDITIONAL_DETR. Convertit les boîtes englobantes au format `(center_x, center_y, width, height)` et dans l'intervalle `[0, 1]`. Peut être remplacé par le paramètre `do_convert_annotations` de la méthode `preprocess`.
Construit un processeur d’images ConditionalDetrImageProcessor.
#### prétraiter[[transformers.ConditionalDetrImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/image_processing_pil_conditional_detr.py#L697)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
annotations (`AnnotationType` ou `list[AnnotationType]`, *facultatif*) : Annotations à transformer en fonction du bourrage appliqué aux images.
return_segmentation_masks (`bool`, *facultatif*, par défaut `self.return_segmentation_masks`) : Indique s'il faut retourner les masques de segmentation.
masks_path (`str` ou `pathlib.Path`, *facultatif*) : Chemin vers le répertoire contenant les masques de segmentation.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
format (`str`, *kwargs*, *facultatif*, par défaut `AnnotationFormat.COCO_DETECTION`) : Format des données des annotations. L'une des valeurs "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Contrôle la conversion des annotations au format attendu par le modèle CONDITIONAL_DETR. Convertit les boîtes englobantes au format `(center_x, center_y, width, height)` et dans l'intervalle `[0, 1]`. Peut être remplacé par le paramètre `do_convert_annotations` de la méthode `preprocess`.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
#### post_process_object_detection[[transformers.ConditionalDetrImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs, threshold: float = 0.5, target_sizes: transformers.utils.generic.TensorType | list[tuple] = None, top_k: int = 100)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/image_processing_pil_conditional_detr.py#L842)
**Paramètres :**
outputs (`ConditionalDetrObjectDetectionOutput`) : Sorties brutes du modèle.
threshold (`float`, *facultatif*) : Seuil de score à appliquer pour conserver les prédictions de détection d'objets.
target_sizes (`torch.Tensor` ou `list[tuple[int, int]]`, *facultatif*) : Tenseur de forme `(batch_size, 2)` ou liste de tuples (`tuple[int, int]`) contenant la taille cible (hauteur, largeur) de chaque image du lot. Si laissé à None, les prédictions ne seront pas redimensionnées.
top_k (`int`, *facultatif*, valeur par défaut 100) : Conserver uniquement les k premières boîtes englobantes avant le filtrage par seuillage.
**Retourne :** `list[Dict]`
Une liste de dictionnaires, chaque dictionnaire contenant les scores, les étiquettes et les boîtes pour une image du lot, tels que prédits par le modèle.
Convertit la sortie brute de [ConditionalDetrForObjectDetection](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrForObjectDetection) en boîtes englobantes finales au format (top_left_x, top_left_y, bottom_right_x, bottom_right_y). Prend uniquement en charge PyTorch.
#### post_process_instance_segmentation[[transformers.ConditionalDetrImageProcessorPil.post_process_instance_segmentation]]
```python
post_process_instance_segmentation(outputs, threshold: float = 0.5, mask_threshold: float = 0.5, overlap_mask_area_threshold: float = 0.8, target_sizes: list[tuple[int, int]] | None = None, return_coco_annotation: bool | None = False)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/image_processing_pil_conditional_detr.py#L974)
**Paramètres :**
outputs ([ConditionalDetrForSegmentation](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrForSegmentation)) : Sorties brutes du modèle.
threshold (`float`, *facultatif*, valeur par défaut 0,5) : Seuil de score de probabilité pour conserver les masques d'instances prédits.
mask_threshold (`float`, *facultatif*, valeur par défaut 0,5) : Seuil à utiliser pour convertir les masques prédits en valeurs binaires.
overlap_mask_area_threshold (`float`, *facultatif*, valeur par défaut 0.8) : Seuil de la zone du masque de chevauchement pour fusionner ou supprimer les petites parties déconnectées au sein de chaque masque d'instance binaire.
target_sizes (`list[Tuple]`, *facultatif*) : Liste de longueur (batch_size), où chaque élément de la liste (`tuple[int, int]]`) correspond à la taille finale demandée (hauteur, largeur) de chaque prédiction. Si non défini, les prédictions ne seront pas redimensionnées.
return_coco_annotation (`bool`, *facultatif*) : La valeur par défaut est `False`. Si défini sur `True`, les cartes de segmentation sont renvoyées au format d'encodage par longueur de course (RLE) de COCO.
**Retourne :** `list[Dict]`
Une liste de dictionnaires, un par image, chaque dictionnaire contenant deux clés :
- **segmentation** -- Un tenseur de forme `(height, width)` où chaque pixel représente un `segment_id` ou un encodage par longueur d'exécution (RLE) de type `list[List]` de la carte de segmentation si return_coco_annotation est défini sur `True`. Défini sur `None` si aucun masque n'est trouvé au-dessus du `threshold`.
- **segments_info** -- Un dictionnaire contenant des informations supplémentaires sur chaque segment.
- **id** -- Un entier représentant le `segment_id`.
- **label_id** -- Un entier représentant l'identifiant de la classe sémantique / de l'étiquette correspondant à `segment_id`.
- **score** -- Score de prédiction du segment portant l'`segment_id`.
Convertit la sortie de [ConditionalDetrForSegmentation](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrForSegmentation) en prédictions de segmentation d'instances. Prend uniquement en charge PyTorch.
#### post_process_semantic_segmentation[[transformers.ConditionalDetrImageProcessorPil.post_process_semantic_segmentation]]
```python
post_process_semantic_segmentation(outputs, target_sizes: list[tuple[int, int]] | None = None, return_segmentation_scores: bool = False)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/image_processing_pil_conditional_detr.py#L902)
**Paramètres :**
outputs ([ConditionalDetrForSegmentation](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrForSegmentation)) : Sorties brutes du modèle.
target_sizes (`list[tuple[int, int]]`, *facultatif*) : Une liste de tuples (`tuple[int, int]`) contenant la taille cible (hauteur, largeur) de chaque image du lot. Si non défini, les prédictions ne seront pas redimensionnées.
return_segmentation_scores (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut retourner les scores de segmentation en plus de la carte de segmentation. Si `True`, chaque élément de la liste retournée est un `SemanticSegmentationPostProcessorOutput` avec les champs `segmentation` (identifiants de classes, forme `(height, width)`) et `segmentation_scores` (forme `(num_classes, height, width)`).
**Retourne :** `list[torch.Tensor]` ou `list[SemanticSegmentationPostProcessorOutput]`
Lorsque `return_segmentation_scores=False` (par défaut), une liste de longueur `batch_size` où chaque élément est une carte de segmentation de forme `(height, width)` avec des identifiants de classes. Lorsque `return_segmentation_scores=True`, une liste de `SemanticSegmentationPostProcessorOutput` avec les champs `segmentation` (identifiants de classes, forme `(height, width)`) et `segmentation_scores` (forme `(num_classes, height, width)`). Dans les deux cas, `(height, width)` correspond à la taille cible (si `target_sizes` est spécifiée).
Convertit la sortie de [ConditionalDetrForSegmentation](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrForSegmentation) en cartes de segmentation sémantique. Prend uniquement en charge PyTorch.
#### post_process_panoptic_segmentation[[transformers.ConditionalDetrImageProcessorPil.post_process_panoptic_segmentation]]
```python
post_process_panoptic_segmentation(outputs, threshold: float = 0.5, mask_threshold: float = 0.5, overlap_mask_area_threshold: float = 0.8, label_ids_to_fuse: set[int] | None = None, target_sizes: list[tuple[int, int]] | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/image_processing_pil_conditional_detr.py#L1058)
**Paramètres :**
outputs ([ConditionalDetrForSegmentation](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrForSegmentation)) : Les sorties de [ConditionalDetrForSegmentation](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrForSegmentation).
threshold (`float`, *facultatif*, valeur par défaut 0,5) : Seuil de score de probabilité pour conserver les masques d'instances prédits.
mask_threshold (`float`, *facultatif*, valeur par défaut 0,5) : Seuil à utiliser pour convertir les masques prédits en valeurs binaires.
overlap_mask_area_threshold (`float`, *facultatif*, valeur par défaut 0.8) : Seuil de la zone du masque de chevauchement pour fusionner ou supprimer les petites parties déconnectées au sein de chaque masque d'instance binaire.
label_ids_to_fuse (`Set[int]`, *facultatif*) : Les étiquettes de cet état verront toutes leurs instances fusionnées ensemble. Par exemple, on peut affirmer qu'une image ne peut contenir qu'un seul ciel, mais plusieurs personnes ; l'identifiant de l'étiquette « sky » serait donc présent dans cet ensemble, mais pas celui de « person ».
target_sizes (`list[Tuple]`, *facultatif*) : Liste de longueur (batch_size), où chaque élément de la liste (`tuple[int, int]]`) correspond à la taille finale demandée (hauteur, largeur) de chaque prédiction du lot. Si non défini, les prédictions ne seront pas redimensionnées.
**Retourne :** `list[Dict]`
Une liste de dictionnaires, un par image, chaque dictionnaire contenant deux clés :
- **segmentation** -- un tenseur de forme `(height, width)` où chaque pixel représente un `segment_id` ou `None` si aucun masque n'est trouvé au-dessus du `threshold`. Si `target_sizes` est spécifié, la segmentation est redimensionnée à l'entrée correspondante de `target_sizes`.
- **segments_info** -- Un dictionnaire contenant des informations supplémentaires sur chaque segment.
- **id** -- un entier représentant le `segment_id`.
- **label_id** -- Un entier représentant l'identifiant de la classe sémantique / de l'étiquette correspondant à `segment_id`.
- **was_fused** -- un booléen, `True` si `label_id` était présent dans `label_ids_to_fuse`, `False` sinon. Plusieurs instances de la même classe / étiquette ont été fusionnées et se sont vu attribuer un unique `segment_id`.
- **score** -- Score de prédiction du segment portant l'`segment_id`.
Convertit la sortie de [ConditionalDetrForSegmentation](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrForSegmentation) en prédictions de segmentation panoptique d’images. Prend uniquement en charge PyTorch.
## ConditionalDetrModel[[transformers.ConditionalDetrModel]]
#### transformers.ConditionalDetrModel[[transformers.ConditionalDetrModel]]
```python
transformers.ConditionalDetrModel(config: ConditionalDetrConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/modeling_conditional_detr.py#L1337)
**Paramètres :**
config ([ConditionalDetrConfig](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle CONDITIONAL_DETR brut (composé d'un backbone et d'un Transformer encodeur-décodeur) qui produit des états cachés bruts sans aucune tête spécifique au sommet.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.ConditionalDetrModel.forward]]
```python
forward(pixel_values: Tensor, pixel_mask: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/modeling_conditional_detr.py#L1366)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d'entrée. Les valeurs des pixels peuvent être obtenues à l'aide de `image_processor_class`. Consultez `image_processor_class.__call__` pour plus de détails (`processor_class` utilise `image_processor_class` pour le traitement des images).
pixel_mask (`torch.LongTensor` de forme `(batch_size, height, width)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux valeurs de pixels de bourrage. Les valeurs du masque sont comprises dans `[0, 1]` : - 1 pour les pixels réels (c.-à-d. **non masqués**), - 0 pour les pixels de bourrage (c.-à-d. **masqués**). [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
decoder_attention_mask (`torch.Tensor` de forme `(batch_size, num_queries)`, *facultatif*) : Non utilisé par défaut. Peut être utilisé pour masquer les requêtes d'objets.
encoder_outputs (`torch.Tensor`, *facultatif*) : Tuple composé de (`last_hidden_state`, *facultatif* : `hidden_states`, *facultatif* : `attentions`) `last_hidden_state` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) est une séquence d'états cachés à la sortie de la dernière couche de l'encodeur. Utilisé dans l'attention croisée du décodeur.
inputs_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer la carte de caractéristiques aplatie (sortie du backbone + couche de projection), vous pouvez choisir de passer directement une représentation aplatie d'une image.
decoder_inputs_embeds (`torch.Tensor` de forme `(batch_size, num_queries, hidden_size)`, *facultatif*) : Facultativement, au lieu d’initialiser les requêtes avec un tenseur de zéros, vous pouvez choisir de passer directement une représentation intégrée.
**Retourne :** `ConditionalDetrModelOutput` ou `tuple(torch.Tensor)`
Un `ConditionalDetrModelOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration (`None`) et les entrées.
La méthode forward du modèle [ConditionalDetrModel](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du décodeur du modèle.
Si `cache` est utilisé, seule la dernière hidden-state des séquences de forme `(batch_size, 1, hidden_size)` est renvoyée.
- **cache** (`EncoderDecoderCache`, *facultatif*, renvoyé lorsque `use_cache=True` est passé ou lorsque `config.use_cache=True`) -- Il s'agit d'une instance de [EncoderDecoderCache](/docs/transformers/main/fr/internal/generation_utils#transformers.EncoderDecoderCache). Pour plus de détails, consultez notre [guide sur le cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contient des états cachés précalculés (clés et valeurs dans les blocs d'auto-attention et dans les blocs d'attention croisée) qui peuvent être utilisés (voir l'entrée `cache`) pour accélérer le décodage séquentiel.
- **decoder_hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du décodeur à la sortie de chaque couche, plus les sorties d'incorporation initiale facultatives.
- **decoder_attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **cross_attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
- **encoder_last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) -- Séquence d'états cachés à la sortie de la dernière couche de l'encodeur du modèle.
- **encoder_hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés de l'encodeur à la sortie de chaque couche, plus les sorties d'incorporation initiales facultatives.
- **encoder_attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de l'encodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **intermediate_hidden_states** (`torch.Tensor` de forme `(config.decoder_layers, batch_size, sequence_length, hidden_size)`, *facultatif*, renvoyé lorsque `config.auxiliary_loss=True`) -- Activations intermédiaires du décodeur, c'est-à-dire la sortie de chaque couche du décodeur, chacune ayant passé par une normalisation de couche (layernorm).
- **reference_points** (`torch.Tensor` de forme `(config.decoder_layers, batch_size, num_queries, 2 (anchor points))`) -- Points de référence (points de référence de chaque couche du décodeur).
Exemples :
```python
>>> from transformers import AutoImageProcessor, AutoModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/conditional-detr-resnet-50")
>>> model = AutoModel.from_pretrained("microsoft/conditional-detr-resnet-50")
>>> # prepare image for the model
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**inputs)
>>> # the last hidden states are the final query embeddings of the Transformer decoder
>>> # these are of shape (batch_size, num_queries, hidden_size)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 300, 256]
```
## ConditionalDetrForObjectDetection[[transformers.ConditionalDetrForObjectDetection]]
#### transformers.ConditionalDetrForObjectDetection[[transformers.ConditionalDetrForObjectDetection]]
```python
transformers.ConditionalDetrForObjectDetection(config: ConditionalDetrConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/modeling_conditional_detr.py#L1509)
**Paramètres :**
config ([ConditionalDetrConfig](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Modèle CONDITIONAL_DETR (composé d'un backbone et d'un Transformer encodeur-décodeur) avec des têtes de détection d'objets au sommet, pour des tâches telles que la détection COCO.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.ConditionalDetrForObjectDetection.forward]]
```python
forward(pixel_values: Tensor, pixel_mask: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, labels: list[dict] | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/modeling_conditional_detr.py#L1523)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d'entrée. Les valeurs des pixels peuvent être obtenues à l'aide de `image_processor_class`. Consultez `image_processor_class.__call__` pour plus de détails (`processor_class` utilise `image_processor_class` pour le traitement des images).
pixel_mask (`torch.LongTensor` de forme `(batch_size, height, width)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux valeurs de pixels de bourrage. Les valeurs du masque sont comprises dans `[0, 1]` : - 1 pour les pixels réels (c.-à-d. **non masqués**), - 0 pour les pixels de bourrage (c.-à-d. **masqués**). [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
decoder_attention_mask (`torch.Tensor` de forme `(batch_size, num_queries)`, *facultatif*) : Non utilisé par défaut. Peut être utilisé pour masquer les requêtes d'objets.
encoder_outputs (`torch.Tensor`, *facultatif*) : Tuple composé de (`last_hidden_state`, *facultatif* : `hidden_states`, *facultatif* : `attentions`) `last_hidden_state` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) est une séquence d'états cachés à la sortie de la dernière couche de l'encodeur. Utilisé dans l'attention croisée du décodeur.
inputs_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer la carte de caractéristiques aplatie (sortie du backbone + couche de projection), vous pouvez choisir de passer directement une représentation aplatie d'une image.
decoder_inputs_embeds (`torch.Tensor` de forme `(batch_size, num_queries, hidden_size)`, *facultatif*) : Facultativement, au lieu d’initialiser les requêtes avec un tenseur de zéros, vous pouvez choisir de passer directement une représentation intégrée.
labels (`list[Dict]` de longueur `(batch_size,)`, *facultatif*) : Étiquettes pour le calcul de la perte de correspondance bipartite. Liste de dictionnaires, chaque dictionnaire contenant au moins les 2 clés suivantes : 'class_labels' et 'boxes' (les étiquettes de classes et les boîtes englobantes d'une image du lot, respectivement). Les étiquettes de classes elles-mêmes doivent être un `torch.LongTensor` de longueur `(number of bounding boxes in the image,)` et les boîtes un `torch.Tensor` de forme `(number of bounding boxes in the image, 4)`.
**Retourne :** `ConditionalDetrObjectDetectionOutput` ou `tuple(torch.Tensor)`
Un `ConditionalDetrObjectDetectionOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration (`None`) et les entrées.
La méthode forward de [ConditionalDetrForObjectDetection](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrForObjectDetection) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni)) -- Perte totale en tant que combinaison linéaire d'une négation de la log-vraisemblance (entropie croisée) pour la prédiction de classe et d'une perte de boîte englobante. Cette dernière est définie comme une combinaison linéaire de la perte L1 et de la perte d'IoU généralisée insensible à l'échelle.
- **loss_dict** (`Dict`, *facultatif*) -- Un dictionnaire contenant les pertes individuelles. Utile pour la journalisation.
- **logits** (`torch.Tensor` de forme `(batch_size, num_queries, num_classes + 1)`) -- Logits de classification (y compris no-object) pour toutes les requêtes.
- **pred_boxes** (`torch.Tensor` de forme `(batch_size, num_queries, 4)`) -- Coordonnées des boîtes normalisées pour toutes les requêtes, représentées sous la forme (center_x, center_y, width, height). Ces valeurs sont normalisées dans [0, 1], par rapport à la taille de chaque image individuelle du lot (en ignorant tout padding éventuel). Vous pouvez utiliser `post_process_object_detection()` pour récupérer les boîtes englobantes non normalisées.
- **auxiliary_outputs** (`list[Dict]`, *facultatif*) -- Facultatif, renvoyé uniquement lorsque les pertes auxiliaires sont activées (c.-à-d. `config.auxiliary_loss` est défini sur `True`) et que des étiquettes sont fournies. C'est une liste de dictionnaires contenant les deux clés ci-dessus (`logits` et `pred_boxes`) pour chaque couche du décodeur.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) -- Séquence d'états cachés à la sortie de la dernière couche du décodeur du modèle.
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du décodeur à la sortie de chaque couche, plus les sorties de l'intégration initiale.
- **decoder_attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **cross_attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
- **encoder_last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) -- Séquence d'états cachés à la sortie de la dernière couche de l'encodeur du modèle.
- **encoder_hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés de l'encodeur à la sortie de chaque couche, plus les sorties des embeddings initiaux.
- **encoder_attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de l'encodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from transformers import AutoImageProcessor, AutoModelForObjectDetection
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/conditional-detr-resnet-50")
>>> model = AutoModelForObjectDetection.from_pretrained("microsoft/conditional-detr-resnet-50")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> target_sizes = torch.tensor([image.size[::-1]])
>>> results = image_processor.post_process_object_detection(outputs, threshold=0.5, target_sizes=target_sizes)[
... 0
... ]
>>> for score, label, box in zip(results["scores"], results["labels"], results["boxes"]):
... box = [round(i, 2) for i in box.tolist()]
... print(
... f"Detected {model.config.id2label[label.item()]} with confidence "
... f"{round(score.item(), 3)} at location {box}"
... )
Detected remote with confidence 0.833 at location [38.31, 72.1, 177.63, 118.45]
Detected cat with confidence 0.831 at location [9.2, 51.38, 321.13, 469.0]
Detected cat with confidence 0.804 at location [340.3, 16.85, 642.93, 370.95]
Detected remote with confidence 0.683 at location [334.48, 73.49, 366.37, 190.01]
Detected couch with confidence 0.535 at location [0.52, 1.19, 640.35, 475.1]
```
## ConditionalDetrForSegmentation[[transformers.ConditionalDetrForSegmentation]]
#### transformers.ConditionalDetrForSegmentation[[transformers.ConditionalDetrForSegmentation]]
```python
transformers.ConditionalDetrForSegmentation(config: ConditionalDetrConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/modeling_conditional_detr.py#L1650)
**Paramètres :**
config ([ConditionalDetrConfig](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Modèle CONDITIONAL_DETR (composé d'un backbone et d'un Transformer encodeur-décodeur) avec une tête de segmentation au sommet, pour des tâches telles que la segmentation panoptique COCO.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.ConditionalDetrForSegmentation.forward]]
```python
forward(pixel_values: Tensor, pixel_mask: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, labels: list[dict] | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/conditional_detr/modeling_conditional_detr.py#L1672)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d'entrée. Les valeurs des pixels peuvent être obtenues à l'aide de `image_processor_class`. Consultez `image_processor_class.__call__` pour plus de détails (`processor_class` utilise `image_processor_class` pour le traitement des images).
pixel_mask (`torch.LongTensor` de forme `(batch_size, height, width)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux valeurs de pixels de bourrage. Les valeurs du masque sont comprises dans `[0, 1]` : - 1 pour les pixels réels (c.-à-d. **non masqués**), - 0 pour les pixels de bourrage (c.-à-d. **masqués**). [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
decoder_attention_mask (`torch.Tensor` de forme `(batch_size, num_queries)`, *facultatif*) : Masque pour éviter d'effectuer l'attention sur certaines requêtes d'objets dans le décodeur. Les valeurs du masque sont sélectionnées dans `[0, 1]` : - 1 pour les requêtes qui ne sont **pas masquées**, - 0 pour les requêtes qui sont **masquées**.
encoder_outputs (`torch.Tensor`, *facultatif*) : Tuple composé de (`last_hidden_state`, *facultatif* : `hidden_states`, *facultatif* : `attentions`) `last_hidden_state` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) est une séquence d'états cachés à la sortie de la dernière couche de l'encodeur. Utilisé dans l'attention croisée du décodeur.
inputs_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Conservé pour la compatibilité ascendante, mais ne peut pas être utilisé pour la segmentation, car celle-ci nécessite des caractéristiques multi-échelles issues du backbone, qui ne sont pas disponibles lorsqu'on le contourne via inputs_embeds.
decoder_inputs_embeds (`torch.Tensor` de forme `(batch_size, num_queries, hidden_size)`, *facultatif*) : Facultativement, au lieu d'initialiser les requêtes avec un tenseur de zéros, vous pouvez choisir de passer directement une représentation intégrée. Utile pour les tâches nécessitant une initialisation personnalisée des requêtes.
labels (`list[Dict]` de longueur `(batch_size,)`, *facultatif*) : Étiquettes pour le calcul de la perte de correspondance bipartite, de la perte DICE/F-1 et de la perte Focal. Liste de dictionnaires, chaque dictionnaire contenant au moins les 3 clés suivantes : 'class_labels', 'boxes' et 'masks' (respectivement les étiquettes de classes, les boîtes englobantes et les masques de segmentation d'une image du lot). Les étiquettes de classes elles-mêmes doivent être un `torch.LongTensor` de longueur `(number of bounding boxes in the image,)`, les boîtes un `torch.Tensor` de forme `(number of bounding boxes in the image, 4)` et les masques un `torch.Tensor` de forme `(number of bounding boxes in the image, height, width)`.
**Retourne :** `ConditionalDetrSegmentationOutput` ou `tuple(torch.Tensor)`
Un `ConditionalDetrSegmentationOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration (`None`) et les entrées.
La méthode forward de [ConditionalDetrForSegmentation](/docs/transformers/main/fr/model_doc/conditional_detr#transformers.ConditionalDetrForSegmentation) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni)) -- Perte totale en tant que combinaison linéaire d'une négation de la log-vraisemblance (entropie croisée) pour la prédiction de classe et d'une perte de boîte englobante. Cette dernière est définie comme une combinaison linéaire de la perte L1 et de la perte d'IoU généralisée insensible à l'échelle.
- **loss_dict** (`Dict`, *facultatif*) -- Un dictionnaire contenant les pertes individuelles. Utile pour la journalisation.
- **logits** (`torch.Tensor` de forme `(batch_size, num_queries, num_classes + 1)`) -- Logits de classification (y compris no-object) pour toutes les requêtes.
- **pred_boxes** (`torch.Tensor` de forme `(batch_size, num_queries, 4)`) -- Coordonnées des boîtes normalisées pour toutes les requêtes, représentées sous la forme (center_x, center_y, width, height). Ces valeurs sont normalisées dans [0, 1], par rapport à la taille de chaque image individuelle du lot (en ignorant tout padding éventuel). Vous pouvez utiliser `post_process_object_detection()` pour récupérer les boîtes englobantes non normalisées.
- **pred_masks** (`torch.Tensor` de forme `(batch_size, num_queries, height/4, width/4)`) -- Logits des masques de segmentation pour toutes les requêtes. Consultez également `post_process_semantic_segmentation()` ou `post_process_instance_segmentation()` `post_process_panoptic_segmentation()` pour évaluer respectivement les masques de segmentation sémantique, d'instance et panoptique.
- **auxiliary_outputs** (`list[Dict]`, *facultatif*) -- Facultatif, renvoyé uniquement lorsque les pertes auxiliaires sont activées (c.-à-d. `config.auxiliary_loss` est défini sur `True`) et que des étiquettes sont fournies. C'est une liste de dictionnaires contenant les deux clés ci-dessus (`logits` et `pred_boxes`) pour chaque couche du décodeur.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) -- Séquence d'états cachés à la sortie de la dernière couche du décodeur du modèle.
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du décodeur à la sortie de chaque couche, plus les sorties de l'intégration initiale.
- **decoder_attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **cross_attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
- **encoder_last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) -- Séquence d'états cachés à la sortie de la dernière couche de l'encodeur du modèle.
- **encoder_hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés de l'encodeur à la sortie de chaque couche, plus les sorties des embeddings initiaux.
- **encoder_attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de l'encodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> import io
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> import numpy
>>> from transformers import AutoImageProcessor, ConditionalDetrForSegmentation
>>> from transformers.image_transforms import rgb_to_id
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/conditional_detr-resnet-50-panoptic")
>>> model = ConditionalDetrForSegmentation.from_pretrained("facebook/conditional_detr-resnet-50-panoptic")
>>> # prepare image for the model
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**inputs)
>>> # Use the `post_process_panoptic_segmentation` method of the `image_processor` to retrieve post-processed panoptic segmentation maps
>>> # Segmentation results are returned as a list of dictionaries
>>> result = image_processor.post_process_panoptic_segmentation(outputs, target_sizes=[(300, 500)])
>>> # A tensor of shape (height, width) where each value denotes a segment id, filled with -1 if no segment is found
>>> panoptic_seg = result[0]["segmentation"]
>>> panoptic_seg.shape
torch.Size([300, 500])
>>> # Get prediction score and segment_id to class_id mapping of each segment
>>> panoptic_segments_info = result[0]["segments_info"]
>>> len(panoptic_segments_info)
5
```