# TrOCR
[TrOCR](https://huggingface.co/papers/2109.10282)는 이미지 이해와 텍스트 생성 모두를 위한 텍스트 인식 모델입니다. 이미지 처리나 문자 생성을 위한 별도의 모델이 필요하지 않습니다. TrOCR는 트랜스포머를 사용하여 시각적 이해와 텍스트 생성을 처리하는 단순한 단일 엔드투엔드 시스템입니다.
모든 원본 TrOCR 체크포인트는 [Microsoft](https://huggingface.co/microsoft/models?search=trocr) 조직에서 찾을 수 있습니다.
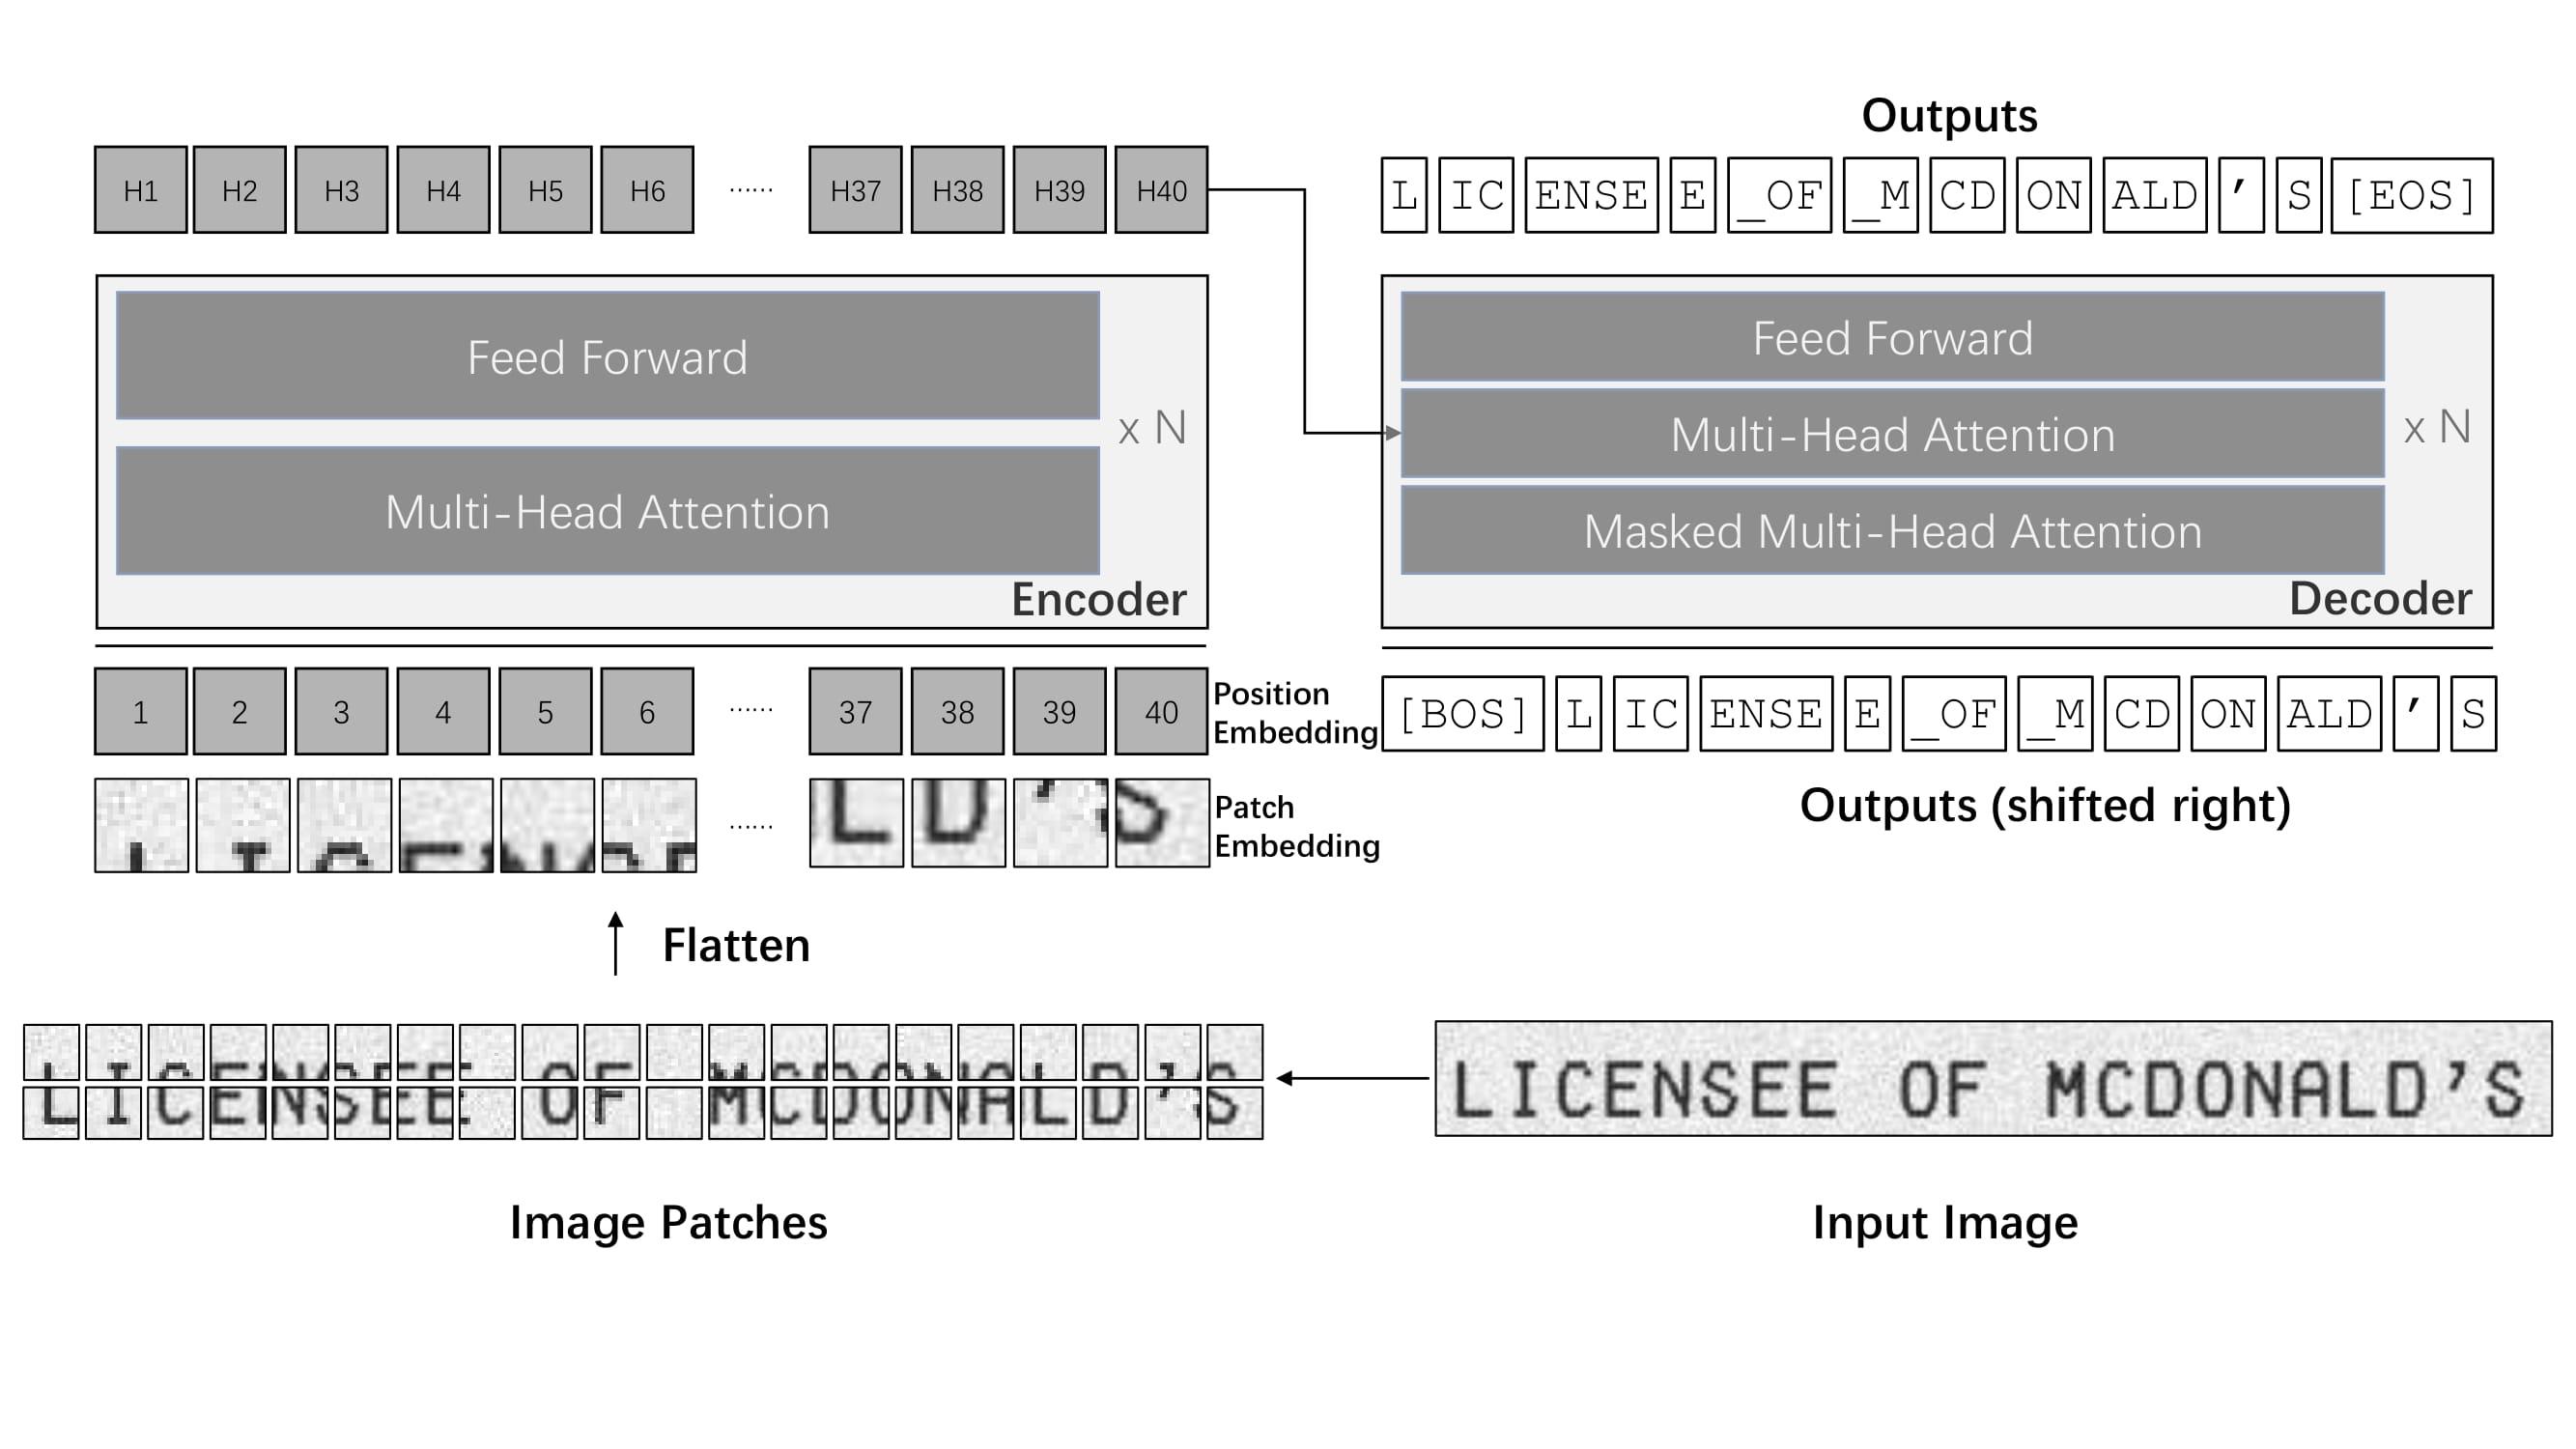 TrOCR 아키텍처. 원 논문에서 가져왔습니다.
> [!TIP]
> 이 모델은 [nielsr](https://huggingface.co/nielsr)에 의해 기여되었습니다.
>
> TrOCR 모델을 적용하여 다양한 이미지 및 텍스트 작업을 수행하는 방법에 대한 추가 예제는 오른쪽 사이드바의 TrOCR 모델 항목을 클릭하여 확인하세요.
아래 예제는 [AutoModel](/docs/transformers/v5.23.0/ko/model_doc/auto#transformers.AutoModel) 클래스를 사용하여 광학 문자 인식(OCR)을 수행하는 방법을 보여줍니다.
```python
import requests
from PIL import Image
from transformers import TrOCRProcessor, VisionEncoderDecoderModel
processor = TrOCRProcessor.from_pretrained("microsoft/trocr-base-handwritten")
model = VisionEncoderDecoderModel.from_pretrained("microsoft/trocr-base-handwritten", device_map="auto")
# load image from the IAM dataset
url = "https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
generated_ids = model.generate(pixel_values)
generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
print(generated_text)
```
## 양자화
Quantization은 가중치를 더 낮은 정밀도로 표현하여 대규모 모델의 메모리 부담을 줄입니다. 사용 가능한 다른 양자화 백엔드에 대해서는 [Quantization](../quantization/overview) 개요를 참조하세요.
아래 예제는 [bitsandbytes](../quantization/bitsandbytes)를 사용하여 가중치를 8비트로 양자화합니다.
```python
# pip install bitsandbytes accelerate
from transformers import TrOCRProcessor, VisionEncoderDecoderModel, BitsandBytesConfig
import requests
from PIL import Image
# Set up the quantization configuration
quantization_config = BitsandBytesConfig(load_in_8bit=True)
# Use a large checkpoint for a more noticeable impact
processor = TrOCRProcessor.from_pretrained("microsoft/trocr-large-handwritten")
model = VisionEncoderDecoderModel.from_pretrained(
"microsoft/trocr-large-handwritten",
quantization_config=quantization_config
device_map="auto")
# load image from the IAM dataset
url = "[https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg](https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg)"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
generated_ids = model.generate(pixel_values)
generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
print(generated_text)
```
## The input is a single word "Notes".
참고
- TrOCR은 [ViTImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/vit#transformers.ViTImageProcessor)/[DeiTImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/deit#transformers.DeiTImageProcessor)와 [RobertaTokenizer](/docs/transformers/v5.23.0/ko/model_doc/led#transformers.RobertaTokenizer)/[XLMRobertaTokenizer](/docs/transformers/v5.23.0/ko/model_doc/xlm-roberta#transformers.XLMRobertaTokenizer)를 [TrOCRProcessor](/docs/transformers/v5.23.0/ko/model_doc/trocr#transformers.TrOCRProcessor)의 단일 인스턴스로 묶어 이미지와 텍스트를 처리합니다.
- TrOCR은 항상 [VisionEncoderDecoder](vision-encoder-decoder) 프레임워크 내에서 사용됩니다.
## 리소스
- TrOCR를 활용한 [Accelerating Document AI](https://huggingface.co/blog/document-ai)에 대한 블로그 게시물입니다.
- TrOCR로 [Document AI](https://github.com/philschmid/document-ai-transformers)를 구현하는 방법에 대한 블로그 게시물입니다.
- [Seq2SeqTrainer를 사용하여 IAM Handwriting Database에서 TrOCR을 fine-tune하는 방법](https://colab.research.google.com/github/NielsRogge/Transformers-Tutorials/blob/master/TrOCR/Fine_tune_TrOCR_on_IAM_Handwriting_Database_using_Seq2SeqTrainer.ipynb)에 대한 노트북입니다.
- [TrOCR 손글씨 문자 인식](https://huggingface.co/spaces/nielsr/TrOCR-handwritten)에 대한 인터랙티브 데모입니다.
- [TrOCR를 이용한 추론](https://colab.research.google.com/github/NielsRogge/Transformers-Tutorials/blob/master/TrOCR/Inference_with_TrOCR_%2B_Gradio_demo.ipynb)에 대한 노트북과 Gradio 데모.
- [IAM 테스트 세트에서 TrOCR 평가](https://colab.research.google.com/github/NielsRogge/Transformers-Tutorials/blob/master/TrOCR/Evaluating_TrOCR_base_handwritten_on_the_IAM_test_set.ipynb)에 대한 노트북입니다.
## TrOCRConfig[[transformers.TrOCRConfig]]
#### transformers.TrOCRConfig[[transformers.TrOCRConfig]]
```python
transformers.TrOCRConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 50265, d_model: int = 1024, decoder_layers: int = 12, decoder_attention_heads: int = 16, decoder_ffn_dim: int = 4096, activation_function: str = 'gelu', max_position_embeddings: int = 512, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, decoder_start_token_id: int = 2, init_std: float = 0.02, decoder_layerdrop: float | int = 0.0, use_cache: bool = True, scale_embedding: bool = False, use_learned_position_embeddings: bool = True, layernorm_embedding: bool = True, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, cross_attention_hidden_size: int | None = None, is_decoder: bool = False, tie_word_embeddings: bool = True)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/trocr/configuration_trocr.py#L24)
**매개변수:**
vocab_size (`int`, *선택 사항*, 기본값 `50265`) : 모델의 어휘 크기입니다. `input_ids`로 표현할 수 있는 서로 다른 토큰의 수를 정의합니다.
d_model (`int`, *선택 사항*, 기본값 `1024`) : 인코더 레이어와 풀러 레이어의 크기.
decoder_layers (`int`, *선택 사항*, 기본값 `12`) : Transformer decoder의 숨겨진 레이어 수입니다. 설정하지 않으면 `num_layers`와 동일한 값을 사용합니다.
decoder_attention_heads (`int`, *선택 사항*, 기본값 `16`) : Transformer decoder의 각 attention layer에 사용할 attention head의 수입니다.
decoder_ffn_dim (`int`, *선택 사항*, 기본값 `4096`) : 디코더의 "중간"(일반적으로 feed-forward라고도 함) 레이어의 차원.
activation_function (`str`, *선택 사항*, 기본값 `gelu`) : 디코더에서 사용되는 비선형 활성화 함수(함수 또는 문자열). 예를 들어, `"gelu"`, `"relu"`, `"silu"` 등이 있습니다.
max_position_embeddings (`int`, *선택 사항*, 기본값 `512`) : 이 모델이 사용될 수 있는 최대 시퀀스 길이입니다.
dropout (`Union[float, int]`, *선택 사항*, 기본값 `0.1`) : 모든 dropout 레이어의 비율입니다.
attention_dropout (`Union[float, int]`, *선택 사항*, 기본값 `0.0`) : attention 확률에 적용할 dropout 비율입니다.
activation_dropout (`Union[float, int]`, *선택 사항*, 기본값 `0.0`) : 완전 연결 계층 내부 활성화에 적용되는 dropout 비율입니다.
decoder_start_token_id (`int`, *선택 사항*, 기본값 `2`) : 인코더-디코더 모델이 `bos`와 다른 토큰으로 디코딩을 시작하는 경우, 해당 토큰의 id입니다.
init_std (`float`, *선택 사항*, 기본값 `0.02`) : 모든 가중치 행렬을 초기화하는 truncated_normal_initializer의 표준 편차입니다.
decoder_layerdrop (`Union[float, int]`, *선택 사항*, 기본값 `0.0`) : 디코더의 LayerDrop 확률입니다. 자세한 내용은 [LayerDrop 논문](see https://huggingface.co/papers/1909.11556)을 참고하세요.
use_cache (`bool`, *선택 사항*, 기본값 `True`) : 모델이 마지막 key/values attention을 반환할지 여부입니다(모든 모델에서 사용되지 않음). `config.is_decoder=True`인 경우 또는 모델이 decoder-only 생성 모델인 경우에만 관련이 있습니다.
scale_embedding (`bool`, *선택 사항*, 기본값 `False`) : 임베딩을 sqrt(d_model)로 나누어 스케일링할지 여부.
use_learned_position_embeddings (`bool`, *선택 사항*, 기본값 `True`) : 학습된 위치 임베딩을 사용할지 여부입니다. 사용하지 않으면 사인oidal 위치 임베딩이 사용됩니다.
layernorm_embedding (`bool`, *선택 사항*, 기본값 `True`) : 단어 + 위치 임베딩 뒤에 layernorm을 사용할지 여부.
pad_token_id (`int`, *선택 사항*, 기본값 `1`) : 어휘에서 패딩에 사용되는 토큰 ID입니다.
bos_token_id (`int`, *선택 사항*, 기본값 `0`) : 어휘에서 스트림 시작에 사용되는 토큰 ID입니다.
eos_token_id (`Union[int, list[int]]`, *선택*, 기본값 `2`) : 어휘에서 스트림 종료에 사용되는 토큰 ID입니다.
cross_attention_hidden_size (`int`, *선택 사항*) : 인코더 출력을 디코더의 크로스 어텐션 키/값 공간으로 투영할 때의 숨겨진 크기. 인코더와 디코더의 숨겨진 크기가 다른 경우에 사용됩니다.
is_decoder (`bool`, *선택 사항*, 기본값 `False`) : 모델이 디코더로 사용되는지 여부를 나타냅니다. `False`인 경우 모델은 인코더로 사용됩니다.
tie_word_embeddings (`bool`, *선택 사항*, 기본값 `True`) : 모델의 `tied_weights_keys` 매핑에 따라 가중치 임베딩을 묶을지 여부.
이것은 TrocrModel의 구성을 저장하기 위한 구성 클래스입니다. 지정된 인자에 따라 Trocr 모델을 초기화하여 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 구성을 초기화하면 [microsoft/trocr-base-handwritten](https://huggingface.co/microsoft/trocr-base-handwritten)의 구성과 유사한 구성이 생성됩니다.
Configuration 객체는 [PreTrainedConfig](/docs/transformers/v5.23.0/ko/main_classes/configuration#transformers.PreTrainedConfig)를 상속하며, 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 [PreTrainedConfig](/docs/transformers/v5.23.0/ko/main_classes/configuration#transformers.PreTrainedConfig)의 문서를 참고하세요.
예:
```python
>>> from transformers import TrOCRConfig, TrOCRForCausalLM
>>> # Initializing a TrOCR-base style configuration
>>> configuration = TrOCRConfig()
>>> # Initializing a model (with random weights) from the TrOCR-base style configuration
>>> model = TrOCRForCausalLM(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## TrOCRProcessor[[transformers.TrOCRProcessor]]
#### transformers.TrOCRProcessor[[transformers.TrOCRProcessor]]
```python
transformers.TrOCRProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/trocr/processing_trocr.py#L27)
**매개변수:**
image_processor (`ViTImageProcessor`) : 이미지 프로세서가 필수 입력입니다.
tokenizer (`XLMRobertaTokenizer`) : 토크나이저는 필수 입력입니다.
이미지 프로세서와 토크나이저를 단일 프로세서로 감싸는 TrOCRProcessor를 생성합니다.
[TrOCRProcessor](/docs/transformers/v5.23.0/ko/model_doc/trocr#transformers.TrOCRProcessor)는 [ViTImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/vit#transformers.ViTImageProcessor)와 [XLMRobertaTokenizer](/docs/transformers/v5.23.0/ko/model_doc/xlm-roberta#transformers.XLMRobertaTokenizer)의 모든 기능을 제공합니다. 자세한 내용은 [~ViTImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/vit#transformers.ViTImageProcessor)와 [~XLMRobertaTokenizer](/docs/transformers/v5.23.0/ko/model_doc/xlm-roberta#transformers.XLMRobertaTokenizer)를 참고하세요.
#### __call__[[transformers.TrOCRProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/trocr/processing_trocr.py#L31)
**매개변수:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *선택*) : 전처리할 이미지. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 범위로 이루어진 이미지를 전달하는 경우 `do_rescale=False`로 설정하세요.
text (`Union[str, list[str], list[list[str]]]`, *선택*) : 인코딩할 시퀀스 또는 시퀀스 배치입니다. 각 시퀀스는 문자열 또는 문자열 목록(사전 토큰화된 문자열)일 수 있습니다. 사전 토큰화된 입력을 전달하는 경우, 배치 입력과의 혼동을 피하기 위해 `is_split_into_words=True`를 설정하세요.
return_mm_token_type_ids (`bool`, *kwargs*) : 멀티모달 플레이스홀더 토큰의 위치를 나타내는 멀티모달 토큰 타입 ID를 반환할지 여부.
return_text_replacement_offsets (`bool`, *kwargs*) : 각 멀티모달 플레이스홀더 및 그 대체 문자열의 문자 오프셋을 반환할지 여부.
return_tensors (`str` 또는 [TensorType](/docs/transformers/v5.23.0/ko/internal/file_utils#transformers.TensorType), *optional*) : 설정된 경우, 특정 프레임워크의 텐서를 반환합니다. 허용되는 값은 다음과 같습니다: - `'pt'`: PyTorch `torch.Tensor` 객체를 반환합니다. - `'np'`: NumPy `np.ndarray` 객체를 반환합니다.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/ko/main_classes/processors#transformers.ProcessingKwargs), *optional*) : 각 모달리티(텍스트, 이미지, 비디오, 오디오)에 대한 추가 처리 옵션입니다. 모델별 매개변수는 위에 나열되어 있으며, 지원되는 인수의 전체 목록은 TypedDict 클래스를 참조하세요.
**반환값:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ 메서드가 반환하는 리스트/배열/텐서 딕셔너리('pixel_values' 등).
- **tensor_type** (`Union[None, str, TensorType]`, *선택 사항*) -- 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type을 지정할 수 있습니다.
#### from_pretrained[[transformers.TrOCRProcessor.from_pretrained]]
```python
from_pretrained(pretrained_model_name_or_path: str | os.PathLike, cache_dir: str | os.PathLike | None = None, force_download: bool = False, local_files_only: bool = False, token: str | bool | None = None, revision: str = 'main', **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L1799)
**매개변수:**
pretrained_model_name_or_path (`str` 또는 `os.PathLike`) : 다음 중 하나일 수 있습니다. - huggingface.co의 모델 저장소에 호스팅된 사전 학습된 feature_extractor의 *model id*인 문자열. - [save_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) 메서드를 사용하여 저장된 feature extractor 파일이 포함된 *디렉터리*의 경로, 예: `./my_model_directory/`. - 저장된 feature extractor JSON *파일*의 경로, 예: `./my_model_directory/preprocessor_config.json`.
- ****kwargs** : [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained)와 `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained`에 함께 전달되는 추가 키워드 인자입니다.
과(와) 연관된 를 초기화합니다.
이 클래스 메서드는 단순히 feature extractor의 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained), image processor의 [ImageProcessingMixin](/docs/transformers/v5.23.0/ko/internal/image_processing_utils#transformers.ImageProcessingMixin) 및 tokenizer의 `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained` 메서드를 호출합니다. 자세한 내용은 위 메서드들의 docstring을 참고하세요.
#### save_pretrained[[transformers.TrOCRProcessor.save_pretrained]]
```python
save_pretrained(save_directory, push_to_hub: bool = False, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L1182)
**매개변수:**
save_directory (`str` 또는 `os.PathLike`) : feature extractor JSON 파일과 tokenizer 파일이 저장될 디렉터리 (존재하지 않으면 생성됩니다).
push_to_hub (`bool`, *선택 사항*, 기본값 `False`) : 모델을 저장한 후 Hugging Face 모델 허브에 푸시할지 여부입니다. `repo_id`를 사용하여 푸시할 저장소를 지정할 수 있으며, 지정하지 않으면 네임스페이스 내 `save_directory`의 이름이 기본값으로 사용됩니다.
kwargs (`dict[str, Any]`, *선택*) : [push_to_hub()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.utils.PushToHubMixin.push_to_hub) 메서드에 함께 전달되는 추가 키워드 인자입니다.
이 프로세서의 속성(피처 추출기, 토크나이저...)을 지정된 디렉터리에 저장하여 [from_pretrained()](/docs/transformers/v5.23.0/ko/model_doc/wav2vec2#transformers.Wav2Vec2Processor.from_pretrained) 메서드를 사용해 다시 로드할 수 있도록 합니다.
이 클래스 메서드는 단순히 [save_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained)와 [save_pretrained()](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.save_pretrained)를 호출합니다. 자세한 내용은 위 메서드의 docstring을 참고하세요.
#### batch_decode[[transformers.TrOCRProcessor.batch_decode]]
```python
batch_decode(*args, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L2054)
이 메서드는 모든 인수를 PreTrainedTokenizer의 [batch_decode()](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.batch_decode)로 전달합니다. 자세한 내용은 해당 메서드의 docstring을 참조하세요.
#### decode[[transformers.TrOCRProcessor.decode]]
```python
decode(*args, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L2063)
이 메서드는 모든 인수를 PreTrainedTokenizer의 [decode()](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.decode)로 전달합니다. 자세한 내용은 해당 메서드의 docstring을 참조하세요.
## TrOCRForCausalLM[[transformers.TrOCRForCausalLM]]
#### transformers.TrOCRForCausalLM[[transformers.TrOCRForCausalLM]]
```python
transformers.TrOCRForCausalLM(config: TrOCRConfig)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/trocr/modeling_trocr.py#L639)
**매개변수:**
config ([TrOCRConfig](/docs/transformers/v5.23.0/ko/model_doc/trocr#transformers.TrOCRConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
언어 모델링 헤드가 있는 TrOCR 디코더입니다. [EncoderDecoderModel](/docs/transformers/v5.23.0/ko/model_doc/encoder-decoder#transformers.EncoderDecoderModel)의 디코더 부분으로 사용할 수 있으며
이 모델은 [PreTrainedModel](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.TrOCRForCausalLM.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.LongTensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/trocr/modeling_trocr.py#L665)
**매개변수:**
input_ids (`torch.LongTensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 어휘(input sequence tokens)의 인덱스입니다. 기본적으로 패딩은 무시됩니다. [AutoTokenizer](/docs/transformers/v5.23.0/ko/model_doc/auto#transformers.AutoTokenizer)를 사용하여 인덱스를 얻을 수 있습니다. 자세한 내용은 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 및 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)를 참조하세요. [입력 ID란 무엇인가요?](../glossary#input-ids)
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
encoder_hidden_states (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`, *선택 사항*) : 인코더의 마지막 레이어 출력에서 생성된 hidden-states 시퀀스입니다. 모델이 디코더로 구성된 경우 cross-attention에 사용됩니다.
encoder_attention_mask (`torch.LongTensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 인코더 입력의 패딩 토큰 인덱스에 대한 어텐션을 수행하지 않도록 하는 마스크입니다. 모델이 디코더로 구성된 경우 크로스 어텐션에서 이 마스크가 사용됩니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0.
past_key_values (`~cache_utils.Cache`, *선택*) : 순차적 디코딩을 가속화할 수 있는 사전 계산된 hidden-states(셀프 어텐션 블록과 크로스 어텐션 블록의 key 및 value)입니다. 일반적으로 `use_cache=True` 또는 `config.use_cache=True`일 때 모델이 디코딩의 이전 단계에서 반환한 `past_key_values`로 구성됩니다. 입력으로 [Cache](/docs/transformers/v5.23.0/ko/internal/generation_utils#transformers.Cache) 인스턴스만 허용되며, [kv cache 가이드](https://huggingface.co/docs/transformers/en/kv_cache)를 참조하세요. `past_key_values`가 전달되지 않으면 기본적으로 [DynamicCache](/docs/transformers/v5.23.0/ko/internal/generation_utils#transformers.DynamicCache)가 초기화됩니다. 모델은 입력으로 제공된 것과 동일한 캐시 형식을 출력합니다. `past_key_values`를 사용하는 경우, 이 모델에 과거 key value 상태가 제공되지 않은 `input_ids`(처리되지 않은 항목)만 `(batch_size, unprocessed_length)` 형식으로 입력해야 하며, `(batch_size, sequence_length)` 형식의 모든 `input_ids`를 입력하지 않습니다.
inputs_embeds (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`, *선택 사항*) : `input_ids`를 전달하는 대신 임베디드 표현을 직접 전달할 수 있습니다. 이는 모델의 내부 임베딩 조회 행렬보다 `input_ids` 인덱스를 관련 벡터로 변환하는 방식에 대해 더 많은 제어가 필요한 경우 유용합니다.
labels (`torch.LongTensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 언어 모델링 손실을 계산하는 데 사용되는 라벨. 인덱스는 `[0, ..., config.vocab_size]` 범위 내이거나 -100이어야 합니다(`input_ids` docstring 참조). 인덱스가 `-100`으로 설정된 토큰은 무시(마스크)되며, 손실은 `[0, ..., config.vocab_size]` 범위의 라벨을 가진 토큰에 대해서만 계산됩니다. 모델 내부에서 라벨은 **시프트되지 않습니다**. `labels[..., i]`는 `logits[..., i, :]`의 타겟이므로, 다음 토큰 예측의 경우 라벨은 `input_ids`에 대해 이미 왼쪽으로 한 위치 시프트되어 있어야 합니다.
use_cache (`bool`, *선택 사항*) : `True`로 설정하면 `past_key_values` 키 값 상태가 반환되며, 디코딩 속도를 높이는 데 사용할 수 있습니다(`past_key_values` 참조).
output_attentions (`bool`, *선택 사항*) : 모든 어텐션 레이어의 어텐션 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의 `attentions`를 참조하세요.
output_hidden_states (`bool`, *선택 사항*) : 모든 레이어의 hidden states를 반환할지 여부. 자세한 내용은 반환되는 텐서 중 `hidden_states` 항목을 참조하세요.
return_dict (`bool`, *선택 사항*) : 일반 튜플 대신 [ModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.utils.ModelOutput)를 반환할지 여부.
**반환값:** [CausalLMOutputWithCrossAttentions](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) 또는 `tuple(torch.Tensor)`
구성([TrOCRConfig](/docs/transformers/v5.23.0/ko/model_doc/trocr#transformers.TrOCRConfig))과 입력에 따라 다양한 요소를 포함하는 [CausalLMOutputWithCrossAttentions](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우).
[TrOCRForCausalLM](/docs/transformers/v5.23.0/ko/model_doc/trocr#transformers.TrOCRForCausalLM)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **loss** (`torch.Tensor`, shape `(1,)`, *선택 사항*, `labels`가 제공될 때 반환됨) -- 언어 모델링 손실(다음 토큰 예측용).
- **logits** (`torch.Tensor`, shape `(batch_size, sequence_length, config.vocab_size)`) -- 언어 모델링 헤드에서 생성된 예측 점수(SoftMax 적용 전 각 어휘 토큰에 대한 점수).
- **hidden_states** (`tuple(torch.Tensor)`, *선택 사항*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력 1개 + 각 레이어의 출력 1개)로, 형태는 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple(torch.Tensor)`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
- **cross_attentions** (`tuple(torch.Tensor)`, *선택*, `output_attentions=True`가 전달되거나 `config.output_attentions=True`인 경우 반환) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, shape는 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
Attention softmax 이후의 cross attention 가중치로, cross-attention 헤드에서 가중 평균을 계산하는 데 사용됩니다.
- **past_key_values** (`Cache`, *선택 사항*, `use_cache=True`가 전달되었거나 `config.use_cache=True`인 경우 반환됨) -- [Cache](/docs/transformers/v5.23.0/ko/internal/generation_utils#transformers.Cache) 인스턴스입니다. 자세한 내용은 [kv cache 가이드](https://huggingface.co/docs/transformers/en/kv_cache)를 참조하세요.
순차적 디코딩을 가속화하는 데 사용할 수 있는 사전 계산된 hidden-states(attention 블록의 key와 value)를 포함합니다(입력 `past_key_values` 참조).
예:
```python
>>> from transformers import (
... TrOCRConfig,
... TrOCRProcessor,
... TrOCRForCausalLM,
... ViTConfig,
... ViTModel,
... VisionEncoderDecoderModel,
... )
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> # TrOCR is a decoder model and should be used within a VisionEncoderDecoderModel
>>> # init vision2text model with random weights
>>> encoder = ViTModel(ViTConfig())
>>> decoder = TrOCRForCausalLM(TrOCRConfig())
>>> model = VisionEncoderDecoderModel(encoder=encoder, decoder=decoder)
>>> # If you want to start from the pretrained model, load the checkpoint with `VisionEncoderDecoderModel`
>>> processor = TrOCRProcessor.from_pretrained("microsoft/trocr-base-handwritten")
>>> model = VisionEncoderDecoderModel.from_pretrained("microsoft/trocr-base-handwritten")
>>> # load image from the IAM dataset
>>> url = "https://fki.tic.heia-fr.ch/static/img/a01-122-02.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> pixel_values = processor(image, return_tensors="pt").pixel_values
>>> text = "industry, ' Mr. Brown commented icily. ' Let us have a"
>>> # training
>>> model.config.decoder_start_token_id = processor.tokenizer.eos_token_id
>>> model.config.pad_token_id = processor.tokenizer.pad_token_id
>>> model.config.vocab_size = model.config.decoder.vocab_size
>>> labels = processor.tokenizer(text, return_tensors="pt").input_ids
>>> outputs = model(pixel_values, labels=labels)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
5.30
>>> # inference
>>> generated_ids = model.generate(pixel_values)
>>> generated_text = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
>>> generated_text
'industry, " Mr. Brown commented icily. " Let us have a'
```