# X-CLIP
## Ikhtisar
Model X-CLIP diusulkan dalam [Expanding Language-Image Pretrained Models for General Video Recognition](https://huggingface.co/papers/2208.02816) oleh Bolin Ni, Houwen Peng, Minghao Chen, Songyang Zhang, Gaofeng Meng, Jianlong Fu, Shiming Xiang, Haibin Ling. X-CLIP adalah ekstensi minimal dari [CLIP](clip) untuk video. Model ini terdiri dari encoder teks, encoder visi lintas-frame, Transformer integrasi multi-frame, dan generator prompt khusus video.
Abstrak dari makalah tersebut adalah sebagai berikut:
*Prapelatihan bahasa-gambar kontrastif telah menunjukkan keberhasilan besar dalam mempelajari representasi gabungan visual-tekstual dari data berskala web, serta menunjukkan kemampuan generalisasi "zero-shot" yang luar biasa untuk berbagai tugas gambar. Namun, bagaimana cara memperluas metode prapelatihan bahasa-gambar baru ini secara efektif ke domain video masih menjadi masalah terbuka. Dalam karya ini, kami menyajikan pendekatan yang sederhana namun efektif untuk mengadaptasi model bahasa-gambar yang telah dilatih ke dalam pengenalan video secara langsung, alih-alih melatih model baru dari nol. Secara lebih konkret, untuk menangkap dependensi jarak jauh antar bingkai sepanjang dimensi temporal, kami mengusulkan mekanisme perhatian lintas-bingkai yang secara eksplisit bertukar informasi antar bingkai. Modul ini ringan dan dapat disisipkan ke dalam model bahasa-gambar yang telah dilatih secara mulus. Selain itu, kami mengusulkan skema prompting yang spesifik untuk video, yang memanfaatkan informasi konten video untuk menghasilkan prompt tekstual yang diskriminatif. Eksperimen ekstensif menunjukkan bahwa pendekatan kami efektif dan dapat digeneralisasi ke berbagai skenario pengenalan video. Secara khusus, dalam pengaturan yang sepenuhnya diawasi, pendekatan kami mencapai akurasi top-1 sebesar 87,1% pada Kinectics-400, sementara menggunakan 12 kali lebih sedikit FLOPs dibandingkan dengan Swin-L dan ViViT-H. Dalam eksperimen zero-shot, pendekatan kami melampaui metode state-of-the-art saat ini sebesar +7,6% dan +14,9% dalam hal akurasi top-1 di bawah dua protokol populer. Dalam skenario few-shot, pendekatan kami melampaui metode terbaik sebelumnya sebesar +32,1% dan +23,1% ketika data berlabel sangat terbatas.*
Tips:
- Penggunaan X-CLIP identik dengan [CLIP](clip).
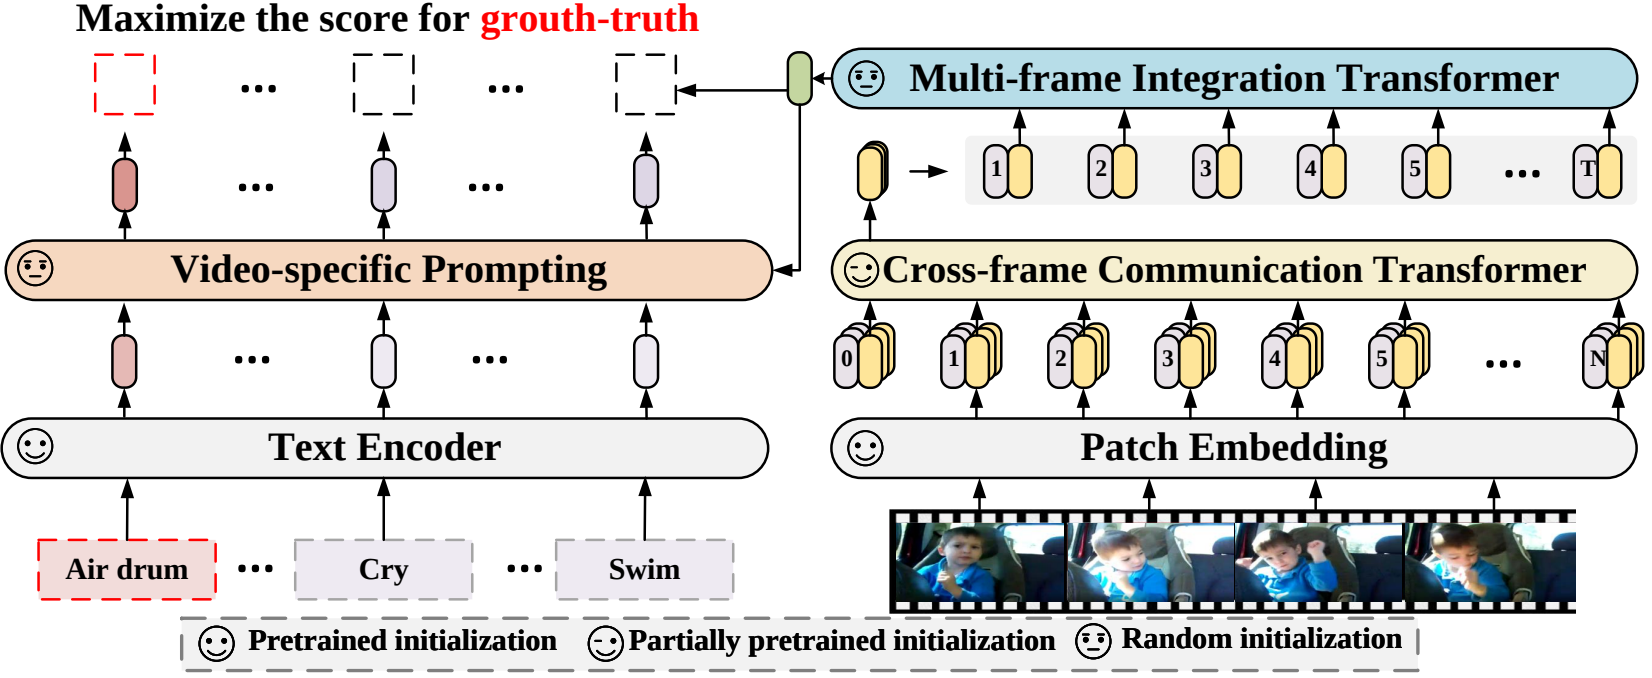 Arsitektur X-CLIP. Diambil dari paper aslinya.
Model ini disumbangkan oleh [nielsr](https://huggingface.co/nielsr). Kode aslinya dapat ditemukan [di sini](https://github.com/microsoft/VideoX/tree/master/X-CLIP).
## Sumber daya
Daftar sumber resmi Hugging Face dan komunitas (ditandai dengan 🌎) untuk membantu Anda memulai dengan X-CLIP.
- Notebook demo untuk X-CLIP dapat ditemukan [di sini](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/X-CLIP).
Jika Anda tertarik untuk mengirimkan sumber daya agar disertakan di sini, silakan buka Pull Request dan kami akan meninjaunya! Sumber daya tersebut sebaiknya mendemonstrasikan sesuatu yang baru, bukan menduplikasi sumber daya yang sudah ada.
## XCLIPProcessor[[transformers.XCLIPProcessor]]
#### transformers.XCLIPProcessor[[transformers.XCLIPProcessor]]
```python
transformers.XCLIPProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/processing_x_clip.py#L23)
**Parameter:**
image_processor (`image_processor_class`) : Pemroses gambar adalah input yang wajib.
tokenizer (`tokenizer_class`) : Tokenizer adalah input yang wajib.
Membangun XCLIPProcessor yang membungkus image processor dan tokenizer menjadi satu processor.
[XCLIPProcessor](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPProcessor) menyediakan semua fungsionalitas dari `image_processor_class` dan `tokenizer_class`. Lihat `~image_processor_class` dan `~tokenizer_class` untuk informasi lebih lanjut.
#### __call__[[transformers.XCLIPProcessor.__call__]]
```python
__call__(images = None, text = None, videos = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/processing_x_clip.py#L28)
## XCLIPConfig[[transformers.XCLIPConfig]]
#### transformers.XCLIPConfig[[transformers.XCLIPConfig]]
```python
transformers.XCLIPConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, projection_dim: int = 512, prompt_layers: int = 2, prompt_alpha: float = 0.1, prompt_hidden_act: str = 'quick_gelu', prompt_num_attention_heads: int = 8, prompt_attention_dropout: float | int = 0.0, prompt_projection_dropout: float | int = 0.0, logit_scale_init_value: float = 2.6592, initializer_factor: float = 1.0)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/configuration_x_clip.py#L119)
**Parameter:**
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opsional*) : Objek config atau dictionary dari text backbone.
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opsional*) : Objek config atau dictionary dari vision backbone.
projection_dim (`int`, *opsional*, defaultnya `512`) : Dimensi dari lapisan proyeksi teks dan visi.
prompt_layers (`int`, *opsional*, defaultnya 2) : Jumlah lapisan dalam generator prompt khusus video.
prompt_alpha (`float`, *opsional*, default 0.1) : Nilai alpha yang digunakan dalam generator prompt khusus video.
prompt_hidden_act (`str` atau `function`, *opsional*, defaultnya `"quick_gelu"`) : Fungsi aktivasi non-linear (fungsi atau string) dalam generator prompt spesifik video. Jika string, `"gelu"`, `"relu"`, `"selu"` dan `"gelu_new"` `"quick_gelu"` didukung.
prompt_num_attention_heads (`int`, *opsional*, defaultnya 8) : Jumlah kepala perhatian dalam cross-attention dari generator prompt spesifik video.
prompt_attention_dropout (`float`, *opsional*, default 0.0) : Probabilitas dropout untuk lapisan perhatian dalam generator prompt spesifik video.
prompt_projection_dropout (`float`, *opsional*, default 0.0) : Probabilitas dropout untuk lapisan proyeksi dalam generator prompt spesifik video.
logit_scale_init_value (`float`, *opsional*, defaultnya `2.6592`) : Nilai awal dari parameter *logit_scale*.
initializer_factor (`float`, *opsional*, default `1.0`) : Faktor untuk menginisialisasi semua matriks bobot (sebaiknya tetap 1, digunakan secara internal untuk pengujian inisialisasi).
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari X ClipModel. Kelas ini digunakan untuk membuat instans model X Clip sesuai dengan argumen yang ditentukan, sehingga mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
## XCLIPTextConfig[[transformers.XCLIPTextConfig]]
#### transformers.XCLIPTextConfig[[transformers.XCLIPTextConfig]]
```python
transformers.XCLIPTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 77, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/configuration_x_clip.py#L27)
**Parameter:**
vocab_size (`int`, *opsional*, defaultnya `49408`) : Ukuran kosakata model. Menentukan jumlah token berbeda yang dapat direpresentasikan oleh `input_ids`.
hidden_size (`int`, *opsional*, defaultnya `512`) : Dimensi dari representasi tersembunyi.
intermediate_size (`int`, *opsional*, defaultnya `2048`) : Dimensi dari representasi MLP.
num_hidden_layers (`int`, *opsional*, defaultnya `12`) : Jumlah lapisan tersembunyi dalam decoder Transformer.
num_attention_heads (`int`, *opsional*, defaultnya `8`) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer.
max_position_embeddings (`int`, *opsional*, defaultnya `77`) : Panjang maksimum urutan yang mungkin digunakan dengan model ini.
hidden_act (`str`, *opsional*, defaultnya `quick_gelu`) : Fungsi aktivasi non-linear (fungsi atau string) di decoder. Misalnya, `"gelu"`, `"relu"`, `"silu"`, dan sebagainya.
layer_norm_eps (`float`, *opsional*, defaultnya `1e-05`) : Epsilon yang digunakan oleh lapisan normalisasi lapisan.
attention_dropout (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Rasio dropout untuk probabilitas perhatian.
initializer_range (`float`, *opsional*, defaultnya `0.02`) : Deviasi standar dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot.
initializer_factor (`float`, *opsional*, default `1.0`) : Faktor untuk menginisialisasi semua matriks bobot (sebaiknya tetap 1, digunakan secara internal untuk pengujian inisialisasi).
pad_token_id (`int`, *opsional*, defaultnya `1`) : ID token yang digunakan untuk padding dalam kosakata.
bos_token_id (`int`, *opsional*, defaultnya `0`) : Token id yang digunakan untuk awal-stream dalam kosakata.
eos_token_id (`Union[int, list[int]]`, *opsional*, defaultnya `2`) : Token id yang digunakan untuk end-of-stream dalam kosakata.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari X ClipModel. Kelas ini digunakan untuk membuat instans model X Clip sesuai dengan argumen yang ditentukan, sehingga mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import XCLIPTextModel, XCLIPTextConfig
>>> # Initializing a XCLIPTextModel with microsoft/xclip-base-patch32 style configuration
>>> configuration = XCLIPTextConfig()
>>> # Initializing a XCLIPTextConfig from the microsoft/xclip-base-patch32 style configuration
>>> model = XCLIPTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## XCLIPVisionConfig[[transformers.XCLIPVisionConfig]]
#### transformers.XCLIPVisionConfig[[transformers.XCLIPVisionConfig]]
```python
transformers.XCLIPVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, mit_hidden_size: int = 512, mit_intermediate_size: int = 2048, mit_num_hidden_layers: int = 1, mit_num_attention_heads: int = 8, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 32, num_frames: int = 8, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, drop_path_rate: float | int = 0.0)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/configuration_x_clip.py#L65)
**Parameter:**
hidden_size (`int`, *opsional*, defaultnya `768`) : Dimensi dari representasi tersembunyi.
intermediate_size (`int`, *opsional*, defaultnya `3072`) : Dimensi dari representasi MLP.
num_hidden_layers (`int`, *opsional*, defaultnya `12`) : Jumlah lapisan tersembunyi dalam decoder Transformer.
num_attention_heads (`int`, *opsional*, defaultnya `12`) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer.
mit_hidden_size (`int`, *opsional*, default 512) : Dimensi dari lapisan encoder pada Multiframe Integration Transformer (MIT).
mit_intermediate_size (`int`, *opsional*, default 2048) : Dimensi dari lapisan "intermediate" (yaitu, feed-forward) dalam Multiframe Integration Transformer (MIT).
mit_num_hidden_layers (`int`, *opsional*, default 1) : Jumlah lapisan tersembunyi dalam Multiframe Integration Transformer (MIT).
mit_num_attention_heads (`int`, *opsional*, default 8) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam Multiframe Integration Transformer (MIT).
num_channels (`int`, *opsional*, default `3`) : Jumlah saluran input.
image_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `224`) : Ukuran (resolusi) dari setiap gambar.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `32`) : Ukuran (resolusi) dari setiap patch.
num_frames (`int`, *opsional*, defaultnya 8) : Jumlah frame dalam setiap video.
hidden_act (`str`, *opsional*, defaultnya `quick_gelu`) : Fungsi aktivasi non-linear (fungsi atau string) di decoder. Misalnya, `"gelu"`, `"relu"`, `"silu"`, dan sebagainya.
layer_norm_eps (`float`, *opsional*, defaultnya `1e-05`) : Epsilon yang digunakan oleh lapisan normalisasi lapisan.
attention_dropout (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Rasio dropout untuk probabilitas perhatian.
initializer_range (`float`, *opsional*, defaultnya `0.02`) : Deviasi standar dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot.
initializer_factor (`float`, *opsional*, default `1.0`) : Faktor untuk menginisialisasi semua matriks bobot (sebaiknya tetap 1, digunakan secara internal untuk pengujian inisialisasi).
drop_path_rate (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Tingkat drop path untuk fusi patch.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari X ClipModel. Kelas ini digunakan untuk membuat instans model X Clip sesuai dengan argumen yang ditentukan, sehingga mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [microsoft/xclip-base-patch32](https://huggingface.co/microsoft/xclip-base-patch32)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import XCLIPVisionModel, XCLIPVisionConfig
>>> # Initializing a XCLIPVisionModel with microsoft/xclip-base-patch32 style configuration
>>> configuration = XCLIPVisionConfig()
>>> # Initializing a XCLIPVisionModel model from the microsoft/xclip-base-patch32 style configuration
>>> model = XCLIPVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## XCLIPModel[[transformers.XCLIPModel]]
#### transformers.XCLIPModel[[transformers.XCLIPModel]]
```python
transformers.XCLIPModel(config: XCLIPConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L914)
**Parameter:**
config ([XCLIPConfig](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model X Clip polos yang menghasilkan hidden-states mentah tanpa head spesifik di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.XCLIPModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L981)
**Parameter:**
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/v5.23.0/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan `image_processor_class`. Lihat `image_processor_class.__call__` untuk detailnya (`processor_class` menggunakan `image_processor_class` untuk memproses gambar).
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
position_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks posisi token dari setiap urutan input dalam embedding posisi. Dipilih dalam rentang `[0, config.n_positions - 1]`. [Apa itu position ID?](../glossary#position-ids)
return_loss (`bool`, *opsional*) : Apakah akan mengembalikan kerugian kontras (contrastive loss) atau tidak.
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** `XCLIPOutput` atau `tuple(torch.Tensor)`
`XCLIPOutput` atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([XCLIPConfig](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPConfig)) dan input.
Metode forward dari [XCLIPModel](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan ketika `return_loss` bernilai `True`) -- Contrastive loss untuk kemiripan video-teks.
- **logits_per_text** (`torch.Tensor` dengan bentuk `(text_batch_size, video_batch_size)`) -- Skor hasil perkalian titik berskala antara `text_embeds` dan `video_embeds`. Ini mewakili skor kemiripan teks-video.
- **text_embeds** (`torch.Tensor` dengan bentuk `(batch_size, output_dim`) -- Embedding teks yang diperoleh dengan menerapkan lapisan proyeksi ke output pooled dari [XCLIPTextModel](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPTextModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opsional*) -- Output dari [XCLIPTextModel](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opsional*) -- Output dari [XCLIPVisionModel](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPVisionModel).
- **logits_per_video** (`torch.Tensor` dengan bentuk `(video_batch_size, text_batch_size)`) -- Skor hasil perkalian titik (dot product) yang telah diskalakan antara `video_embeds` dan `text_embeds`. Ini mewakili skor kemiripan video-teks.
- **video_embeds** (`torch.Tensor` dengan bentuk `(batch_size, output_dim`) -- Embedding video yang diperoleh dengan menerapkan lapisan proyeksi ke output terpool dari [XCLIPVisionModel](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPVisionModel).
- **mit_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *opsional*) -- Output dari `XCLIPMultiframeIntegrationTransformer` (disingkat MIT).
Contoh:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, AutoModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 8 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = processor(
... text=["playing sports", "eating spaghetti", "go shopping"],
... videos=list(video),
... return_tensors="pt",
... padding=True,
... )
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> logits_per_video = outputs.logits_per_video # this is the video-text similarity score
>>> probs = logits_per_video.softmax(dim=1) # we can take the softmax to get the label probabilities
>>> print(probs)
tensor([[1.9496e-04, 9.9960e-01, 2.0825e-04]])
```
#### get_text_features[[transformers.XCLIPModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L946)
**Parameter:**
input_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/v5.23.0/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
position_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks posisi token dari setiap urutan input dalam embedding posisi. Dipilih dalam rentang `[0, config.n_positions - 1]`. [Apa itu position ID?](../glossary#position-ids)
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
Sebuah [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([XCLIPConfig](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPConfig)) dan input.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> import torch
>>> from transformers import AutoTokenizer, AutoModel
>>> tokenizer = AutoTokenizer.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_video_features[[transformers.XCLIPModel.get_video_features]]
```python
get_video_features(pixel_values: Tensor, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L1141)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan `image_processor_class`. Lihat `image_processor_class.__call__` untuk detailnya (`processor_class` menggunakan `image_processor_class` untuk memproses gambar).
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
Sebuah [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([XCLIPConfig](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPConfig)) dan input.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, AutoModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 8 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = AutoModel.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = processor(videos=list(video), return_tensors="pt")
>>> video_features = model.get_video_features(**inputs)
```
## XCLIPTextModel[[transformers.XCLIPTextModel]]
#### transformers.XCLIPTextModel[[transformers.XCLIPTextModel]]
```python
transformers.XCLIPTextModel(config: XCLIPTextConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L549)
**Parameter:**
config ([XCLIPTextConfig](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPTextConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model teks dari XCLIP tanpa head atau proyeksi di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.XCLIPTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L563)
**Parameter:**
input_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/v5.23.0/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
position_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks posisi token dari setiap urutan input dalam embedding posisi. Dipilih dalam rentang `[0, config.n_positions - 1]`. [Apa itu position ID?](../glossary#position-ids)
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
Sebuah [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([XCLIPConfig](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPConfig)) dan input.
Metode forward dari [XCLIPTextModel](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPTextModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import AutoTokenizer, XCLIPTextModel
>>> model = XCLIPTextModel.from_pretrained("microsoft/xclip-base-patch32")
>>> tokenizer = AutoTokenizer.from_pretrained("microsoft/xclip-base-patch32")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## XCLIPVisionModel[[transformers.XCLIPVisionModel]]
#### transformers.XCLIPVisionModel[[transformers.XCLIPVisionModel]]
```python
transformers.XCLIPVisionModel(config: XCLIPVisionConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L647)
**Parameter:**
config ([XCLIPVisionConfig](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPVisionConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model visual dari XCLIP tanpa head atau proyeksi di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.XCLIPVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor], interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/x_clip/modeling_x_clip.py#L663)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan `image_processor_class`. Lihat `image_processor_class.__call__` untuk detailnya (`processor_class` menggunakan `image_processor_class` untuk memproses gambar).
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
Sebuah [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([XCLIPConfig](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPConfig)) dan input.
Metode forward dari [XCLIPVisionModel](/docs/transformers/v5.23.0/id/model_doc/xclip#transformers.XCLIPVisionModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> import av
>>> import torch
>>> import numpy as np
>>> from transformers import AutoProcessor, XCLIPVisionModel
>>> from huggingface_hub import hf_hub_download
>>> np.random.seed(0)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # video clip consists of 300 frames (10 seconds at 30 FPS)
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample 16 frames
>>> indices = sample_frame_indices(clip_len=8, frame_sample_rate=1, seg_len=container.streams.video[0].frames)
>>> video = read_video_pyav(container, indices)
>>> processor = AutoProcessor.from_pretrained("microsoft/xclip-base-patch32")
>>> model = XCLIPVisionModel.from_pretrained("microsoft/xclip-base-patch32")
>>> pixel_values = processor(videos=list(video), return_tensors="pt").pixel_values
>>> batch_size, num_frames, num_channels, height, width = pixel_values.shape
>>> pixel_values = pixel_values.reshape(-1, num_channels, height, width)
>>> outputs = model(pixel_values)
>>> last_hidden_state = outputs.last_hidden_state
```