# SAM
## Resumen
SAM (Segment Anything Model) fue propuesto en [Segment Anything](https://huggingface.co/papers/2304.02643) por Alexander Kirillov, Eric Mintun, Nikhila Ravi, Hanzi Mao, Chloe Rolland, Laura Gustafson, Tete Xiao, Spencer Whitehead, Alex Berg, Wan-Yen Lo, Piotr Dollar, Ross Girshick.
El modelo se puede utilizar para predecir máscaras de segmentación de cualquier objeto de interés a partir de una imagen de entrada.
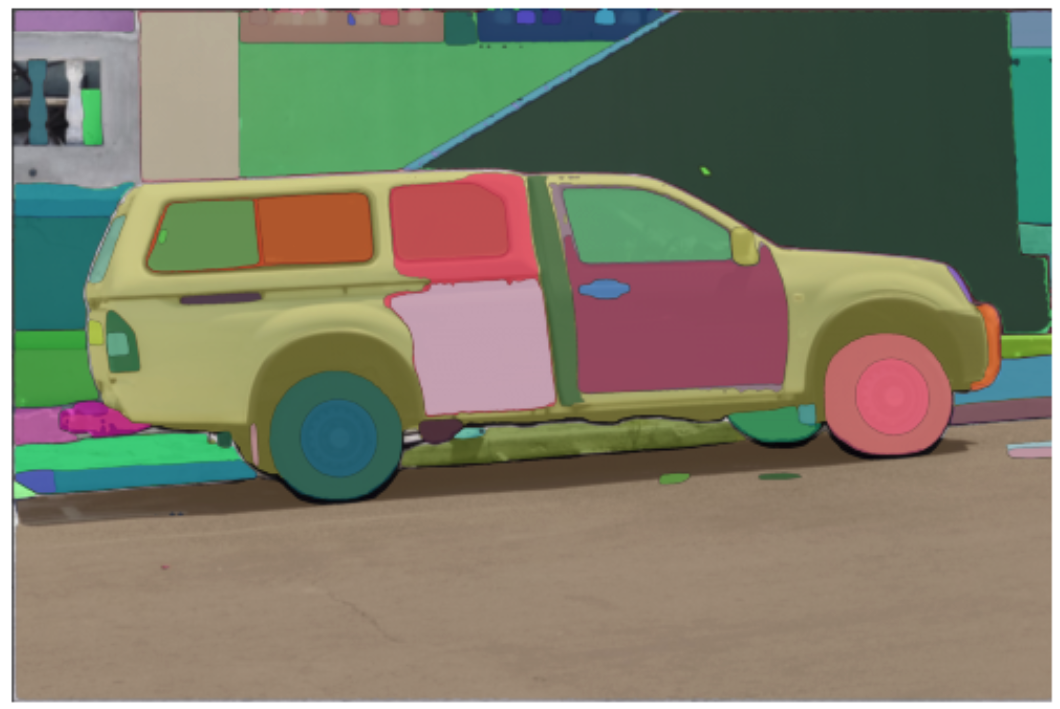
El resumen del artículo es el siguiente:
*Presentamos el proyecto Segment Anything (SA): una nueva tarea, un modelo y un conjunto de datos para la segmentación de imágenes. Utilizando nuestro modelo eficiente en un bucle de recopilación de datos, construimos el mayor conjunto de datos de segmentación hasta la fecha (con diferencia), con más de 1.000 millones de máscaras en 11 millones de imágenes con licencia y que respetan la privacidad. El modelo está diseñado y entrenado para ser activable mediante indicaciones (prompts), lo que le permite transferirse de forma zero-shot a nuevas distribuciones de imágenes y tareas. Evaluamos sus capacidades en numerosas tareas y descubrimos que su rendimiento zero-shot es impresionante: a menudo es competitivo o incluso superior a los resultados totalmente supervisados anteriores. Publicamos el Segment Anything Model (SAM) y el conjunto de datos correspondiente (SA-1B) de 1.000 millones de máscaras y 11 millones de imágenes en [https://segment-anything.com](https://segment-anything.com) para fomentar la investigación en modelos de base para la visión por computadora.*
Consejos:
- El modelo predice máscaras binarias que indican la presencia o ausencia del objeto de interés a partir de una imagen.
- El modelo predice resultados mucho mejores si se proporcionan puntos 2D de entrada y/o cajas delimitadoras de entrada
- Puedes indicar varios puntos para la misma imagen y predecir una sola máscara.
- El ajuste fino del modelo aún no está admitido
- Según el artículo, también debería admitirse la entrada de texto. Sin embargo, a la fecha de redacción de este texto, parece que no se admite, según [el repositorio oficial](https://github.com/facebookresearch/segment-anything/issues/4#issuecomment-1497626844).
Este modelo fue aportado por [ybelkada](https://huggingface.co/ybelkada) y [ArthurZ](https://huggingface.co/ArthurZ). El código original se puede encontrar [aquí](https://github.com/facebookresearch/segment-anything).
A continuación se muestra un ejemplo de cómo ejecutar la generación de máscaras a partir de una imagen y un punto 2D:
```python
import requests
import torch
from PIL import Image
from transformers import SamModel, SamProcessor
model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")
img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
input_points = [[[450, 600]]] # 2D location of a window in the image
inputs = processor(raw_image, input_points=input_points, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(
outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
```
También puedes procesar tus propias máscaras junto con las imágenes de entrada en el procesador para pasarlas al modelo.
```python
import requests
import torch
from PIL import Image
from transformers import SamModel, SamProcessor
model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")
img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
mask_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
segmentation_map = Image.open(requests.get(mask_url, stream=True).raw).convert("1")
input_points = [[[450, 600]]] # 2D location of a window in the image
inputs = processor(raw_image, input_points=input_points, segmentation_maps=segmentation_map, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(
outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
```
## Recursos
Una lista de recursos oficiales de Hugging Face y de la comunidad (indicados por 🌎) para ayudarte a empezar con SAM.
- [Cuaderno de demostración](https://github.com/huggingface/notebooks/blob/main/examples/segment_anything.ipynb) para usar el modelo.
- [Cuaderno de demostración](https://github.com/huggingface/notebooks/blob/main/examples/automatic_mask_generation.ipynb) para usar el pipeline de generación automática de máscaras.
- [Cuaderno de demostración](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/SAM/Run_inference_with_MedSAM_using_HuggingFace_Transformers.ipynb) para inferencia con MedSAM, una versión ajustada de SAM para el dominio médico. 🌎
- [Cuaderno de demostración](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/SAM/Fine_tune_SAM_(segment_anything)_on_a_custom_dataset.ipynb) para el ajuste fino del modelo con datos personalizados. 🌎
## SlimSAM
SlimSAM, una versión podada de SAM, fue propuesta en [0.1% Data Makes Segment Anything Slim](https://huggingface.co/papers/2312.05284) por Zigeng Chen et al. SlimSAM reduce considerablemente el tamaño de los modelos de SAM manteniendo el mismo rendimiento.
Los puntos de control se pueden encontrar en el [hub](https://huggingface.co/models?other=slimsam) y se pueden usar como un reemplazo directo de SAM.
## Grounded SAM
Se puede combinar [Grounding DINO](grounding-dino) con SAM para la generación de máscaras basadas en texto, tal como se introduce en [Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks](https://huggingface.co/papers/2401.14159). Puede consultar este [cuaderno de demostración](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/Grounding%20DINO/GroundingDINO_with_Segment_Anything.ipynb) 🌍 para más detalles.
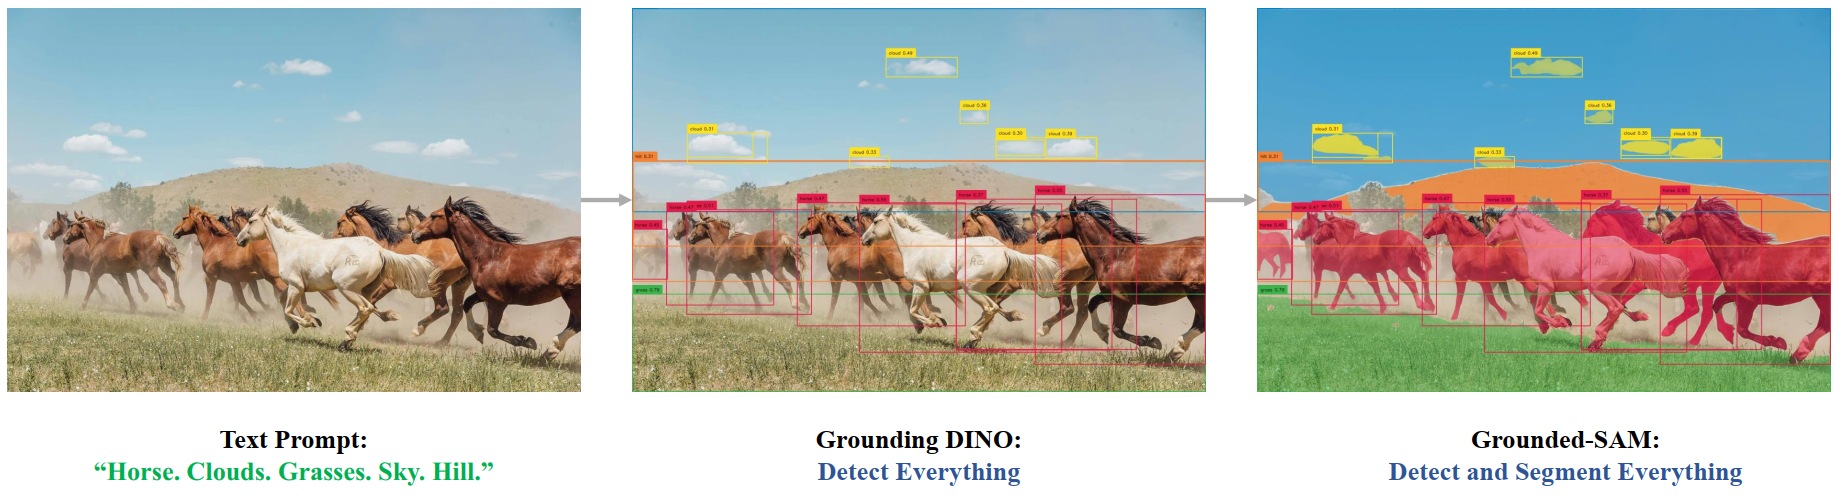 Resumen de Grounded SAM. Tomado del repositorio original.
## SamConfig[[transformers.SamConfig]]
#### transformers.SamConfig[[transformers.SamConfig]]
```python
transformers.SamConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, prompt_encoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, mask_decoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, initializer_range: float = 0.02, tie_word_embeddings: bool = True)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/configuration_sam.py#L146)
**Parámetros:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : El objeto de configuración o el diccionario del backbone de visión.
prompt_encoder_config (Union[`dict`, `SamPromptEncoderConfig`], *opcional*) : Diccionario de opciones de configuración utilizado para inicializar [SamPromptEncoderConfig](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamPromptEncoderConfig).
mask_decoder_config (Union[`dict`, `SamMaskDecoderConfig`], *opcional*) : Diccionario de opciones de configuración utilizadas para inicializar [SamMaskDecoderConfig](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamMaskDecoderConfig).
initializer_range (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
tie_word_embeddings (`bool`, *opcional*, valor predeterminado `True`) : Indica si se deben vincular las incrustaciones de pesos según el mapeo `tied_weights_keys` del modelo.
Esta es la clase de configuración para almacenar la configuración de un SamModel. Se utiliza para instanciar un modelo Sam según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import (
... SamVisionConfig,
... SamPromptEncoderConfig,
... SamMaskDecoderConfig,
... SamModel,
... )
>>> # Initializing a SamConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamConfig()
>>> # Initializing a SamModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a SamConfig from a SamVisionConfig, SamPromptEncoderConfig, and SamMaskDecoderConfig
>>> # Initializing SAM vision, SAM Q-Former and language model configurations
>>> vision_config = SamVisionConfig()
>>> prompt_encoder_config = SamPromptEncoderConfig()
>>> mask_decoder_config = SamMaskDecoderConfig()
>>> config = SamConfig(vision_config, prompt_encoder_config, mask_decoder_config)
```
## SamVisionConfig[[transformers.SamVisionConfig]]
#### transformers.SamVisionConfig[[transformers.SamVisionConfig]]
```python
transformers.SamVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, output_channels: int = 256, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 1024, patch_size: int | list[int] | tuple[int, int] = 16, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True, mlp_ratio: float = 4.0, use_abs_pos: bool = True, use_rel_pos: bool = True, window_size: int = 14, global_attn_indexes: list[int] | tuple[int, ...] = (2, 5, 8, 11), num_pos_feats: int = 128, mlp_dim: int | None = None)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/configuration_sam.py#L81)
**Parámetros:**
hidden_size (`int`, *opcional*, valor predeterminado `768`) : Dimensión de las representaciones ocultas.
output_channels (`int`, *opcional*, valor predeterminado 256) : Dimensionalidad de los canales de salida en el Patch Encoder.
num_hidden_layers (`int`, *opcional*, valor predeterminado `12`) : Número de capas ocultas en el decodificador del Transformer.
num_attention_heads (`int`, *opcional*, valor predeterminado `12`) : Número de cabezas de atención para cada capa de atención en el decodificador Transformer.
num_channels (`int`, *opcional*, valor predeterminado `3`) : El número de canales de entrada.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `1024`) : El tamaño (resolución) de cada imagen.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `16`) : El tamaño (resolución) de cada parche.
hidden_act (`str`, *opcional*, valor predeterminado `gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-06`) : El epsilon utilizado por las capas de normalización de capas.
attention_dropout (`Union[float, int]`, *opcional*, valor predeterminado `0.0`) : La proporción de dropout para las probabilidades de atención.
initializer_range (`float`, *opcional*, valor predeterminado `1e-10`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
qkv_bias (`bool`, *opcional*, valor predeterminado `True`) : Indica si se debe añadir un sesgo a las consultas, claves y valores.
mlp_ratio (`float`, *opcional*, valor predeterminado `4.0`) : Proporción entre la dimensión oculta del MLP y la dimensión de incrustación.
use_abs_pos (`bool`, *opcional*, valor predeterminado `True`) : Si se deben usar incrustaciones de posición absoluta.
use_rel_pos (`bool`, *opcional*, valor predeterminado `True`) : Si se debe usar la incrustación de posición relativa.
window_size (`int`, *opcional*, valor predeterminado 14) : Tamaño de la ventana para la posición relativa.
global_attn_indexes (`list[int]`, *opcional*, valor predeterminado `[2, 5, 8, 11]`) : Los índices de las capas de atención global.
num_pos_feats (`int`, *opcional*, valor predeterminado 128) : La dimensionalidad del embedding de posición.
mlp_dim (`int`, *opcional*) : La dimensionalidad de la capa MLP en el codificador Transformer. Si es `None`, el valor predeterminado es `mlp_ratio * hidden_size`.
Esta es la clase de configuración para almacenar la configuración de un SamModel. Se utiliza para instanciar un modelo Sam según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import (
... SamVisionConfig,
... SamVisionModel,
... )
>>> # Initializing a SamVisionConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamVisionConfig()
>>> # Initializing a SamVisionModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## SamMaskDecoderConfig[[transformers.SamMaskDecoderConfig]]
#### transformers.SamMaskDecoderConfig[[transformers.SamMaskDecoderConfig]]
```python
transformers.SamMaskDecoderConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 256, hidden_act: str = 'relu', mlp_dim: int = 2048, num_hidden_layers: int = 2, num_attention_heads: int = 8, attention_downsample_rate: int = 2, num_multimask_outputs: int = 3, iou_head_depth: int = 3, iou_head_hidden_dim: int = 256, layer_norm_eps: float = 1e-06)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/configuration_sam.py#L50)
**Parámetros:**
hidden_size (`int`, *opcional*, valor predeterminado `256`) : Dimensión de las representaciones ocultas.
hidden_act (`str`, *opcional*, valor predeterminado `relu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
mlp_dim (`int`, *opcional*, valor predeterminado 2048) : Dimensionalidad de la capa "intermedia" (es decir, de retroalimentación) en el codificador Transformer.
num_hidden_layers (`int`, *opcional*, valor predeterminado `2`) : Número de capas ocultas en el decodificador del Transformer.
num_attention_heads (`int`, *opcional*, valor predeterminado `8`) : Número de cabezas de atención para cada capa de atención en el decodificador del Transformer.
attention_downsample_rate (`int`, *opcional*, valor predeterminado 2) : La tasa de submuestreo de la capa de atención.
num_multimask_outputs (`int`, *opcional*, valor predeterminado 3) : El número de salidas del módulo `SamMaskDecoder`. En el paper de Segment Anything, este valor se establece en 3.
iou_head_depth (`int`, *opcional*, valor predeterminado 3) : El número de capas en el módulo de la cabeza IoU.
iou_head_hidden_dim (`int`, *opcional*, valor predeterminado 256) : La dimensionalidad de los estados ocultos en el módulo de la cabeza IoU.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-06`) : El epsilon utilizado por las capas de normalización de capas.
Esta es la clase de configuración para almacenar la configuración de un SamModel. Se utiliza para instanciar un modelo Sam según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
## SamPromptEncoderConfig[[transformers.SamPromptEncoderConfig]]
#### transformers.SamPromptEncoderConfig[[transformers.SamPromptEncoderConfig]]
```python
transformers.SamPromptEncoderConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 256, image_size: int | list[int] | tuple[int, int] = 1024, patch_size: int | list[int] | tuple[int, int] = 16, mask_input_channels: int = 16, num_point_embeddings: int = 4, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/configuration_sam.py#L24)
**Parámetros:**
hidden_size (`int`, *opcional*, valor predeterminado `256`) : Dimensión de las representaciones ocultas.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `1024`) : El tamaño (resolución) de cada imagen.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `16`) : El tamaño (resolución) de cada parche.
mask_input_channels (`int`, *opcional*, valor predeterminado 16) : El número de canales que se enviarán al módulo `MaskDecoder`.
num_point_embeddings (`int`, *opcional*, valor predeterminado: 4) : El número de embeddings de puntos que se utilizarán.
hidden_act (`str`, *opcional*, valor predeterminado `gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-06`) : El epsilon utilizado por las capas de normalización de capas.
Esta es la clase de configuración para almacenar la configuración de un SamModel. Se utiliza para instanciar un modelo Sam según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
## SamProcessor[[transformers.SamProcessor]]
#### transformers.SamProcessor[[transformers.SamProcessor]]
```python
transformers.SamProcessor(image_processor)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/processing_sam.py#L93)
**Parámetros:**
image_processor (`SamImageProcessor`) : El procesador de imágenes es un parámetro de entrada obligatorio.
Construye un SamProcessor que envuelve un procesador de imágenes en un único procesador.
[SamProcessor](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamProcessor) ofrece todas las funcionalidades de [SamImageProcessor](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamImageProcessor). Consulte [~SamImageProcessor](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamImageProcessor) para obtener más información.
#### __llamada__[[transformers.SamProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, input_points: NestedList | torch.Tensor | None = None, input_labels: NestedList | int | torch.Tensor | None = None, input_boxes: NestedList | torch.Tensor | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/processing_sam.py#L102)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opcional*) : Imagen para preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opcional*) : La secuencia o el lote de secuencias que se van a codificar. Cada secuencia puede ser una cadena de caracteres o una lista de cadenas (cadena pretokenizada). Si se pasa una entrada pretokenizada, establezca `is_split_into_words=True` para evitar ambigüedad con las entradas en lote.
segmentation_maps (`ImageInput`, *opcional*) : Mapas de segmentación de referencia para procesar junto con las imágenes de entrada. Estos mapas se utilizan con fines de entrenamiento o evaluación y se redimensionan y normalizan para que coincidan con las dimensiones de la imagen procesada.
input_points (`NestedList`, *opcional*) : Puntos de entrada para segmentación basada en prompts. Debe ser una lista anidada con la estructura `[image_level, object_level, point_level, [x, y]]` donde cada punto se especifica como coordenadas `[x, y]` en el espacio de la imagen original. Los puntos se normalizan al tamaño de la imagen objetivo antes de ser pasados al modelo.
input_labels (`NestedList`, *opcional*) : Etiquetas para los puntos de entrada, que indican si cada punto es de primer plano (1) o de fondo (0). Debe ser una lista anidada con la estructura `[image_level, object_level, point_level]`. Debe tener la misma estructura que `input_points` (excluyendo la dimensión de coordenadas).
input_boxes (`NestedList`, *opcional*) : Cajas delimitadoras para segmentación basada en prompts. Debe ser una lista anidada con la estructura `[image_level, box_level, [x1, y1, x2, y2]]` donde cada caja se especifica como coordenadas `[x1, y1, x2, y2]` en el espacio de la imagen original. Las cajas se normalizan al tamaño de la imagen objetivo antes de ser pasadas al modelo.
segmentation_maps (`ImageInput`, *kwargs*, *opcional*) : Obsoleto, pásalo directamente como `segmentation_maps` a [SamProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamProcessor.__call__) en su lugar. Mapas de segmentación de referencia para procesar junto con las imágenes de entrada. Estos mapas se utilizan con fines de entrenamiento o evaluación y se redimensionan y normalizan para que coincidan con las dimensiones de la imagen procesada.
input_points (`NestedList`, *kwargs*, *opcional*) : Obsoleto, pásalo directamente como `input_points` a [SamProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamProcessor.__call__) en su lugar. Puntos de entrada para la segmentación basada en prompts. Debe ser una lista anidada con la estructura `[image_level, object_level, point_level, [x, y]]` donde cada punto se especifica como coordenadas `[x, y]` en el espacio de la imagen original. Los puntos se normalizan al tamaño de la imagen objetivo antes de pasarse al modelo.
input_labels (`NestedList`, *kwargs*, *opcional*) : Obsoleto, pásalo directamente como `input_labels` a [SamProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamProcessor.__call__) en su lugar. Etiquetas para los puntos de entrada, que indican si cada punto es de primer plano (1) o de fondo (0). Debe ser una lista anidada con la estructura `[image_level, object_level, point_level]`. Debe tener la misma estructura que `input_points` (excluyendo la dimensión de coordenadas).
input_boxes (`NestedList`, *kwargs*, *opcional*) : Obsoleto, pásalo directamente como `input_boxes` a [SamProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamProcessor.__call__) en su lugar. Cajas delimitadoras para la segmentación basada en prompts. Debe ser una lista anidada con la estructura `[image_level, box_level, [x1, y1, x2, y2]]` donde cada caja se especifica como coordenadas `[x1, y1, x2, y2]` en el espacio de la imagen original. Las cajas se normalizan al tamaño de la imagen objetivo antes de pasarse al modelo.
point_pad_value (`int`, *kwargs*, *opcional*) : Obsoleto, use `SamProcessorKwargs.point_pad_value` en su lugar. El valor utilizado para rellenar los puntos de entrada al agrupar secuencias de diferentes longitudes. Este valor marca las posiciones rellenas y se conserva durante la normalización de coordenadas para distinguir los puntos reales del relleno.
mask_size (`dict[str, *kwargs*, int]`, *opcional*) : Diccionario que especifica el tamaño de la máscara objetivo con las claves `"height"` y `"width"`. Esto determina la resolución de las máscaras de segmentación de salida generadas por el modelo.
mask_pad_size (`dict[str, *kwargs*, int]`, *opcional*) : Diccionario que especifica el tamaño de relleno para las máscaras, con las claves `"height"` y `"width"`. Se utiliza al agrupar máscaras de diferentes tamaños para garantizar dimensiones consistentes.
return_mm_token_type_ids (`bool`, *kwargs*) : Si se deben devolver los ids de tipo de token multimodal que indican las posiciones de los tokens de marcador multimodal.
return_text_replacement_offsets (`bool`, *kwargs*) : Si se deben devolver los desplazamientos de caracteres para cada marcador de posición multimodal y su reemplazo.
point_pad_value (`int`, *kwargs*, *opcional*, por defecto `-10`) : El valor utilizado para rellenar los puntos de entrada al agrupar secuencias de diferentes longitudes. Este valor marca las posiciones rellenas y se conserva durante la normalización de coordenadas para distinguir los puntos reales del relleno.
return_tensors (`str` o [TensorType](/docs/transformers/v5.23.0/es/internal/file_utils#transformers.TensorType), *opcional*) : Si se establece, devolverá tensores de un marco de trabajo específico. Los valores aceptables son: - `'pt'`: Devuelve objetos `torch.Tensor` de PyTorch. - `'np'`: Devuelve objetos `np.ndarray` de NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/es/main_classes/processors#transformers.ProcessingKwargs), *opcional*) : Opciones de procesamiento adicionales para cada modalidad (texto, imágenes, vídeos, audio). Los parámetros específicos del modelo se enumeran arriba; consulte la clase TypedDict para obtener la lista completa de argumentos admitidos.
**Devuelve:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *opcional*) -- Diccionario de listas/arrays/tensores devueltos por los métodos `__call__`/`encode_plus`/`batch_encode_plus` ('input_ids', 'attention_mask', etc.).
- **encoding** (`tokenizers.Encoding` o `Sequence[tokenizers.Encoding]`, *opcional*) -- Si el tokenizador es un tokenizador rápido que genera información adicional, como el mapeo del espacio de palabras/caracteres al espacio de tokens, la instancia de `tokenizers.Encoding` o la lista de instancias (para lotes) contiene esta información.
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
- **prepend_batch_axis** (`bool`, *opcional*, valor predeterminado `False`) -- Indica si se debe añadir un eje de lote al convertir a tensores (consulte `tensor_type` arriba). Tenga en cuenta que este parámetro tiene efecto si el parámetro `tensor_type` está establecido, *en caso contrario no tiene efecto*.
- **n_sequences** (`int`, *opcional*) -- El número de secuencias de entrada representadas por cada codificación (`None` para desconocido, `1` para una secuencia única y `2` para un par de secuencias).
## SamImageProcessor[[transformers.SamImageProcessor]]
#### transformers.SamImageProcessor[[transformers.SamImageProcessor]]
```python
transformers.SamImageProcessor(**kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/image_processing_sam.py#L61)
**Parámetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'longest_edge' : 1024}`): Describe las dimensiones máximas de entrada para el modelo.
default_to_square (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe usar una imagen cuadrada por defecto al redimensionar, cuando el tamaño es un entero.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, por defecto `2`) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*, valor predeterminado `0.00392156862745098`) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.485, 0.456, 0.406]`) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.229, 0.224, 0.225]`) : Desviación estándar de la imagen que se utilizará para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el mayor tamaño del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'height' : 1024, 'width': 1024}`): El tamaño en `{"height": int, "width" int}` al que rellenar las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
mask_size (`dict[str, *kwargs*, int]`, *opcional*) : El tamaño `{"longest_edge": int}` al que redimensionar los mapas de segmentación.
mask_pad_size (`dict[str, *kwargs*, int]`, *opcional*) : El tamaño `{"height": int, "width": int}` al que se rellenan los mapas de segmentación. Debe ser mayor que el tamaño de cualquier mapa de segmentación proporcionado para el preprocesamiento.
Construye un procesador de imágenes SamImageProcessor.
#### preprocess[[transformers.SamImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/image_processing_sam.py#L79)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
segmentation_maps (`ImageInput`, *opcional*) : Los mapas de segmentación que se van a preprocesar.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Si el tamaño es un entero, si se debe usar una imagen cuadrada por defecto al redimensionar.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
mask_size (`dict[str, *kwargs*, int]`, *opcional*) : El tamaño `{"longest_edge": int}` al que redimensionar los mapas de segmentación.
mask_pad_size (`dict[str, *kwargs*, int]`, *opcional*) : El tamaño `{"height": int, "width": int}` al que se rellenan los mapas de segmentación. Debe ser mayor que el tamaño de cualquier mapa de segmentación proporcionado para el preprocesamiento.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
## SamImageProcessorPil[[transformers.SamImageProcessorPil]]
#### transformers.SamImageProcessorPil[[transformers.SamImageProcessorPil]]
```python
transformers.SamImageProcessorPil(**kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/image_processing_pil_sam.py#L82)
**Parámetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'longest_edge' : 1024}`): Describe las dimensiones máximas de entrada para el modelo.
default_to_square (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe usar una imagen cuadrada por defecto al redimensionar, cuando el tamaño es un entero.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, por defecto `2`) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*, valor predeterminado `0.00392156862745098`) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.485, 0.456, 0.406]`) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.229, 0.224, 0.225]`) : Desviación estándar de la imagen que se utilizará para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el mayor tamaño del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'height' : 1024, 'width': 1024}`): El tamaño en `{"height": int, "width" int}` al que rellenar las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
mask_size (`dict[str, *kwargs*, int]`, *opcional*) : El tamaño `{"longest_edge": int}` al que redimensionar los mapas de segmentación.
mask_pad_size (`dict[str, *kwargs*, int]`, *opcional*) : El tamaño `{"height": int, "width": int}` al que se rellenan los mapas de segmentación. Debe ser mayor que el tamaño de cualquier mapa de segmentación proporcionado para el preprocesamiento.
Construye un procesador de imágenes SamImageProcessor.
#### preprocess[[transformers.SamImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/image_processing_pil_sam.py#L100)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
segmentation_maps (`ImageInput`, *opcional*) : Los mapas de segmentación que se van a preprocesar.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Si el tamaño es un entero, si se debe usar una imagen cuadrada por defecto al redimensionar.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
mask_size (`dict[str, *kwargs*, int]`, *opcional*) : El tamaño `{"longest_edge": int}` al que redimensionar los mapas de segmentación.
mask_pad_size (`dict[str, *kwargs*, int]`, *opcional*) : El tamaño `{"height": int, "width": int}` al que se rellenan los mapas de segmentación. Debe ser mayor que el tamaño de cualquier mapa de segmentación proporcionado para el preprocesamiento.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
## SamVisionModel[[transformers.SamVisionModel]]
#### transformers.SamVisionModel[[transformers.SamVisionModel]]
```python
transformers.SamVisionModel(config: SamVisionConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/modeling_sam.py#L1081)
**Parámetros:**
config ([SamVisionConfig](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamVisionConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo de visión de Sam sin ninguna cabeza ni proyección en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.SamVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/modeling_sam.py#L1093)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [SamImageProcessor](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamImageProcessor). Consulte [SamImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles ([SamProcessor](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamProcessor) usa [SamImageProcessor](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamImageProcessor) para procesar las imágenes).
**Devuelve:** `SamVisionEncoderOutput` o `tuple(torch.Tensor)`
Un `SamVisionEncoderOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([SamConfig](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamConfig)) y las entradas.
El método forward de [SamVisionModel](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamVisionModel) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **image_embeds** (`torch.Tensor` de forma `(batch_size, output_dim)` *opcional* devuelta cuando el modelo se inicializa con `with_projection=True`) -- Las incrustaciones de imagen obtenidas al aplicar la capa de proyección a pooler_output.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple[torch.Tensor, ...]`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
## SamModel[[transformers.SamModel]]
#### transformers.SamModel[[transformers.SamModel]]
```python
transformers.SamModel(config: SamConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/modeling_sam.py#L1108)
**Parámetros:**
config ([SamConfig](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Segment Anything Model (SAM) para generar máscaras de segmentación, a partir de una imagen de entrada y puntos y etiquetas de entrada, cajas o máscaras.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.SamModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, input_points: typing.Optional[torch.Tensor] = None, input_labels: typing.Optional[torch.LongTensor] = None, input_boxes: typing.Optional[torch.Tensor] = None, input_masks: typing.Optional[torch.LongTensor] = None, image_embeddings: typing.Optional[torch.Tensor] = None, multimask_output: bool = True, attention_similarity: typing.Optional[torch.Tensor] = None, target_embedding: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/modeling_sam.py#L1191)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [SamImageProcessor](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamImageProcessor). Consulte [SamImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles ([SamProcessor](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamProcessor) usa [SamImageProcessor](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamImageProcessor) para procesar las imágenes).
input_points (`torch.Tensor` de forma `(batch_size, num_points, 2)`) : Puntos espaciales 2D de entrada, que se utilizan en el codificador de prompts para codificar el prompt. Generalmente, produce resultados mucho mejores. Los puntos se pueden obtener pasando una lista de listas de listas al procesador, que creará los correspondientes tensores `torch` de dimensión 4. La primera dimensión es el tamaño del lote de imágenes, la segunda dimensión es el tamaño del lote de puntos (es decir, cuántas máscaras de segmentación queremos que el modelo prediga por cada punto de entrada), la tercera dimensión es el número de puntos por máscara de segmentación (es posible pasar varios puntos para una sola máscara) y la última dimensión son las coordenadas x (vertical) y y (horizontal) del punto. Si se pasa un número diferente de puntos para cada imagen o para cada máscara, el procesador creará puntos "PAD" que corresponderán a la coordenada (0, 0) y se omitirá el cálculo del embedding para estos puntos usando las etiquetas.
input_labels (`torch.LongTensor` de forma `(batch_size, point_batch_size, num_points)`) : Etiquetas de entrada para los puntos, que se utilizan en el codificador de prompts para codificar el prompt. Según la implementación oficial, existen 3 tipos de etiquetas: - `1`: el punto contiene el objeto de interés - `0`: el punto no contiene el objeto de interés - `-1`: el punto corresponde al fondo Añadimos la etiqueta: - `-10`: el punto es un punto de relleno, por lo que debe ser ignorado por el codificador de prompts Las etiquetas de relleno deben generarse automáticamente mediante el procesador.
input_boxes (`torch.Tensor` de forma `(batch_size, num_boxes, 4)`) : Cajas de entrada para los puntos, que se utilizan en el codificador de prompts para codificar el prompt. Generalmente, esto produce máscaras generadas mucho mejores. Las cajas se pueden obtener pasando una lista de listas de listas al procesador, que generará un tensor de `torch`, donde cada dimensión corresponde respectivamente al tamaño del lote de imágenes, al número de cajas por imagen y a las coordenadas del punto superior izquierdo y del punto inferior derecho de la caja. En el orden (`x1`, `y1`, `x2`, `y2`): - `x1`: la coordenada x del punto superior izquierdo de la caja de entrada - `y1`: la coordenada y del punto superior izquierdo de la caja de entrada - `x2`: la coordenada x del punto inferior derecho de la caja de entrada - `y2`: la coordenada y del punto inferior derecho de la caja de entrada
input_masks (`torch.Tensor` de forma `(batch_size, image_size, image_size)`) : El modelo SAM también acepta máscaras de segmentación como entrada. La máscara se incrustará mediante el codificador de prompts para generar una incrustación correspondiente, que se enviará más adelante al decodificador de máscaras. Estas máscaras deben ser proporcionadas manualmente por el usuario y deben tener la forma (`batch_size`, `image_size`, `image_size`).
image_embeddings (`torch.Tensor` de forma `(batch_size, output_channels, window_size, window_size)`) : Incrustaciones de imagen, se utilizan en el decodificador de máscaras para generar máscaras y puntuaciones iou. Para un cálculo más eficiente en memoria, los usuarios pueden obtener primero las incrustaciones de imagen mediante el método `get_image_embeddings` y luego pasarlas al método `forward` en lugar de pasar `pixel_values`.
multimask_output (`bool`, *opcional*) : En la implementación y el artículo originales, el modelo siempre genera 3 máscaras por imagen (o por punto / por cuadro delimitador, si corresponde). Sin embargo, es posible generar una sola máscara, que corresponde a la máscara "óptima", especificando `multimask_output=False`.
attention_similarity (`torch.Tensor`, *opcional*) : Tensor de similitud de atención, que debe proporcionarse al decodificador de máscaras para la atención guiada por objetivos en caso de que el modelo se utilice para personalización, tal como se introduce en [PerSAM](https://huggingface.co/papers/2305.03048).
target_embedding (`torch.Tensor`, *opcional*) : Incrustación del concepto objetivo, que debe proporcionarse al decodificador de máscaras para el prompting semántico del objetivo en caso de que el modelo se utilice para personalización, tal como se introduce en [PerSAM](https://huggingface.co/papers/2305.03048).
**Devuelve:** `SamImageSegmentationOutput` o `tuple(torch.Tensor)`
Un `SamImageSegmentationOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([SamConfig](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamConfig)) y las entradas.
El método forward de [SamModel](/docs/transformers/v5.23.0/es/model_doc/sam#transformers.SamModel) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **iou_scores** (`torch.Tensor` de forma `(batch_size, num_masks)`) -- Las puntuaciones iou de las máscaras predichas.
- **pred_masks** (`torch.Tensor` de forma `(batch_size, num_masks, height, width)`) -- Las máscaras de baja resolución predichas. Deben ser procesadas posteriormente por el procesador
- **vision_hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo de visión en la salida de cada capa, más las salidas opcionales de la incrustación inicial.
- **vision_attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
- **mask_decoder_attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplo:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoModel, AutoProcessor
>>> model = AutoModel.from_pretrained("facebook/sam-vit-base")
>>> processor = AutoProcessor.from_pretrained("facebook/sam-vit-base")
>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/model_doc/sam-car.png"
>>> with httpx.stream("GET", url) as response:
... raw_image = Image.open(BytesIO(response.read())).convert("RGB")
>>> input_points = [[[400, 650]]] # 2D location of a window on the car
>>> inputs = processor(images=raw_image, input_points=input_points, return_tensors="pt")
>>> # Get segmentation mask
>>> outputs = model(**inputs)
>>> # Postprocess masks
>>> masks = processor.post_process_masks(
... outputs.pred_masks, inputs["original_sizes"], inputs["reshaped_input_sizes"]
... )
```