# ImageGPT
## Resumen
El modelo ImageGPT fue propuesto en [Generative Pretraining from Pixels](https://openai.com/blog/image-gpt) por Mark Chen, Alec Radford, Rewon Child, Jeffrey Wu, Heewoo Jun, David Luan e Ilya Sutskever. ImageGPT (iGPT) es un modelo similar a GPT-2 entrenado para predecir el valor del próximo píxel, lo que permite tanto la generación de imágenes incondicional como condicional.
El resumen del [artículo](https://cdn.openai.com/papers/Generative_Pretraining_from_Pixels_V1_ICML.pdf) es el siguiente:
*Inspirados por los avances en el aprendizaje de representaciones no supervisadas para el lenguaje natural, examinamos si modelos similares pueden aprender representaciones útiles para imágenes. Entrenamos un Transformer de secuencia para predecir píxeles de forma auto-regresiva, sin incorporar conocimiento de la estructura 2D de la entrada. A pesar de entrenar en ImageNet de baja resolución sin etiquetas, descubrimos que un modelo a escala de GPT-2 aprende representaciones de imagen sólidas, medidas mediante sondeo lineal, ajuste fino y clasificación con pocos datos. En CIFAR-10, logramos una precisión del 96,3 % con un sondeo lineal, superando a un Wide ResNet supervisado, y una precisión del 99,0 % con ajuste fino completo, igualando a los mejores modelos preentrenados supervisados. También somos competitivos con los puntos de referencia auto-supervisados en ImageNet al sustituir los píxeles por una codificación VQVAE, alcanzando una precisión top-1 del 69,0 % en un sondeo lineal de nuestras características.*
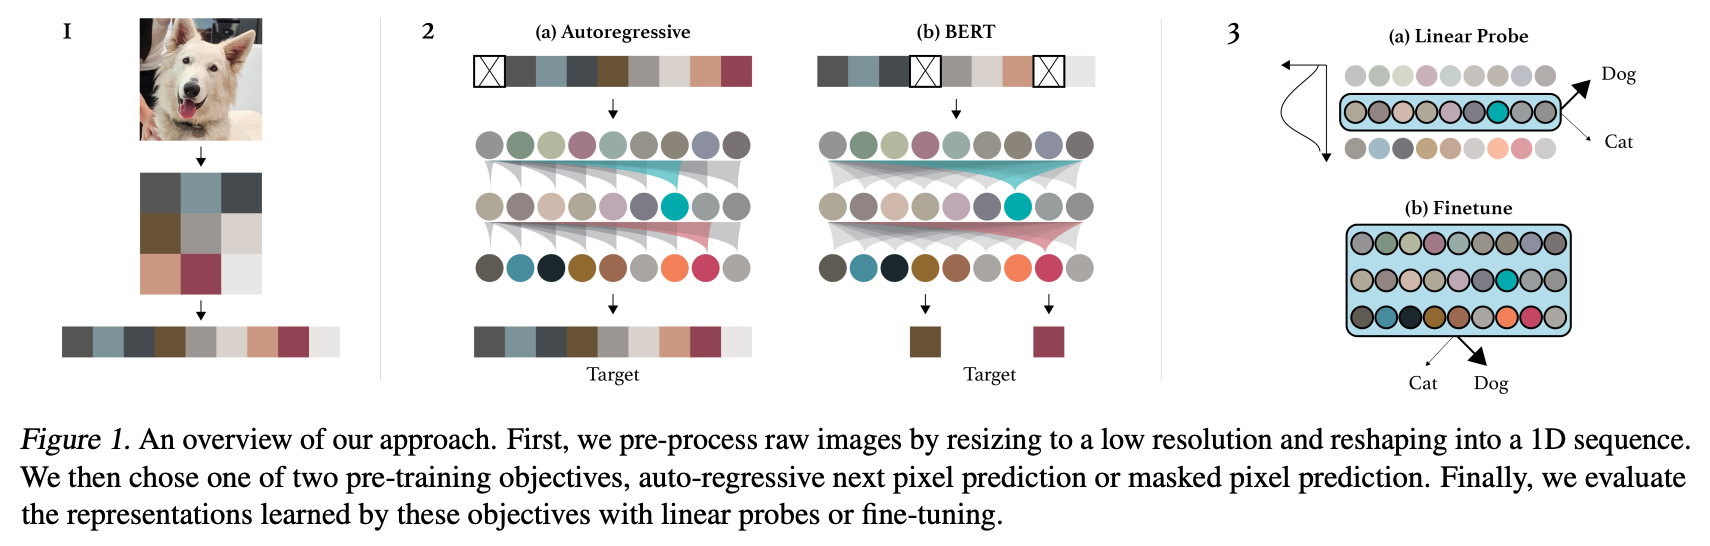 Resumen del enfoque. Tomado del [artículo original](https://cdn.openai.com/papers/Generative_Pretraining_from_Pixels_V2.pdf).
Este modelo fue aportado por [nielsr](https://huggingface.co/nielsr), basado en [este problema](https://github.com/openai/image-gpt/issues/7). El código original se puede encontrar [aquí](https://github.com/openai/image-gpt).
## Consejos de uso
- ImageGPT es prácticamente idéntico a [GPT-2](gpt2), con la excepción de que se utiliza una función de activación diferente (específicamente "quick gelu") y las capas de normalización de capas no centran las entradas. ImageGPT tampoco tiene incrustaciones de entrada y salida vinculadas.
- Dado que los requisitos de tiempo y memoria del mecanismo de atención de Transformers escalan de forma cuadrática con la longitud de la secuencia, los autores preentrenaron ImageGPT con resoluciones de entrada más pequeñas, como 32x32 y 64x64. Sin embargo, alimentar una secuencia de 32x32x3=3072 tokens con valores de 0..255 a un Transformer sigue siendo prohibitivamente grande. Por lo tanto, los autores aplicaron clustering k-means a los valores de píxel (R,G,B) con k=512. De esta manera, solo tenemos una secuencia de longitud 32*32 = 1024, pero ahora de enteros en el rango 0..511. Es decir, estamos reduciendo la longitud de la secuencia a costa de una matriz de embedding más grande. En otras palabras, el tamaño del vocabulario de ImageGPT es 512, + 1 para un token especial "start of sentence" (SOS), utilizado al inicio de cada secuencia. Se puede usar [ImageGPTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/imagegpt#transformers.ImageGPTImageProcessor) para preparar las imágenes para el modelo.
- A pesar de haber sido preentrenado de forma completamente no supervisada (es decir, sin el uso de ninguna etiqueta), ImageGPT genera características de imagen bastante eficaces y útiles para tareas posteriores, como la clasificación de imágenes. Los autores demostraron que las características en la parte media de la red son las más eficaces y pueden utilizarse tal cual para entrenar un modelo lineal (por ejemplo, un modelo de regresión logística de sklearn). A esto también se le conoce como "linear probing". Las características se pueden obtener fácilmente enviando primero la imagen a través del modelo, especificando luego `output_hidden_states=True` y, a continuación, aplicando average-pooling a los hidden states de la capa que se desee.
- Como alternativa, se puede realizar un ajuste fino adicional de todo el modelo en un conjunto de datos de un caso de uso específico, de manera similar a BERT. Para ello, puede utilizar [ImageGPTForImageClassification](/docs/transformers/v5.23.0/es/model_doc/imagegpt#transformers.ImageGPTForImageClassification).
- ImageGPT está disponible en diferentes tamaños: hay ImageGPT-small, ImageGPT-medium y ImageGPT-large. Los autores también entrenaron una variante XL, que no publicaron. Las diferencias de tamaño se resumen en la siguiente tabla:
| **Variante del modelo** | **Profundidades** | **Tamaños ocultos** | **Tamaño oculto del decodificador** | **Parámetros (M)** | **ImageNet-1k Top 1** |
|---|---|---|---|---|---|
| MiT-b0 | [2, 2, 2, 2] | [32, 64, 160, 256] | 256 | 3.7 | 70.5 |
| MiT-b1 | [2, 2, 2, 2] | [64, 128, 320, 512] | 256 | 14.0 | 78.7 |
| MiT-b2 | [3, 4, 6, 3] | [64, 128, 320, 512] | 768 | 25.4 | 81.6 |
| MiT-b3 | [3, 4, 18, 3] | [64, 128, 320, 512] | 768 | 45.2 | 83.1 |
| MiT-b4 | [3, 8, 27, 3] | [64, 128, 320, 512] | 768 | 62.6 | 83.6 |
| MiT-b5 | [3, 6, 40, 3] | [64, 128, 320, 512] | 768 | 82.0 | 83.8 |
## Recursos
Una lista de recursos oficiales de Hugging Face y de la comunidad (indicados por 🌎) para ayudarte a empezar con ImageGPT.
- Los cuadernos de demostración de ImageGPT se pueden encontrar [aquí](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/ImageGPT).
- [ImageGPTForImageClassification](/docs/transformers/v5.23.0/es/model_doc/imagegpt#transformers.ImageGPTForImageClassification) es compatible con este [cuaderno](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb).
- Véase también: [Guía de la tarea de clasificación de imágenes](../tasks/image_classification)
Si te interesa enviar un recurso para que se incluya aquí, no dudes en abrir una Pull Request y lo revisaremos. Lo ideal es que el recurso demuestre algo nuevo en lugar de duplicar un recurso existente.
## ImageGPTConfig[[transformers.ImageGPTConfig]]
#### transformers.ImageGPTConfig[[transformers.ImageGPTConfig]]
```python
transformers.ImageGPTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 513, n_positions: int = 1024, n_embd: int = 512, n_layer: int = 24, n_head: int = 8, n_inner: int | None = None, activation_function: str = 'quick_gelu', resid_pdrop: float | int = 0.1, embd_pdrop: float | int = 0.1, attn_pdrop: float | int = 0.1, layer_norm_epsilon: float = 1e-05, initializer_range: float = 0.02, scale_attn_weights: bool = True, use_cache: bool = True, tie_word_embeddings: bool = False, scale_attn_by_inverse_layer_idx: bool = False, reorder_and_upcast_attn: bool = False, add_cross_attention: bool = False, pad_token_id: int | None = None, bos_token_id: int | None = None, eos_token_id: int | list[int] | None = None)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/configuration_imagegpt.py#L24)
**Parámetros:**
vocab_size (`int`, *opcional*, valor predeterminado `513`) : Tamaño del vocabulario del modelo. Define el número de tokens diferentes que pueden representarse mediante `input_ids`.
n_positions (`int`, *opcional*, valor predeterminado `1024`) : La longitud máxima de secuencia con la que se podría utilizar este modelo.
n_embd (`int`, *opcional*, valor predeterminado `512`) : Dimensionalidad de los embeddings y los estados ocultos.
n_layer (`int`, *opcional*, valor predeterminado `24`) : Número de capas ocultas en el decodificador del Transformer.
n_head (`int`, *opcional*, valor predeterminado `8`) : Número de cabezas de atención para cada capa de atención en el decodificador del Transformer.
n_inner (`int`, *opcional*) : Dimensión de las representaciones del MLP.
activation_function (`str`, *opcional*, valor predeterminado `quick_gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
resid_pdrop (`Union[float, int]`, *opcional*, valor predeterminado `0.1`) : La probabilidad de dropout para todas las capas totalmente conectadas en los embeddings, el codificador y el pooler.
embd_pdrop (`Union[float, int]`, *opcional*, valor predeterminado `0.1`) : La proporción de dropout para los embeddings.
attn_pdrop (`Union[float, int]`, *opcional*, valor predeterminado `0.1`) : La proporción de dropout para las probabilidades de atención.
layer_norm_epsilon (`float`, *opcional*, valor predeterminado `1e-05`) : El epsilon utilizado por las capas de normalización de capas.
initializer_range (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
scale_attn_weights (`bool`, *opcional*, valor predeterminado `True`) : Si se deben escalar los embeddings dividiendo por sqrt(d_model).
use_cache (`bool`, *opcional*, valor predeterminado `True`) : Indica si el modelo debe devolver las últimas atenciones de claves/valores (no se utiliza en todos los modelos). Solo es relevante si `config.is_decoder=True` o cuando el modelo es un modelo generativo solo de decodificador.
tie_word_embeddings (`bool`, *opcional*, valor predeterminado `False`) : Si se deben vincular las incrustaciones de pesos según el mapeo `tied_weights_keys` del modelo.
scale_attn_by_inverse_layer_idx (`bool`, *opcional*, valor predeterminado `False`) : Si se deben escalar adicionalmente los pesos de atención por `1 / layer_idx + 1`.
reorder_and_upcast_attn (`bool`, *opcional*, valor predeterminado `False`) : Si se deben escalar las claves (K) antes de calcular la atención (producto punto) y si se debe convertir el producto punto/softmax de la atención a float() durante el entrenamiento con precisión mixta.
add_cross_attention (`bool`, *opcional*, valor predeterminado `False`) : Si se deben añadir capas de atención cruzada al modelo.
pad_token_id (`int`, *opcional*) : Id de token utilizado para el relleno en el vocabulario.
bos_token_id (`int`, *opcional*) : Id de token utilizado para el inicio de la secuencia en el vocabulario.
eos_token_id (`Union[int, list[int]]`, *opcional*) : Id de token utilizado para el fin de la secuencia en el vocabulario.
Esta es la clase de configuración para almacenar la configuración de un ImageGPTModel. Se utiliza para instanciar un modelo Imagegpt según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [openai/imagegpt-small](https://huggingface.co/openai/imagegpt-small)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import ImageGPTConfig, ImageGPTModel
>>> # Initializing a ImageGPT configuration
>>> configuration = ImageGPTConfig()
>>> # Initializing a model (with random weights) from the configuration
>>> model = ImageGPTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ImageGPTImageProcessor[[transformers.ImageGPTImageProcessor]]
#### transformers.ImageGPTImageProcessor[[transformers.ImageGPTImageProcessor]]
```python
transformers.ImageGPTImageProcessor(clusters: typing.Union[list, numpy.ndarray, torch.Tensor, NoneType] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/image_processing_imagegpt.py#L82)
**Parámetros:**
clusters (`np.ndarray` o `list[list[int]]` o `torch.Tensor`, *opcional*) : Los clústeres de color a utilizar, de forma `(n_clusters, 3)` al cuantizar el color. Se puede sobrescribir mediante `clusters` en `preprocess`.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'height' : 256, 'width': 256}`): Describe las dimensiones máximas de entrada para el modelo.
default_to_square (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe usar una imagen cuadrada por defecto al redimensionar, cuando el tamaño es un entero.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, por defecto `2`) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*, valor predeterminado `0.00392156862745098`) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.5, 0.5, 0.5]`) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.5, 0.5, 0.5]`) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
clusters (`np.ndarray`, *kwargs* o `list[list[int]]` o `torch.Tensor`, *opcional*, valor predeterminado `self.clusters`) : Los clústeres de color a utilizar, de forma `(n_clusters, 3)` al cuantizar el color. Se puede sobrescribir mediante `clusters` en `preprocess`.
do_color_quantize (`bool`, *kwargs*, *opcional*, valor predeterminado `self.do_color_quantize`) : Controla si se aplica la cuantización de color para convertir los valores de píxeles continuos en índices discretos de clúster. Cuando es True, cada píxel se asigna a su clúster de color más cercano, lo que permite la modelización de tokens discretos de ImageGPT.
Construye un procesador de imágenes ImageGPTImageProcessor.
#### preprocess[[transformers.ImageGPTImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Bandera para desarrolladores destinada a entradas adicionales similares a imágenes que también se preprocesarán. Utilice esto solo si pasar las entradas como kwarg no funciona. Por ejemplo, `preprocess(images, masks=masks)` es la opción preferida, pero puede provocar problemas de prioridad de argumentos en algunos modelos. En esos casos, se puede usar `preprocess(images, image_like_inputs={"masks": masks})` en su lugar.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Si el tamaño es un entero, si se debe usar una imagen cuadrada por defecto al redimensionar.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
Preprocesa una imagen o un lote de imágenes.
## ImageGPTImageProcessorPil[[transformers.ImageGPTImageProcessorPil]]
#### transformers.ImageGPTImageProcessorPil[[transformers.ImageGPTImageProcessorPil]]
```python
transformers.ImageGPTImageProcessorPil(clusters: list | np.ndarray | torch.Tensor | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/image_processing_pil_imagegpt.py#L69)
**Parámetros:**
clusters (`np.ndarray` o `list[list[int]]` o `torch.Tensor`, *opcional*) : Los clústeres de color a utilizar, de forma `(n_clusters, 3)` al cuantizar el color. Se puede sobrescribir mediante `clusters` en `preprocess`.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'height' : 256, 'width': 256}`): Describe las dimensiones máximas de entrada para el modelo.
default_to_square (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe usar una imagen cuadrada por defecto al redimensionar, cuando el tamaño es un entero.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, por defecto `2`) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*, valor predeterminado `0.00392156862745098`) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.5, 0.5, 0.5]`) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.5, 0.5, 0.5]`) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
clusters (`np.ndarray`, *kwargs* o `list[list[int]]` o `torch.Tensor`, *opcional*, valor predeterminado `self.clusters`) : Los clústeres de color a utilizar, de forma `(n_clusters, 3)` al cuantizar el color. Se puede sobrescribir mediante `clusters` en `preprocess`.
do_color_quantize (`bool`, *kwargs*, *opcional*, valor predeterminado `self.do_color_quantize`) : Controla si se aplica la cuantización de color para convertir los valores de píxeles continuos en índices discretos de clúster. Cuando es True, cada píxel se asigna a su clúster de color más cercano, lo que permite la modelización de tokens discretos de ImageGPT.
Construye un procesador de imágenes ImageGPTImageProcessor.
#### preprocess[[transformers.ImageGPTImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Bandera para desarrolladores destinada a entradas adicionales similares a imágenes que también se preprocesarán. Utilice esto solo si pasar las entradas como kwarg no funciona. Por ejemplo, `preprocess(images, masks=masks)` es la opción preferida, pero puede provocar problemas de prioridad de argumentos en algunos modelos. En esos casos, se puede usar `preprocess(images, image_like_inputs={"masks": masks})` en su lugar.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Si el tamaño es un entero, si se debe usar una imagen cuadrada por defecto al redimensionar.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
Preprocesa una imagen o un lote de imágenes.
## ImageGPTModel[[transformers.ImageGPTModel]]
#### transformers.ImageGPTModel[[transformers.ImageGPTModel]]
```python
transformers.ImageGPTModel(config: ImageGPTConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/modeling_imagegpt.py#L393)
**Parámetros:**
config ([ImageGPTConfig](/docs/transformers/v5.23.0/es/model_doc/imagegpt#transformers.ImageGPTConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo Imagegpt básico que genera estados ocultos sin ninguna cabeza específica en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.ImageGPTModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/modeling_imagegpt.py#L416)
**Parámetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, input_ids_length)`) : `input_ids_length` = `sequence_length` si `past_key_values` es `None`, en caso contrario `past_key_values.get_seq_length()` (`sequence_length` de los estados de clave y valor pasados de entrada). Índices de los tokens de la secuencia de entrada en el vocabulario. Si se utiliza `past_key_values`, solo se deben pasar como `input_ids` los `input_ids` que no tengan su pasado calculado. Los índices se pueden obtener mediante [AutoImageProcessor](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoImageProcessor). Consulte [ImageGPTImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obtener más detalles.
past_key_values (`~cache_utils.Cache`, *opcional*) : Estados ocultos precalculados (claves y valores en los bloques de autoatención y en los bloques de atención cruzada) que se pueden utilizar para acelerar la decodificación secuencial. Esto suele consistir en los `past_key_values` devueltos por el modelo en una etapa anterior de la decodificación, cuando `use_cache=True` o `config.use_cache=True`. Solo se permite una instancia de [Cache](/docs/transformers/v5.23.0/es/internal/generation_utils#transformers.Cache) como entrada, consulte nuestra [guía de caché kv](https://huggingface.co/docs/transformers/en/kv_cache). Si no se pasan `past_key_values`, se inicializará [DynamicCache](/docs/transformers/v5.23.0/es/internal/generation_utils#transformers.DynamicCache) de forma predeterminada. El modelo devolverá el mismo formato de caché que se haya proporcionado como entrada. Si se utilizan `past_key_values`, se espera que el usuario introduzca solo los `input_ids` no procesados (aquellos que no tienen sus estados de clave y valor previos dados a este modelo) con forma `(batch_size, unprocessed_length)` en lugar de todos los `input_ids` con forma `(batch_size, sequence_length)`.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
encoder_hidden_states (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Secuencia de estados ocultos en la salida de la última capa del codificador. Se utiliza en la atención cruzada si el modelo está configurado como decodificador.
encoder_attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno de la entrada del codificador. Esta máscara se utiliza en la atención cruzada si el modelo está configurado como decodificador. Valores de máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**.
use_cache (`bool`, *opcional*) : Si se establece en `True`, se devuelven los estados de valores clave `past_key_values` y pueden usarse para acelerar la decodificación (ver `past_key_values`).
output_attentions (`bool`, *opcional*) : Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulte `attentions` en los tensores devueltos para obtener más detalles.
output_hidden_states (`bool`, *opcional*) : Indica si se deben devolver los estados ocultos de todas las capas. Consulte `hidden_states` en los tensores devueltos para obtener más detalles.
return_dict (`bool`, *opcional*) : Indica si se debe devolver un [ModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.utils.ModelOutput) en lugar de una tupla simple.
**Devuelve:** [BaseModelOutputWithPastAndCrossAttentions](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPastAndCrossAttentions) o `tuple(torch.Tensor)`
Un [BaseModelOutputWithPastAndCrossAttentions](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPastAndCrossAttentions) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([ImageGPTConfig](/docs/transformers/v5.23.0/es/model_doc/imagegpt#transformers.ImageGPTConfig)) y las entradas.
El método forward de [ImageGPTModel](/docs/transformers/v5.23.0/es/model_doc/imagegpt#transformers.ImageGPTModel) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
Si se utiliza `past_key_values`, solo se genera el último hidden-state de las secuencias con forma `(batch_size, 1, hidden_size)`.
- **past_key_values** (`Cache`, *opcional*, se devuelve cuando se pasa `use_cache=True` o cuando `config.use_cache=True`) -- Es una instancia de [Cache](/docs/transformers/v5.23.0/es/internal/generation_utils#transformers.Cache). Para más detalles, consulte nuestra [guía de caché kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contiene estados ocultos precalculados (claves y valores en los bloques de autoatención y, opcionalmente, si `config.is_encoder_decoder=True`, en los bloques de atención cruzada) que pueden utilizarse (véase la entrada `past_key_values`) para acelerar la decodificación secuencial.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
- **cross_attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` y `config.add_cross_attention=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención de la capa de atención cruzada del decodificador, después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de atención cruzada.
Ejemplos:
```python
>>> from transformers import AutoImageProcessor, ImageGPTModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTModel.from_pretrained("openai/imagegpt-small")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ImageGPTForCausalImageModeling[[transformers.ImageGPTForCausalImageModeling]]
#### transformers.ImageGPTForCausalImageModeling[[transformers.ImageGPTForCausalImageModeling]]
```python
transformers.ImageGPTForCausalImageModeling(config: ImageGPTConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/modeling_imagegpt.py#L594)
**Parámetros:**
config ([ImageGPTConfig](/docs/transformers/v5.23.0/es/model_doc/imagegpt#transformers.ImageGPTConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo ImageGPT, un transformer con una cabeza de modelado de lenguaje en la parte superior (capa lineal con pesos vinculados a las incrustaciones de entrada).
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.ImageGPTForCausalImageModeling.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/modeling_imagegpt.py#L605)
**Parámetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, input_ids_length)`) : `input_ids_length` = `sequence_length` si `past_key_values` es `None`, en caso contrario `past_key_values.get_seq_length()` (`sequence_length` de los estados de clave y valor pasados de entrada). Índices de los tokens de la secuencia de entrada en el vocabulario. Si se utiliza `past_key_values`, solo se deben pasar como `input_ids` los `input_ids` que no tengan su pasado calculado. Los índices se pueden obtener mediante [AutoImageProcessor](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoImageProcessor). Consulte [ImageGPTImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obtener más detalles.
past_key_values (`~cache_utils.Cache`, *opcional*) : Estados ocultos precalculados (claves y valores en los bloques de autoatención y en los bloques de atención cruzada) que se pueden utilizar para acelerar la decodificación secuencial. Esto suele consistir en los `past_key_values` devueltos por el modelo en una etapa anterior de la decodificación, cuando `use_cache=True` o `config.use_cache=True`. Solo se permite una instancia de [Cache](/docs/transformers/v5.23.0/es/internal/generation_utils#transformers.Cache) como entrada, consulte nuestra [guía de caché kv](https://huggingface.co/docs/transformers/en/kv_cache). Si no se pasan `past_key_values`, se inicializará [DynamicCache](/docs/transformers/v5.23.0/es/internal/generation_utils#transformers.DynamicCache) de forma predeterminada. El modelo devolverá el mismo formato de caché que se haya proporcionado como entrada. Si se utilizan `past_key_values`, se espera que el usuario introduzca solo los `input_ids` no procesados (aquellos que no tienen sus estados de clave y valor previos dados a este modelo) con forma `(batch_size, unprocessed_length)` en lugar de todos los `input_ids` con forma `(batch_size, sequence_length)`.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
encoder_hidden_states (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Secuencia de estados ocultos en la salida de la última capa del codificador. Se utiliza en la atención cruzada si el modelo está configurado como decodificador.
encoder_attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno de la entrada del codificador. Esta máscara se utiliza en la atención cruzada si el modelo está configurado como decodificador. Valores de máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**.
labels (`torch.LongTensor` de forma `(batch_size, input_ids_length)`, *opcional*) : Etiquetas para el modelado de lenguaje. Tenga en cuenta que las etiquetas **se desplazan** dentro del modelo, es decir, puede establecer `labels = input_ids` Los índices se seleccionan en `[-100, 0, ..., config.vocab_size]` Todas las etiquetas establecidas en `-100` se ignoran (se enmascaran); la pérdida solo se calcula para las etiquetas en `[0, ..., config.vocab_size]`
use_cache (`bool`, *opcional*) : Si se establece en `True`, se devuelven los estados de valores clave `past_key_values` y pueden usarse para acelerar la decodificación (ver `past_key_values`).
output_attentions (`bool`, *opcional*) : Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulte `attentions` en los tensores devueltos para obtener más detalles.
output_hidden_states (`bool`, *opcional*) : Indica si se deben devolver los estados ocultos de todas las capas. Consulte `hidden_states` en los tensores devueltos para obtener más detalles.
return_dict (`bool`, *opcional*) : Indica si se debe devolver un [ModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.utils.ModelOutput) en lugar de una tupla simple.
**Devuelve:** [CausalLMOutputWithCrossAttentions](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) o `tuple(torch.Tensor)`
Un [CausalLMOutputWithCrossAttentions](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([ImageGPTConfig](/docs/transformers/v5.23.0/es/model_doc/imagegpt#transformers.ImageGPTConfig)) y las entradas.
El método forward de [ImageGPTForCausalImageModeling](/docs/transformers/v5.23.0/es/model_doc/imagegpt#transformers.ImageGPTForCausalImageModeling) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, se devuelve cuando se proporciona `labels`) -- Pérdida de modelado de lenguaje (para la predicción del siguiente token).
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Puntuaciones de predicción de la cabeza de modelado de lenguaje (puntuaciones para cada token del vocabulario antes de SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
- **cross_attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de las atenciones cruzadas después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de atención cruzada.
- **past_key_values** (`Cache`, *opcional*, se devuelve cuando se pasa `use_cache=True` o cuando `config.use_cache=True`) -- Es una instancia de [Cache](/docs/transformers/v5.23.0/es/internal/generation_utils#transformers.Cache). Para más detalles, consulte nuestra [guía de caché kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contiene estados ocultos precalculados (claves y valores en los bloques de atención) que se pueden utilizar (véase la entrada `past_key_values`) para acelerar la decodificación secuencial.
Ejemplos:
```python
>>> from transformers import AutoImageProcessor, ImageGPTForCausalImageModeling
>>> import torch
>>> import matplotlib.pyplot as plt
>>> import numpy as np
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTForCausalImageModeling.from_pretrained("openai/imagegpt-small")
>>> device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
>>> model.to(device)
>>> # unconditional generation of 8 images
>>> batch_size = 4
>>> context = torch.full((batch_size, 1), model.config.vocab_size - 1) # initialize with SOS token
>>> context = context.to(device)
>>> output = model.generate(
... input_ids=context, max_length=model.config.n_positions + 1, temperature=1.0, do_sample=True, top_k=40
... )
>>> clusters = image_processor.clusters
>>> height = image_processor.size["height"]
>>> width = image_processor.size["width"]
>>> samples = output[:, 1:].detach().cpu().numpy()
>>> samples_img = [
... np.reshape(np.rint(127.5 * (clusters[s] + 1.0)), [height, width, 3]).astype(np.uint8) for s in samples
... ] # convert color cluster tokens back to pixels
>>> f, axes = plt.subplots(1, batch_size, dpi=300)
>>> for img, ax in zip(samples_img, axes):
... ax.axis("off")
... ax.imshow(img)
```
## ImageGPTForImageClassification[[transformers.ImageGPTForImageClassification]]
#### transformers.ImageGPTForImageClassification[[transformers.ImageGPTForImageClassification]]
```python
transformers.ImageGPTForImageClassification(config: ImageGPTConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/modeling_imagegpt.py#L723)
**Parámetros:**
config ([ImageGPTConfig](/docs/transformers/v5.23.0/es/model_doc/imagegpt#transformers.ImageGPTConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo ImageGPT es un transformer con una cabeza de clasificación de imágenes en la parte superior (capa lineal). [ImageGPTForImageClassification](/docs/transformers/v5.23.0/es/model_doc/imagegpt#transformers.ImageGPTForImageClassification) realiza un promedio de las ocultas (hidden states) para llevar a cabo la clasificación.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.ImageGPTForImageClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/imagegpt/modeling_imagegpt.py#L733)
**Parámetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, input_ids_length)`) : `input_ids_length` = `sequence_length` si `past_key_values` es `None`, en caso contrario `past_key_values.get_seq_length()` (`sequence_length` de los estados de clave y valor pasados de entrada). Índices de los tokens de la secuencia de entrada en el vocabulario. Si se utiliza `past_key_values`, solo se deben pasar como `input_ids` los `input_ids` que no tengan su pasado calculado. Los índices se pueden obtener mediante [AutoImageProcessor](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoImageProcessor). Consulte [ImageGPTImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obtener más detalles.
past_key_values (`~cache_utils.Cache`, *opcional*) : Estados ocultos precalculados (claves y valores en los bloques de autoatención y en los bloques de atención cruzada) que se pueden utilizar para acelerar la decodificación secuencial. Esto suele consistir en los `past_key_values` devueltos por el modelo en una etapa anterior de la decodificación, cuando `use_cache=True` o `config.use_cache=True`. Solo se permite una instancia de [Cache](/docs/transformers/v5.23.0/es/internal/generation_utils#transformers.Cache) como entrada, consulte nuestra [guía de caché kv](https://huggingface.co/docs/transformers/en/kv_cache). Si no se pasan `past_key_values`, se inicializará [DynamicCache](/docs/transformers/v5.23.0/es/internal/generation_utils#transformers.DynamicCache) de forma predeterminada. El modelo devolverá el mismo formato de caché que se haya proporcionado como entrada. Si se utilizan `past_key_values`, se espera que el usuario introduzca solo los `input_ids` no procesados (aquellos que no tienen sus estados de clave y valor previos dados a este modelo) con forma `(batch_size, unprocessed_length)` en lugar de todos los `input_ids` con forma `(batch_size, sequence_length)`.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Etiquetas para calcular la pérdida de clasificación/regresión de secuencia. Los índices deben estar en `[0, ..., config.num_labels - 1]`. Si `config.num_labels == 1` se calcula una pérdida de regresión (pérdida de error cuadrático medio), si `config.num_labels > 1` se calcula una pérdida de clasificación (entropía cruzada).
use_cache (`bool`, *opcional*) : Si se establece en `True`, se devuelven los estados de valores clave `past_key_values` y pueden usarse para acelerar la decodificación (ver `past_key_values`).
output_attentions (`bool`, *opcional*) : Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulte `attentions` en los tensores devueltos para obtener más detalles.
output_hidden_states (`bool`, *opcional*) : Indica si se deben devolver los estados ocultos de todas las capas. Consulte `hidden_states` en los tensores devueltos para obtener más detalles.
return_dict (`bool`, *opcional*) : Indica si se debe devolver un [ModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.utils.ModelOutput) en lugar de una tupla simple.
**Devuelve:** `SequenceClassifierOutputWithPast` o `tuple(torch.Tensor)`
Un `SequenceClassifierOutputWithPast` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([ImageGPTConfig](/docs/transformers/v5.23.0/es/model_doc/imagegpt#transformers.ImageGPTConfig)) y las entradas.
El método forward de [ImageGPTForImageClassification](/docs/transformers/v5.23.0/es/model_doc/imagegpt#transformers.ImageGPTForImageClassification) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, se devuelve cuando se proporciona `labels`) -- Pérdida de clasificación (o de regresión si config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Puntuaciones de clasificación (o de regresión si config.num_labels==1) (antes de SoftMax).
- **past_key_values** (`Cache`, *opcional*, se devuelve cuando se pasa `use_cache=True` o cuando `config.use_cache=True`) -- Es una instancia de [Cache](/docs/transformers/v5.23.0/es/internal/generation_utils#transformers.Cache). Para más detalles, consulte nuestra [guía de caché kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contiene estados ocultos precalculados (claves y valores en los bloques de autoatención) que pueden utilizarse (véase la entrada `past_key_values`) para acelerar la decodificación secuencial.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> from transformers import AutoImageProcessor, ImageGPTForImageClassification
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTForImageClassification.from_pretrained("openai/imagegpt-small")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> logits = outputs.logits
```