# Generación de texto a video con AnimateDiff
## Resumen
[AnimateDiff: Anima tus modelos de difusión de texto a imagen personalizados sin ajuste específico](https://huggingface.co/papers/2307.04725) de Yuwei Guo, Ceyuan Yang, Anyi Rao, Yaohui Wang, Yu Qiao, Dahua Lin, Bo Dai.
El resumen del artículo es el siguiente:
*Con el avance de los modelos de texto a imagen (p. ej., Stable Diffusion) y las técnicas de personalización correspondientes, como DreamBooth y LoRA, cualquier persona puede materializar su imaginación en imágenes de alta calidad a un costo asequible. Como consecuencia, existe una gran demanda de técnicas de animación de imágenes para combinar aún más las imágenes estáticas generadas con la dinámica del movimiento. En este informe, proponemos un marco práctico para animar de una vez por todas la mayoría de los modelos de texto a imagen personalizados existentes, ahorrando esfuerzos en el ajuste específico de cada modelo. El núcleo del marco propuesto consiste en insertar un módulo de modelado de movimiento recién inicializado en el modelo de texto a imagen congelado y entrenarlo en clips de video para destilar priors de movimiento razonables. Una vez entrenado, al inyectar simplemente este módulo de modelado de movimiento, todas las versiones personalizadas derivadas de la misma base T2I se convierten fácilmente en modelos impulsados por texto que producen imágenes animadas diversas y personalizadas. Realizamos nuestra evaluación en varios modelos públicos y representativos de texto a imagen personalizados, abarcando imágenes de anime y fotografías realistas, y demostramos que nuestro marco propuesto ayuda a estos modelos a generar clips de animación temporalmente suaves mientras preserva el dominio y la diversidad de sus salidas. El código y los pesos preentrenados estarán disponibles públicamente en [esta URL de https](https://animatediff.github.io/).*
## Pipelines disponibles
| Pipeline | Tareas | Demo
|---|---|:---:|
| [AnimateDiffPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py) | *Generación de texto a video con AnimateDiff* |
| [AnimateDiffControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py) | *Generación controlada de video a video con AnimateDiff usando ControlNet* |
| [AnimateDiffSparseControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py) | *Generación controlada de video a video con AnimateDiff usando SparseCtrl* |
| [AnimateDiffSDXLPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py) | *Generación de video a video con AnimateDiff* |
| [AnimateDiffVideoToVideoPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py) | *Generación de video a video con AnimateDiff* |
| [AnimateDiffVideoToVideoControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py) | *Generación de video a video con AnimateDiff usando ControlNet* |
## Puntos de control disponibles
Los puntos de control de Motion Adapter se pueden encontrar en [guoyww](https://huggingface.co/guoyww/). Estos puntos de control están diseñados para funcionar con cualquier modelo basado en Stable Diffusion 1.4/1.5.
## Ejemplo de uso
### AnimateDiffPipeline
AnimateDiff funciona con un checkpoint de MotionAdapter y un checkpoint de modelo de Stable Diffusion. MotionAdapter es una colección de Motion Modules que se encargan de añadir movimiento coherente entre los fotogramas de las imágenes. Estos módulos se aplican después de los bloques Resnet y Attention en el UNet de Stable Diffusion.
El siguiente ejemplo demuestra cómo usar un punto de control de *MotionAdapter* con Diffusers para la inferencia basada en StableDiffusion-1.4/1.5.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
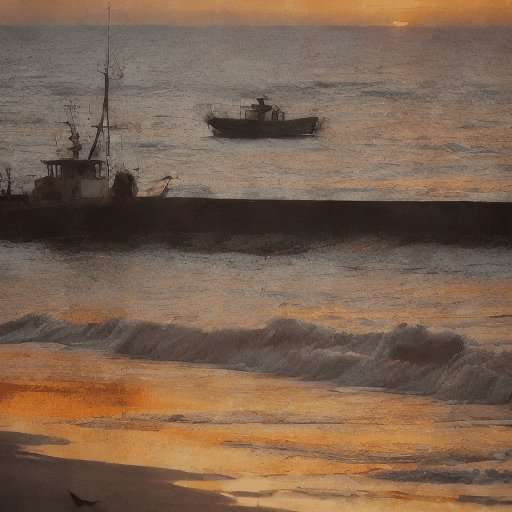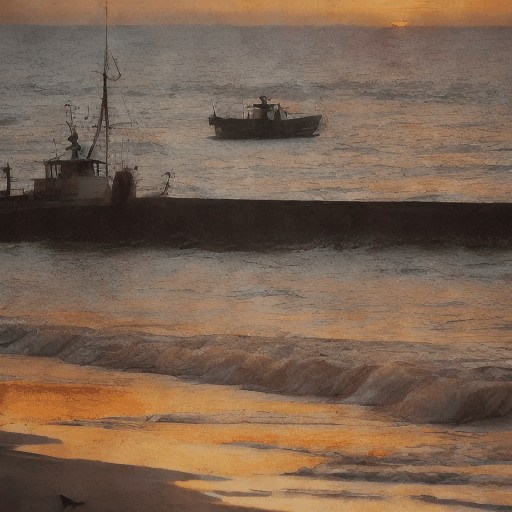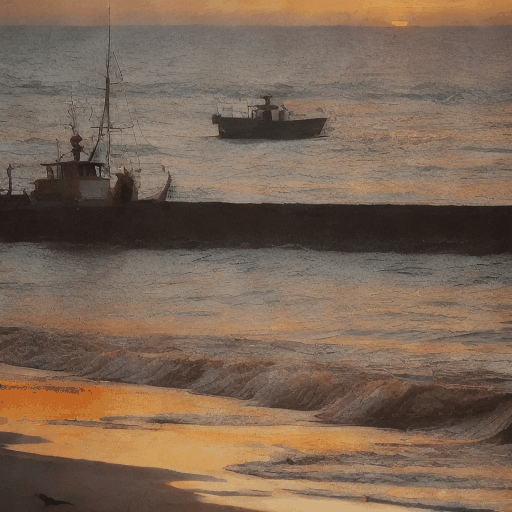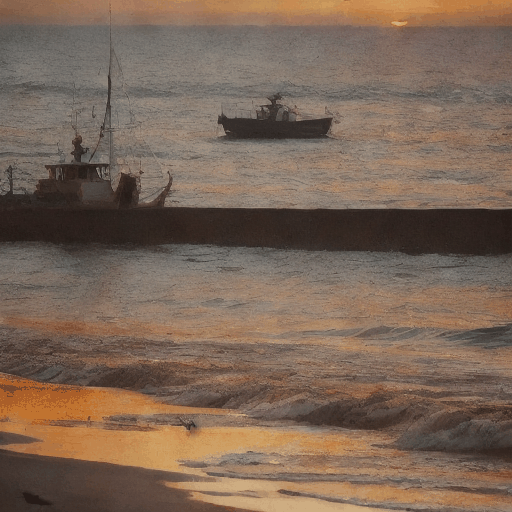
Aquí hay algunas salidas de ejemplo:
masterpiece, bestquality, sunset.
 > [!TIP]
> AnimateDiff suele funcionar mejor con modelos de Stable Diffusion afinados. Si planea usar un programador que pueda recortar muestras, asegúrese de desactivarlo estableciendo `clip_sample=False` en el programador, ya que esto también puede tener un efecto adverso en las muestras generadas. Además, los puntos de control de AnimateDiff pueden ser sensibles al programa beta del programador. Recomendamos establecerlo en `linear`.
### AnimateDiffControlNetPipeline
AnimateDiff también se puede usar con ControlNets. ControlNet se introdujo en [Adding Conditional Control to Text-to-Image Diffusion Models](https://huggingface.co/papers/2302.05543) por Lvmin Zhang, Anyi Rao y Maneesh Agrawala. Con un modelo de ControlNet, puedes proporcionar una imagen de control adicional para condicionar y controlar la generación de Stable Diffusion. Por ejemplo, si proporcionas mapas de profundidad, el modelo de ControlNet genera un video que preservará la información espacial de los mapas de profundidad. Es una forma más flexible y precisa de controlar el proceso de generación de video.
```python
import torch
from diffusers import AnimateDiffControlNetPipeline, AutoencoderKL, ControlNetModel, MotionAdapter, LCMScheduler
from diffusers.utils import export_to_gif, load_video
# Additionally, you will need a preprocess videos before they can be used with the ControlNet
# HF maintains just the right package for it: `pip install controlnet_aux`
from controlnet_aux.processor import ZoeDetector
# Download controlnets from https://huggingface.co/lllyasviel/ControlNet-v1-1 to use .from_single_file
# Download Diffusers-format controlnets, such as https://huggingface.co/lllyasviel/sd-controlnet-depth, to use .from_pretrained()
controlnet = ControlNetModel.from_single_file("control_v11f1p_sd15_depth.pth", dtype=torch.float16)
# We use AnimateLCM for this example but one can use the original motion adapters as well (for example, https://huggingface.co/guoyww/animatediff-motion-adapter-v1-5-3)
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=torch.float16)
pipe: AnimateDiffControlNetPipeline = AnimateDiffControlNetPipeline.from_pretrained(
"SG161222/Realistic_Vision_V5.1_noVAE",
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
).to(device="cuda", dtype=torch.float16) # or "mps", "xpu", "cpu"
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm-lora")
pipe.set_adapters(["lcm-lora"], [0.8])
depth_detector = ZoeDetector.from_pretrained("lllyasviel/Annotators").to("cuda")
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-vid2vid-input-1.gif")
conditioning_frames = []
with pipe.progress_bar(total=len(video)) as progress_bar:
for frame in video:
conditioning_frames.append(depth_detector(frame))
progress_bar.update()
prompt = "a panda, playing a guitar, sitting in a pink boat, in the ocean, mountains in background, realistic, high quality"
negative_prompt = "bad quality, worst quality"
video = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_frames=len(video),
num_inference_steps=10,
guidance_scale=2.0,
conditioning_frames=conditioning_frames,
generator=torch.Generator().manual_seed(42),
).frames[0]
export_to_gif(video, "animatediff_controlnet.gif", fps=8)
```
Aquí hay algunas salidas de ejemplo:
Video de origen Video de salida
mapache tocando la guitarra
un panda, tocando la guitarra, sentado en un bote rosa, en el océano, montañas al fondo, realista, alta calidad
### AnimateDiffSparseControlNetPipeline
[SparseCtrl: Adding Sparse Controls to Text-to-Video Diffusion Models](https://huggingface.co/papers/2311.16933) para lograr una generación controlada en modelos de difusión de texto a video, de Yuwei Guo, Ceyuan Yang, Anyi Rao, Maneesh Agrawala, Dahua Lin y Bo Dai.
El resumen del artículo es:
*El desarrollo de la generación de video a partir de texto (T2V), es decir, la creación de videos mediante un prompt de texto dado, ha avanzado significativamente en los últimos años. Sin embargo, depender exclusivamente de prompts de texto a menudo resulta en una composición de fotogramas ambigua debido a la incertidumbre espacial. La comunidad de investigación aprovecha así las señales estructurales densas, por ejemplo, secuencias de profundidad/bordes por fotograma, para mejorar la controlabilidad, lo cual aumenta la carga de inferencia. En este trabajo, presentamos SparseCtrl para habilitar un control estructural flexible con señales temporalmente dispersas, requiriendo solo una o pocas entradas, como se muestra en la Figura 1. Incorpora un codificador de condiciones adicional para procesar estas señales dispersas, manteniendo intacto el modelo T2V preentrenado. El enfoque propuesto es compatible con diversas modalidades, incluyendo bocetos, mapas de profundidad e imágenes RGB, lo que proporciona un control más práctico para la generación de video y promueve aplicaciones como el storyboarding, el renderizado de profundidad, la animación de fotogramas clave y la interpolación. Experimentos extensos demuestran la generalización de SparseCtrl en generadores T2V tanto originales como personalizados. El código y los modelos estarán disponibles públicamente en [esta URL de https](https://guoyww.github.io/projects/SparseCtrl).*
SparseCtrl introduce los siguientes puntos de control para la generación de texto a video controlada:
- [SparseCtrl Scribble](https://huggingface.co/guoyww/animatediff-sparsectrl-scribble)
- [SparseCtrl RGB](https://huggingface.co/guoyww/animatediff-sparsectrl-rgb)
#### Usando SparseCtrl Scribble
```python
import torch
from diffusers import AnimateDiffSparseControlNetPipeline
from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
from diffusers.schedulers import DPMSolverMultistepScheduler
from diffusers.utils import export_to_gif, load_image
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
controlnet_id = "guoyww/animatediff-sparsectrl-scribble"
lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
vae_id = "stabilityai/sd-vae-ft-mse"
device = "cuda" # or "mps", "xpu", "cpu"
motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, dtype=torch.float16).to(device)
controlnet = SparseControlNetModel.from_pretrained(controlnet_id, dtype=torch.float16).to(device)
vae = AutoencoderKL.from_pretrained(vae_id, dtype=torch.float16).to(device)
scheduler = DPMSolverMultistepScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
algorithm_type="dpmsolver++",
use_karras_sigmas=True,
)
pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
model_id,
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
scheduler=scheduler,
dtype=torch.float16,
).to(device)
pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
pipe.fuse_lora(lora_scale=1.0)
prompt = "an aerial view of a cyberpunk city, night time, neon lights, masterpiece, high quality"
negative_prompt = "low quality, worst quality, letterboxed"
image_files = [
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-1.png",
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-2.png",
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-3.png"
]
condition_frame_indices = [0, 8, 15]
conditioning_frames = [load_image(img_file) for img_file in image_files]
video = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_inference_steps=25,
conditioning_frames=conditioning_frames,
controlnet_conditioning_scale=1.0,
controlnet_frame_indices=condition_frame_indices,
generator=torch.Generator().manual_seed(1337),
).frames[0]
export_to_gif(video, "output.gif")
```
Aquí hay algunas salidas de ejemplo:
una vista aérea de una ciudad cyberpunk, de noche, luces de neón, obra maestra, alta calidad
#### Uso de SparseCtrl RGB
```python
import torch
from diffusers import AnimateDiffSparseControlNetPipeline
from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
from diffusers.schedulers import DPMSolverMultistepScheduler
from diffusers.utils import export_to_gif, load_image
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
controlnet_id = "guoyww/animatediff-sparsectrl-rgb"
lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
vae_id = "stabilityai/sd-vae-ft-mse"
device = "cuda" # or "mps", "xpu", "cpu"
motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, dtype=torch.float16).to(device)
controlnet = SparseControlNetModel.from_pretrained(controlnet_id, dtype=torch.float16).to(device)
vae = AutoencoderKL.from_pretrained(vae_id, dtype=torch.float16).to(device)
scheduler = DPMSolverMultistepScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
algorithm_type="dpmsolver++",
use_karras_sigmas=True,
)
pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
model_id,
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
scheduler=scheduler,
dtype=torch.float16,
).to(device)
pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-firework.png")
video = pipe(
prompt="closeup face photo of man in black clothes, night city street, bokeh, fireworks in background",
negative_prompt="low quality, worst quality",
num_inference_steps=25,
conditioning_frames=image,
controlnet_frame_indices=[0],
controlnet_conditioning_scale=1.0,
generator=torch.Generator().manual_seed(42),
).frames[0]
export_to_gif(video, "output.gif")
```
Aquí hay algunas salidas de ejemplo:
retrato de primer plano de un hombre con ropa negra, calle de ciudad de noche, bokeh, fuegos artificiales de fondo
### AnimateDiffSDXLPipeline
AnimateDiff también se puede usar con modelos SDXL. Esta es actualmente una función experimental, ya que solo está disponible una versión beta del checkpoint del adaptador de movimiento.
```python
import torch
from diffusers.models import MotionAdapter
from diffusers import AnimateDiffSDXLPipeline, DDIMScheduler
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-sdxl-beta", dtype=torch.float16)
model_id = "stabilityai/stable-diffusion-xl-base-1.0"
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe = AnimateDiffSDXLPipeline.from_pretrained(
model_id,
motion_adapter=adapter,
scheduler=scheduler,
dtype=torch.float16,
variant="fp16",
).to("cuda") # or "mps", "xpu", "cpu"
# enable memory savings
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()
output = pipe(
prompt="a panda surfing in the ocean, realistic, high quality",
negative_prompt="low quality, worst quality",
num_inference_steps=20,
guidance_scale=8,
width=1024,
height=1024,
num_frames=16,
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
### AnimateDiffVideoToVideoPipeline
AnimateDiff también se puede utilizar para generar videos visualmente similares o para habilitar ediciones de estilo, personaje, fondo u otros elementos a partir de un video inicial, lo que le permite explorar las posibilidades creativas de manera fluida.
```python
import imageio
import requests
import torch
from diffusers import AnimateDiffVideoToVideoPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
from io import BytesIO
from PIL import Image
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffVideoToVideoPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
# helper function to load videos
def load_video(file_path: str):
images = []
if file_path.startswith(('http://', 'https://')):
# If the file_path is a URL
response = requests.get(file_path)
response.raise_for_status()
content = BytesIO(response.content)
vid = imageio.get_reader(content)
else:
# Assuming it's a local file path
vid = imageio.get_reader(file_path)
for frame in vid:
pil_image = Image.fromarray(frame)
images.append(pil_image)
return images
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-vid2vid-input-1.gif")
output = pipe(
video = video,
prompt="panda playing a guitar, on a boat, in the ocean, high quality",
negative_prompt="bad quality, worse quality",
guidance_scale=7.5,
num_inference_steps=25,
strength=0.5,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
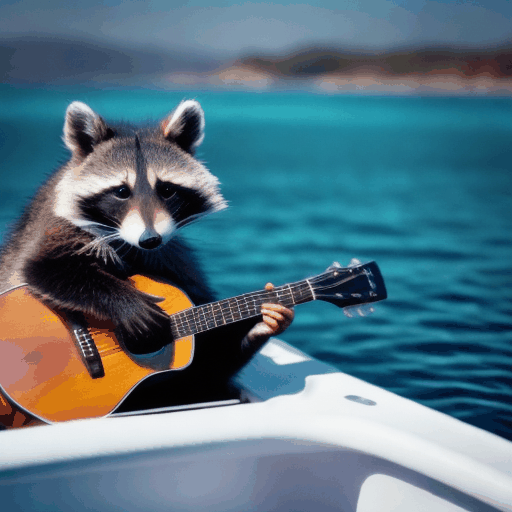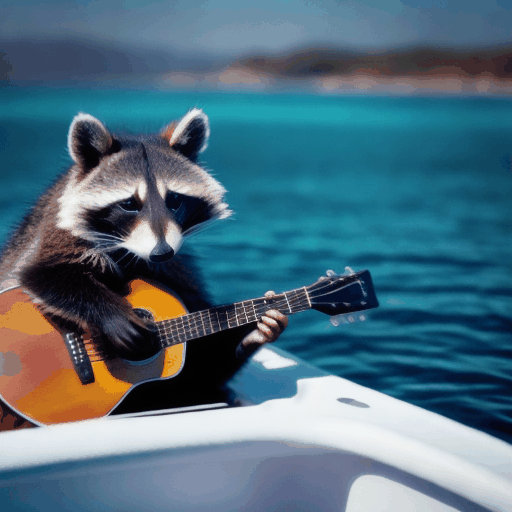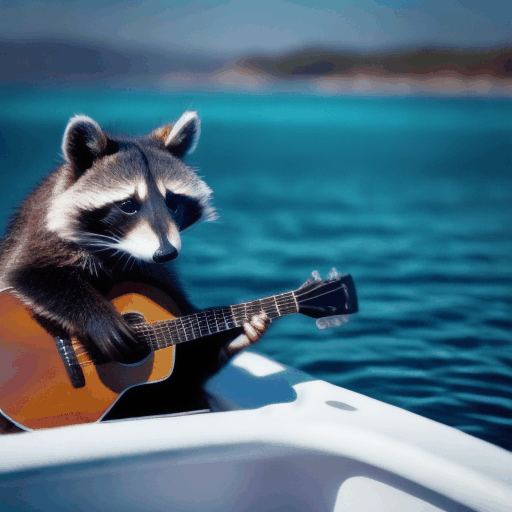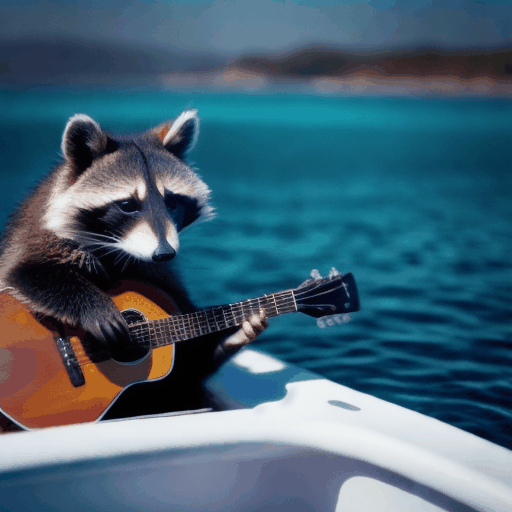
Aquí hay algunas salidas de ejemplo:
Video de origen Video de salida
mapache tocando la guitarra
 panda tocando la guitarra
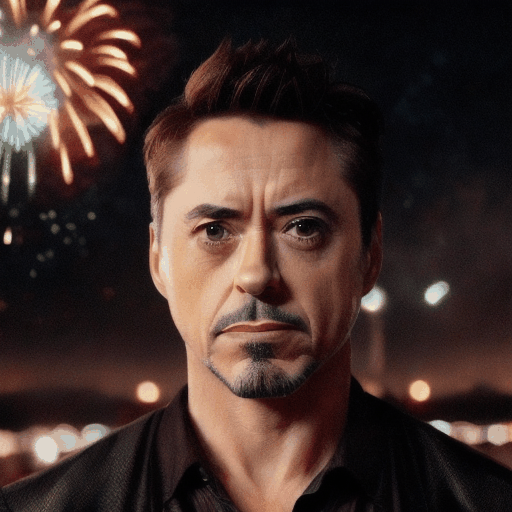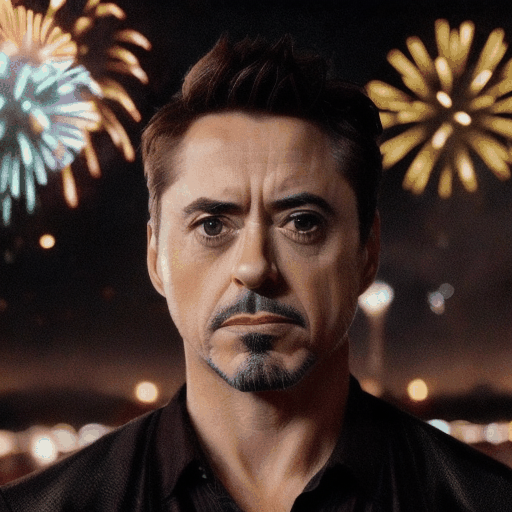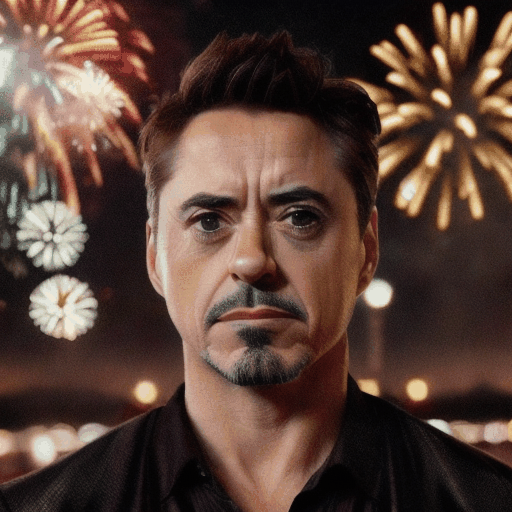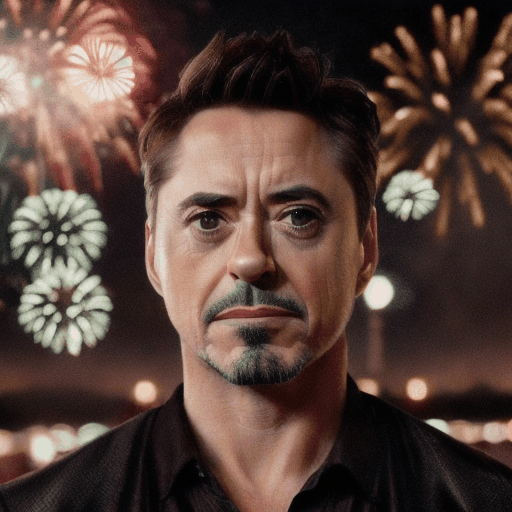
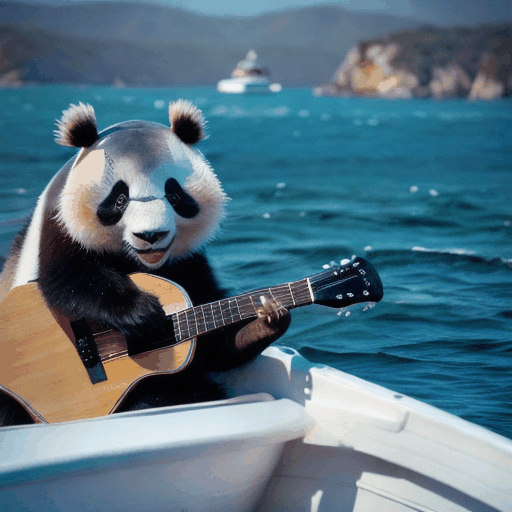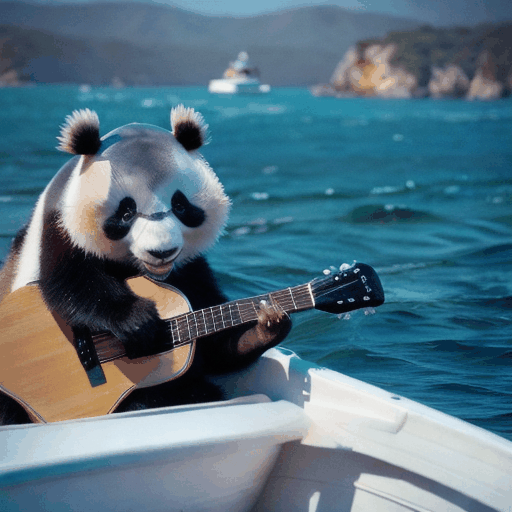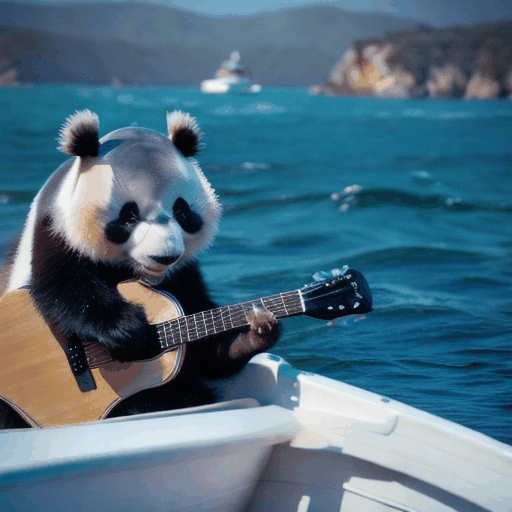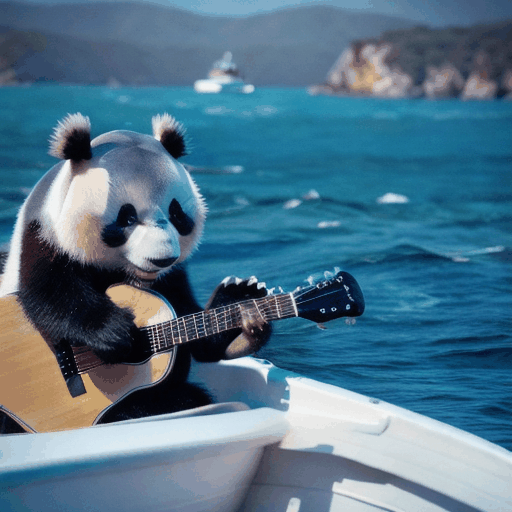 primer plano de Margot Robbie, fuegos artificiales de fondo, alta calidad
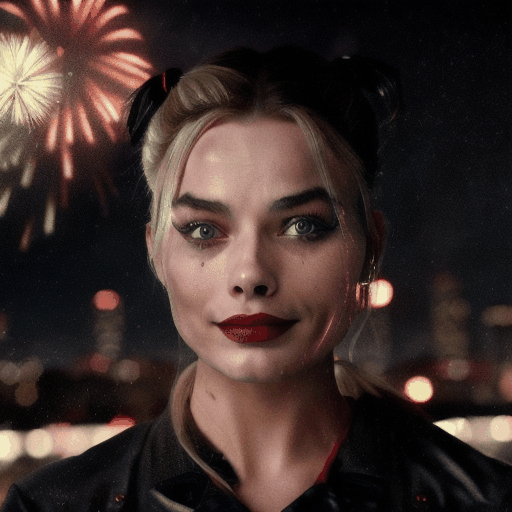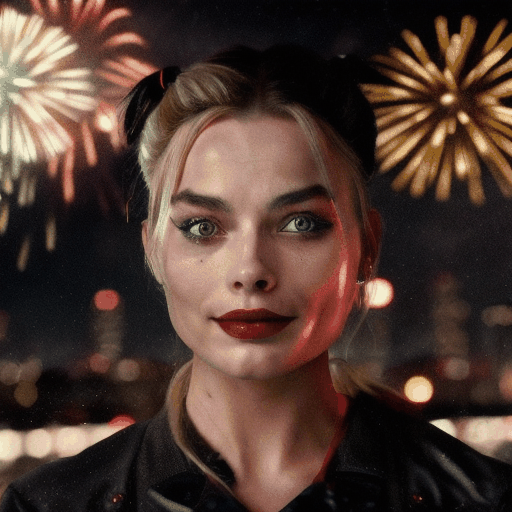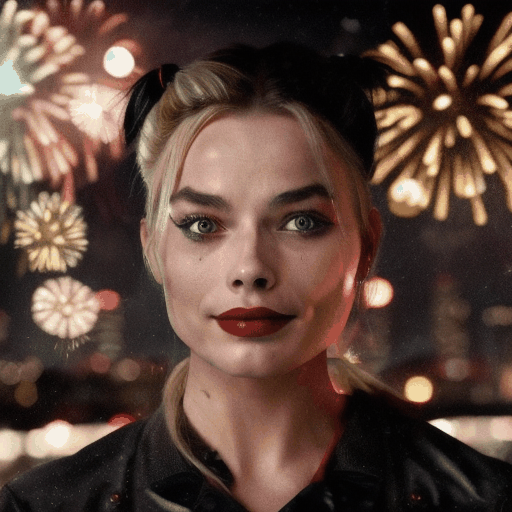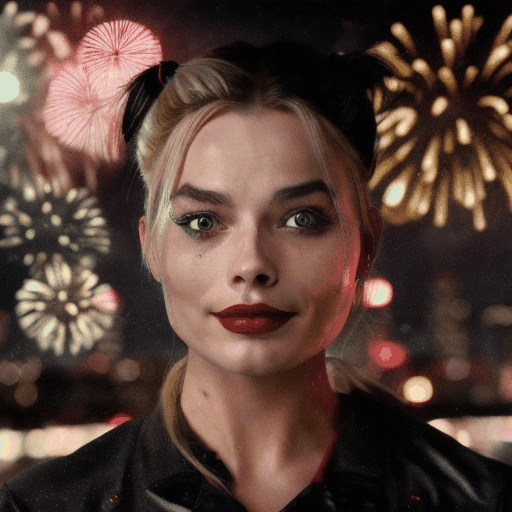 primer plano de Tony Stark, Robert Downey Jr, fuegos artificiales
 ### AnimateDiffVideoToVideoControlNetPipeline
AnimateDiff se puede utilizar junto con ControlNets para mejorar la generación de video a video, permitiendo un control preciso sobre la salida. ControlNet fue introducido en [Adding Conditional Control to Text-to-Image Diffusion Models](https://huggingface.co/papers/2302.05543) por Lvmin Zhang, Anyi Rao y Maneesh Agrawala, y permite condicionar Stable Diffusion con una imagen de control adicional para garantizar que la información espacial se preserve a lo largo del video.
Esta pipeline le permite condicionar su generación tanto en el video original como en una secuencia de imágenes de control.
```python
import torch
from PIL import Image
from tqdm.auto import tqdm
from controlnet_aux.processor import OpenposeDetector
from diffusers import AnimateDiffVideoToVideoControlNetPipeline
from diffusers.utils import export_to_gif, load_video
from diffusers import AutoencoderKL, ControlNetModel, MotionAdapter, LCMScheduler
# Load the ControlNet
controlnet = ControlNetModel.from_pretrained("lllyasviel/sd-controlnet-openpose", dtype=torch.float16)
# Load the motion adapter
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
# Load SD 1.5 based finetuned model
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=torch.float16)
pipe = AnimateDiffVideoToVideoControlNetPipeline.from_pretrained(
"SG161222/Realistic_Vision_V5.1_noVAE",
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
).to(device="cuda", dtype=torch.float16) # or "mps", "xpu", "cpu"
# Enable LCM to speed up inference
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm-lora")
pipe.set_adapters(["lcm-lora"], [0.8])
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/dance.gif")
video = [frame.convert("RGB") for frame in video]
prompt = "astronaut in space, dancing"
negative_prompt = "bad quality, worst quality, jpeg artifacts, ugly"
# Create controlnet preprocessor
open_pose = OpenposeDetector.from_pretrained("lllyasviel/Annotators").to("cuda")
# Preprocess controlnet images
conditioning_frames = []
for frame in tqdm(video):
conditioning_frames.append(open_pose(frame))
strength = 0.8
with torch.inference_mode():
video = pipe(
video=video,
prompt=prompt,
negative_prompt=negative_prompt,
num_inference_steps=10,
guidance_scale=2.0,
controlnet_conditioning_scale=0.75,
conditioning_frames=conditioning_frames,
strength=strength,
generator=torch.Generator().manual_seed(42),
).frames[0]
video = [frame.resize(conditioning_frames[0].size) for frame in video]
export_to_gif(video, f"animatediff_vid2vid_controlnet.gif", fps=8)
```
Aquí hay algunas salidas de ejemplo:
Video de origen Video de salida
chica de anime, bailando
astronauta en el espacio, bailando
**Las luces y la composición se transfirieron desde el Video de origen.**
## Uso de Motion LoRAs
Los Motion LoRAs son una colección de LoRAs que funcionan con el checkpoint `guoyww/animatediff-motion-adapter-v1-5-2`. Estos LoRAs se encargan de añadir tipos específicos de movimiento a las animaciones.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
pipe.load_lora_weights(
"guoyww/animatediff-motion-lora-zoom-out", adapter_name="zoom-out"
)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
beta_schedule="linear",
timestep_spacing="linspace",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
masterpiece, bestquality, sunset.
 ## Usar Motion LoRAs con PEFT
También puede aprovechar el backend [PEFT](https://github.com/huggingface/peft) para combinar Motion LoRA y crear animaciones más complejas.
Primero instala PEFT con
```shell
pip install peft
```
Luego, puede usar el siguiente código para combinar Motion LoRAs.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
pipe.load_lora_weights(
"diffusers/animatediff-motion-lora-zoom-out", adapter_name="zoom-out",
)
pipe.load_lora_weights(
"diffusers/animatediff-motion-lora-pan-left", adapter_name="pan-left",
)
pipe.set_adapters(["zoom-out", "pan-left"], adapter_weights=[1.0, 1.0])
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
masterpiece, bestquality, sunset.
 ## Uso de FreeInit
[FreeInit: Bridging Initialization Gap in Video Diffusion Models](https://huggingface.co/papers/2312.07537) de Tianxing Wu, Chenyang Si, Yuming Jiang, Ziqi Huang, Ziwei Liu.
FreeInit es un método eficaz que mejora la consistencia temporal y la calidad general de los videos generados con video-diffusion-models, sin necesidad de entrenamiento adicional. Puede aplicarse de manera fluida en tiempo de inferencia a AnimateDiff, ModelScope, VideoCrafter y diversos otros modelos de generación de video, y funciona refinando iterativamente el ruido de inicialización latente. Más detalles pueden encontrarse en el paper.
El siguiente ejemplo demuestra el uso de FreeInit.
```python
import torch
from diffusers import MotionAdapter, AnimateDiffPipeline, DDIMScheduler
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2")
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16).to("cuda") # or "mps", "xpu", "cpu"
pipe.scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
clip_sample=False,
timestep_spacing="linspace",
steps_offset=1
)
# enable memory savings
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()
# enable FreeInit
# Refer to the enable_free_init documentation for a full list of configurable parameters
pipe.enable_free_init(method="butterworth", use_fast_sampling=True)
# run inference
output = pipe(
prompt="a panda playing a guitar, on a boat, in the ocean, high quality",
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=20,
generator=torch.Generator("cpu").manual_seed(666),
)
# disable FreeInit
pipe.disable_free_init()
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
> [!WARNING]
> FreeInit no es realmente gratuito: la mejora en la calidad tiene un coste en términos de cómputo adicional. Requiere realizar varias muestras extra dependiendo del parámetro `num_iters` que se establece al activarlo. Establecer el parámetro `use_fast_sampling` en `True` puede mejorar el rendimiento general (a costa de una calidad inferior en comparación con `use_fast_sampling=False`, pero aún así ofrece mejores resultados que los modelos de generación de video estándar).
> [!TIP]
> Asegúrate de consultar la [guía de Schedulers](../../using-diffusers/schedulers) para aprender a explorar el equilibrio entre la velocidad y la calidad del scheduler, y consulta la sección [reutilizar componentes entre pipelines](../../using-diffusers/loading#reusing-models-in-multiple-pipelines) para aprender a cargar eficientemente los mismos componentes en múltiples pipelines.
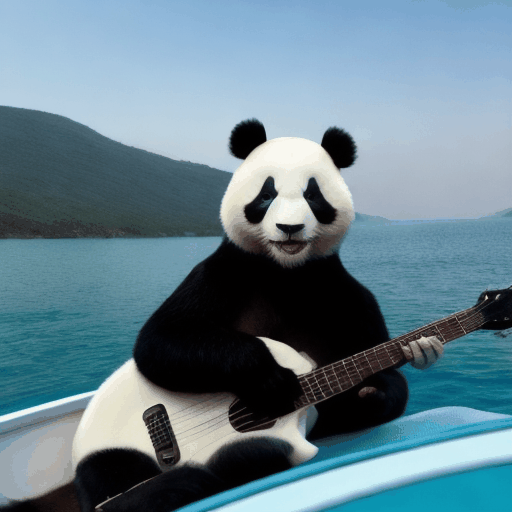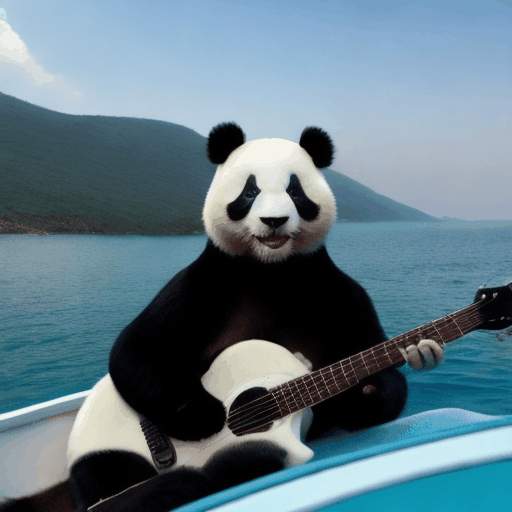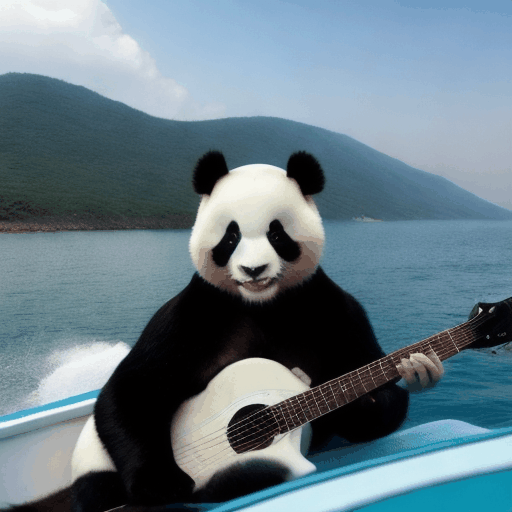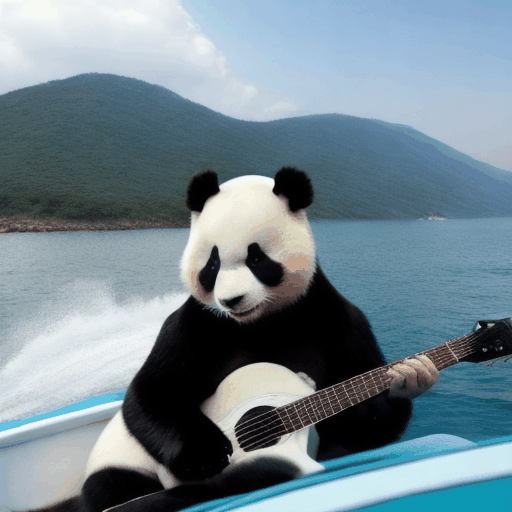
Sin FreeInit habilitado Con FreeInit habilitado
panda tocando la guitarra
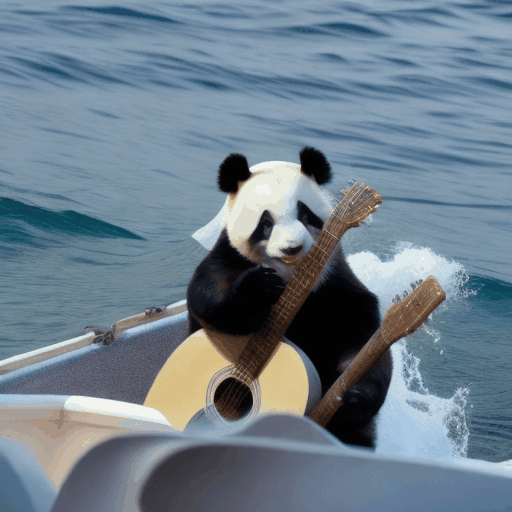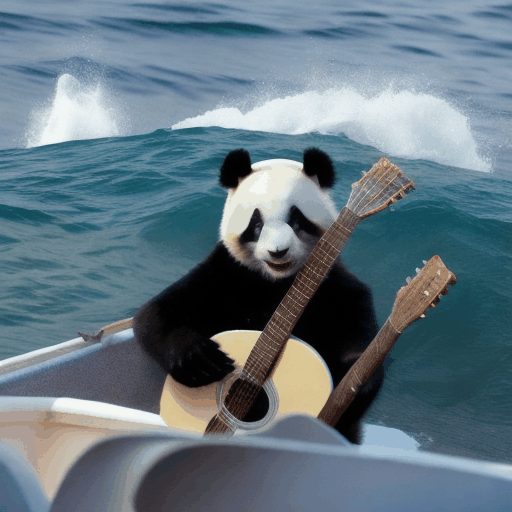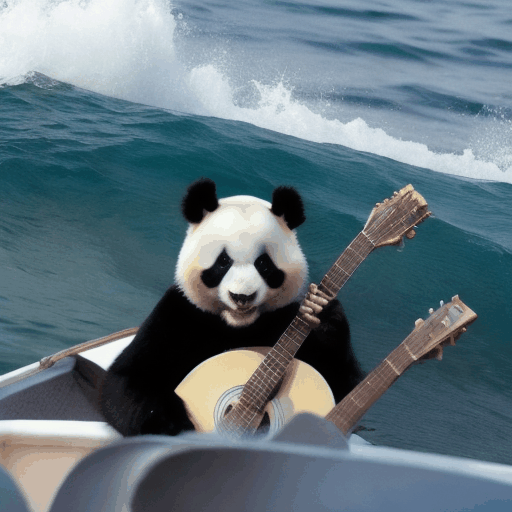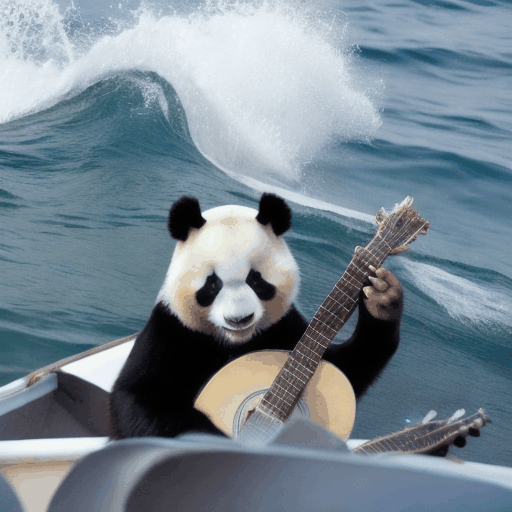 panda tocando la guitarra
 ## Uso de AnimateLCM
[AnimateLCM](https://animatelcm.github.io/) es un punto de control de módulo de movimiento y un [LCM LoRA](https://huggingface.co/docs/diffusers/using-diffusers/inference_with_lcm_lora) creados mediante una estrategia de aprendizaje de consistencia que desacopla la destilación de los a priori de generación de imágenes y los a priori de generación de movimiento.
```python
import torch
from diffusers import AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="sd15_lora_beta.safetensors", adapter_name="lcm-lora")
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt="A space rocket with trails of smoke behind it launching into space from the desert, 4k, high resolution",
negative_prompt="bad quality, worse quality, low resolution",
num_frames=16,
guidance_scale=1.5,
num_inference_steps=6,
generator=torch.Generator("cpu").manual_seed(0),
)
frames = output.frames[0]
export_to_gif(frames, "animatelcm.gif")
```
Un cohete espacial, 4K.
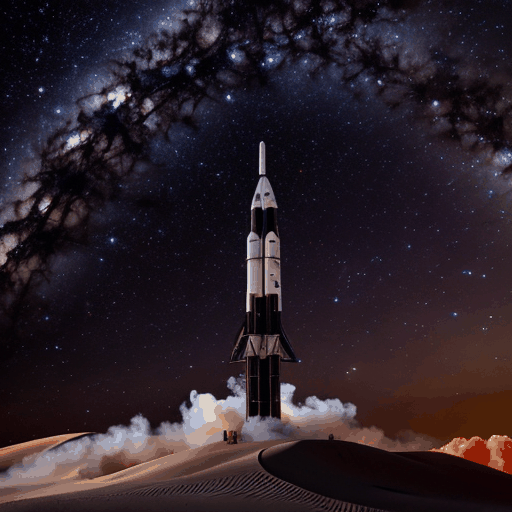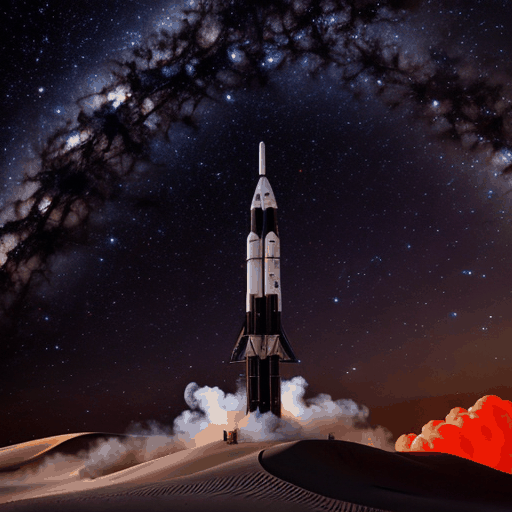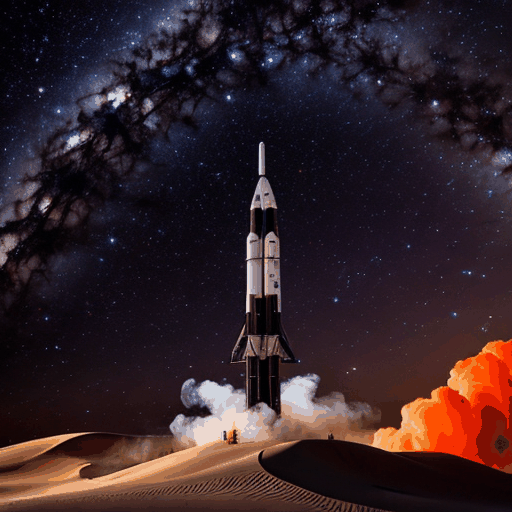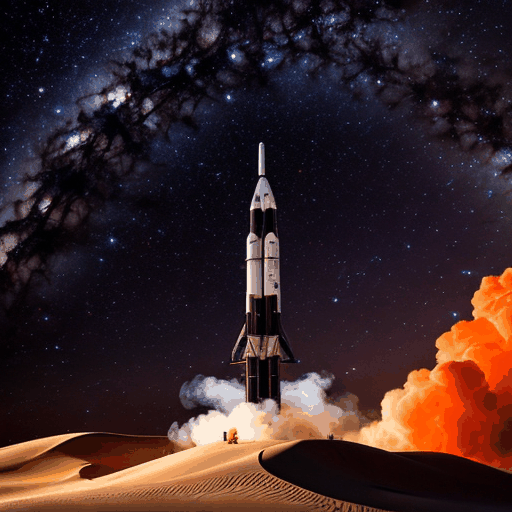 AnimateLCM también es compatible con los [Motion LoRAs](https://huggingface.co/collections/dn6/animatediff-motion-loras-654cb8ad732b9e3cf4d3c17e) existentes.
```python
import torch
from diffusers import AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="sd15_lora_beta.safetensors", adapter_name="lcm-lora")
pipe.load_lora_weights("guoyww/animatediff-motion-lora-tilt-up", adapter_name="tilt-up")
pipe.set_adapters(["lcm-lora", "tilt-up"], [1.0, 0.8])
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt="A space rocket with trails of smoke behind it launching into space from the desert, 4k, high resolution",
negative_prompt="bad quality, worse quality, low resolution",
num_frames=16,
guidance_scale=1.5,
num_inference_steps=6,
generator=torch.Generator("cpu").manual_seed(0),
)
frames = output.frames[0]
export_to_gif(frames, "animatelcm-motion-lora.gif")
```
Un cohete espacial, 4K.
 ## Uso de FreeNoise
[FreeNoise: Tuning-Free Longer Video Diffusion via Noise Rescheduling](https://huggingface.co/papers/2310.15169) de Haonan Qiu, Menghan Xia, Yong Zhang, Yingqing He, Xintao Wang, Ying Shan, Ziwei Liu.
FreeNoise es un mecanismo de muestreo que puede generar videos más largos con modelos de generación de videos cortos mediante el uso de reprogramación de ruido, atención temporal sobre ventanas deslizantes y promediado ponderado de marcos latentes. También se puede utilizar con múltiples prompts para permitir la generación de videos interpolados. Más detalles están disponibles en el paper.
Los pipelines de AnimateDiff actualmente compatibles que se pueden usar con FreeNoise son:
- [AnimateDiffPipeline](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.AnimateDiffPipeline)
- [AnimateDiffControlNetPipeline](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.AnimateDiffControlNetPipeline)
- [AnimateDiffVideoToVideoPipeline](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.AnimateDiffVideoToVideoPipeline)
- [AnimateDiffVideoToVideoControlNetPipeline](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.AnimateDiffVideoToVideoControlNetPipeline)
Para usar FreeNoise, se debe añadir una sola línea al código de inferencia después de cargar tus pipelines.
```diff
+ pipe.enable_free_noise()
```
Después de esto, se puede usar un único prompt o se pueden pasar varios prompts como un diccionario de pares de enteros y cadenas de texto. Las claves enteras del diccionario corresponden al índice de fotograma en el que la influencia de ese prompt sería máxima. Cada índice de fotograma debe mapear a un único prompt de cadena de texto. Los prompts para los índices de fotogramas intermedios, que no se pasan en el diccionario, se crean interpolando entre los prompts de fotogramas que sí se pasan. De forma predeterminada, se utiliza una interpolación lineal simple. Sin embargo, puedes personalizar este comportamiento con un callback en el parámetro `prompt_interpolation_callback` al habilitar FreeNoise.
Ejemplo completo:
```python
import torch
from diffusers import AutoencoderKL, AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_video, load_image
# Load pipeline
dtype = torch.float16
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM", dtype=dtype)
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=dtype)
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=motion_adapter, vae=vae, dtype=dtype)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights(
"wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm_lora"
)
pipe.set_adapters(["lcm_lora"], [0.8])
# Enable FreeNoise for long prompt generation
pipe.enable_free_noise(context_length=16, context_stride=4)
pipe.to("cuda") # or "mps", "xpu", "cpu"
# Can be a single prompt, or a dictionary with frame timesteps
prompt = {
0: "A caterpillar on a leaf, high quality, photorealistic",
40: "A caterpillar transforming into a cocoon, on a leaf, near flowers, photorealistic",
80: "A cocoon on a leaf, flowers in the background, photorealistic",
120: "A cocoon maturing and a butterfly being born, flowers and leaves visible in the background, photorealistic",
160: "A beautiful butterfly, vibrant colors, sitting on a leaf, flowers in the background, photorealistic",
200: "A beautiful butterfly, flying away in a forest, photorealistic",
240: "A cyberpunk butterfly, neon lights, glowing",
}
negative_prompt = "bad quality, worst quality, jpeg artifacts"
# Run inference
output = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_frames=256,
guidance_scale=2.5,
num_inference_steps=10,
generator=torch.Generator("cpu").manual_seed(0),
)
# Save video
frames = output.frames[0]
export_to_video(frames, "output.mp4", fps=16)
```
### Ahorro de memoria de FreeNoise
Dado que FreeNoise procesa varios fotogramas de forma conjunta, hay partes del modelado en las que la memoria requerida supera la disponible en las GPU de consumo habituales. Los principales cuellos de botella de memoria que identificamos son los bloques de atención espacial y temporal, los bloques de remuestreo ascendente y descendente, los bloques resnet y las capas feed-forward. Dado que la mayoría de estos bloques operan de forma efectiva solo en la dimensión de canal/embedding, se puede realizar una inferencia por lotes (chunked inference) a través de las dimensiones de batch. La dimensión de batch en AnimateDiff es de naturaleza espacial (`[B x F, H x W, C]`) o temporal (`B x H x W, F, C`) (ten en cuenta que puede parecer contraintuitivo, pero la dimensión de batch aquí es correcta, ya que los bloques espaciales procesan a través de la dimensión `B x F` mientras que los bloques temporales procesan a través de la dimensión `B x H x W`). Introducimos un `SplitInferenceModule` que facilita realizar chunking a través de cualquier dimensión y ejecutar la inferencia. Esto ahorra mucha memoria, pero a costa de requerir más tiempo para la inferencia.
```diff
# Load pipeline and adapters
# ...
+ pipe.enable_free_noise_split_inference()
+ pipe.unet.enable_forward_chunking(16)
```
La llamada al método `pipe.enable_free_noise_split_inference` acepta dos parámetros: `spatial_split_size` (con un valor predeterminado de `256`) y `temporal_split_size` (con un valor predeterminado de `16`). Estos se pueden configurar en función de la cantidad de VRAM disponible. Un tamaño de división más bajo resulta en un menor uso de memoria pero en una inferencia más lenta, mientras que un tamaño de división más grande resulta en una inferencia más rápida a costa de más memoria.
## Usar `from_single_file` con MotionAdapter
`diffusers>=0.30.0` permite cargar los checkpoints de AnimateDiff en el `MotionAdapter` en su formato original mediante `from_single_file`
```python
from diffusers import MotionAdapter
ckpt_path = "https://huggingface.co/Lightricks/LongAnimateDiff/blob/main/lt_long_mm_32_frames.ckpt"
adapter = MotionAdapter.from_single_file(ckpt_path, dtype=torch.float16)
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
```
## AnimateDiffPipeline[[diffusers.AnimateDiffPipeline]]
#### diffusers.AnimateDiffPipeline[[diffusers.AnimateDiffPipeline]]
```python
diffusers.AnimateDiffPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L78)
**Parámetros:**
vae ([AutoencoderKL](/docs/diffusers/main/es/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Modelo de Variational Auto-Encoder (VAE) para codificar y decodificar imágenes hacia y desde representaciones latentes.
text_encoder (`CLIPTextModel`) : Codificador de texto congelado ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Un [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) para tokenizar texto.
unet ([UNet2DConditionModel](/docs/diffusers/main/es/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Un [UNet2DConditionModel](/docs/diffusers/main/es/api/models/unet2d-cond#diffusers.UNet2DConditionModel) utilizado para crear un UNetMotionModel que desruidice los latentes de video codificados.
motion_adapter (`MotionAdapter`) : Un `MotionAdapter` para usar en combinación con `unet` para desruidar los latentes de video codificados.
scheduler ([SchedulerMixin](/docs/diffusers/main/es/api/schedulers/overview#diffusers.SchedulerMixin)) : Un scheduler para usar en combinación con `unet` para desruidar los latentes de la imagen codificada. Puede ser uno de [DDIMScheduler](/docs/diffusers/main/es/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/es/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) o [PNDMScheduler](/docs/diffusers/main/es/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline para la generación de texto a video.
Este modelo hereda de [DiffusionPipeline](/docs/diffusers/main/es/api/pipelines/overview#diffusers.DiffusionPipeline). Consulta la documentación de la clase superior para los métodos genéricos implementados en todas las tuberías (descarga, guardado, ejecución en un dispositivo específico, etc.).
El pipeline también hereda los siguientes métodos de carga:
- [load_textual_inversion()](/docs/diffusers/main/es/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) para cargar incrustaciones de inversión textual
- [load_lora_weights()](/docs/diffusers/main/es/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) para cargar los pesos de LoRA
- [save_lora_weights()](/docs/diffusers/main/es/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) para guardar los pesos de LoRA
- [load_ip_adapter()](/docs/diffusers/main/es/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) para cargar IP Adapters
#### __call__[[diffusers.AnimateDiffPipeline.__call__]]
```python
__call__(prompt: str | list[str] | None = None, num_frames: int | None = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'], decode_chunk_size: int = 16, **kwargs)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L571)
**Parámetros:**
prompt (`str` o `list[str]`, *opcional*) : El prompt o los prompts para guiar la generación de imágenes. Si no se define, debe pasar `prompt_embeds`.
height (`int`, *opcional*, valor predeterminado `self.unet.config.sample_size * self.vae_scale_factor`) : La altura en píxeles del video generado.
width (`int`, *opcional*, valor predeterminado `self.unet.config.sample_size * self.vae_scale_factor`) : El ancho en píxeles del video generado.
num_frames (`int`, *opcional*, valor predeterminado 16) : El número de fotogramas de video que se generan. El valor predeterminado es de 16 fotogramas, lo que a 8 fotogramas por segundo equivale a 2 segundos de video.
num_inference_steps (`int`, *opcional*, valor predeterminado 50) : El número de pasos de desruido. Más pasos de desruido suelen conducir a videos de mayor calidad a costa de una inferencia más lenta.
guidance_scale (`float`, *opcional*, valor predeterminado 7.5) : Un valor más alto de la escala de guía anima al modelo a generar imágenes estrechamente vinculadas al `prompt` de texto a costa de una menor calidad de imagen. La escala de guía se habilita cuando `guidance_scale > 1`.
negative_prompt (`str` o `list[str]`, *opcional*) : El prompt o los prompts para guiar lo que no debe incluirse en la generación de la imagen. Si no se define, debe pasar `negative_prompt_embeds` en su lugar. Se ignora cuando no se usa guía (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opcional*, valor predeterminado 1) : El número de videos a generar por indicación.
eta (`float`, *opcional*, valor predeterminado 0.0) : Corresponde al parámetro eta (η) del artículo [DDIM](https://huggingface.co/papers/2010.02502). Solo se aplica al [DDIMScheduler](/docs/diffusers/main/es/api/schedulers/ddim#diffusers.DDIMScheduler) y se ignora en otros programadores.
generator (`torch.Generator` o `list[torch.Generator]`, *opcional*) : Un [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) para hacer la generación determinista.
latents (`torch.Tensor`, *opcional*) : Latentes ruidosos pregenerados muestreados de una distribución gaussiana, para usarse como entradas para la generación de video. Se pueden usar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se genera un tensor de latentes mediante muestreo usando el `generator` aleatorio suministrado. Los latentes deben tener la forma `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opcional*) : Incrustaciones de texto pregeneradas. Se pueden usar para ajustar fácilmente las entradas de texto (ponderación del prompt). Si no se proporcionan, las incrustaciones de texto se generan a partir del argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pregenerados. Se pueden usar para ajustar fácilmente las entradas de texto (ponderación del prompt). Si no se proporcionan, `negative_prompt_embeds` se generan a partir del argumento de entrada `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opcional*): Entrada de imagen opcional para trabajar con IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opcional*) : Incrustaciones de imagen pregeneradas para IP-Adapter. Debe ser una lista de la misma longitud que el número de IP-adapters. Cada elemento debe ser un tensor de forma `(batch_size, num_images, emb_dim)`. Debe contener la incrustación de imagen negativa si `do_classifier_free_guidance` está establecido en `True`. Si no se proporciona, las incrustaciones se calculan a partir del argumento de entrada `ip_adapter_image`.
output_type (`str`, *opcional*, por defecto `"pil"`) : El formato de salida del video generado. Elija entre `torch.Tensor`, `PIL.Image` o `np.array`.
return_dict (`bool`, *opcional*, valor predeterminado `True`) : Indica si se debe devolver un `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` en lugar de una tupla simple.
cross_attention_kwargs (`dict`, *opcional*) : Un diccionario de kwargs que, si se especifica, se pasa al `AttentionProcessor` tal como se define en [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
clip_skip (`int`, *opcional*) : Número de capas que se omitirán de CLIP al calcular los embeddings del prompt. Un valor de 1 significa que se utilizará la salida de la capa previa a la final para calcular los embeddings del prompt.
callback_on_step_end (`Callable`, *opcional*) : Una función que se llama al final de cada paso de desruido durante la inferencia. La función se llama con los siguientes argumentos: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` incluirá una lista de todos los tensores especificados por `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opcional*) : La lista de entradas de tensor para la función `callback_on_step_end`. Los tensores especificados en la lista se pasarán como argumento `callback_kwargs`. Solo podrá incluir variables enumeradas en el atributo `._callback_tensor_inputs` de su clase de pipeline.
decode_chunk_size (`int`, por defecto `16`) : El número de fotogramas a decodificar a la vez al llamar al método `decode_latents`.
**Devuelve:** [AnimateDiffPipelineOutput](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) o `tuple`
Si `return_dict` es `True`, se devuelve [AnimateDiffPipelineOutput](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput); en caso contrario, se devuelve una `tuple` cuyo primer elemento es una lista con los fotogramas generados.
La función de llamada para el pipeline de generación.
Ejemplos:
```py
>>> import torch
>>> from diffusers import MotionAdapter, AnimateDiffPipeline, DDIMScheduler
>>> from diffusers.utils import export_to_gif
>>> adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2")
>>> pipe = AnimateDiffPipeline.from_pretrained("frankjoshua/toonyou_beta6", motion_adapter=adapter)
>>> pipe.scheduler = DDIMScheduler(beta_schedule="linear", steps_offset=1, clip_sample=False)
>>> output = pipe(prompt="A corgi walking in the park")
>>> frames = output.frames[0]
>>> export_to_gif(frames, "animation.gif")
```
#### encode_prompt[[diffusers.AnimateDiffPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L154)
**Parámetros:**
prompt (`str` o `list[str]`, *opcional*) : prompt a codificar
device : (`torch.device`): dispositivo de torch
num_images_per_prompt (`int`) : número de imágenes que deben generarse por prompt
do_classifier_free_guidance (`bool`) : si se debe usar o no la guía libre de clasificador
negative_prompt (`str` o `list[str]`, *opcional*) : El prompt o prompts que no deben guiar la generación de la imagen. Si no se define, se debe pasar `negative_prompt_embeds` en su lugar. Se ignora cuando no se usa guía (es decir, se ignora si `guidance_scale` es menor que `1`).
prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto pregenerados. Se pueden usar para ajustar fácilmente las entradas de texto, *p. ej.* ponderación de prompts. Si no se proporcionan, los embeddings de texto se generarán a partir del argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pregenerados. Se pueden utilizar para ajustar fácilmente las entradas de texto, *p. ej.* el ponderado de prompts. Si no se proporcionan, negative_prompt_embeds se generará a partir del argumento de entrada `negative_prompt`.
lora_scale (`float`, *opcional*) : Una escala LoRA que se aplicará a todas las capas LoRA del codificador de texto si se cargan capas LoRA.
clip_skip (`int`, *opcional*) : Número de capas que se omitirán de CLIP al calcular los embeddings del prompt. Un valor de 1 significa que se utilizará la salida de la capa previa a la final para calcular los embeddings del prompt.
Codifica el prompt en estados ocultos del codificador de texto.
## AnimateDiffControlNetPipeline[[diffusers.AnimateDiffControlNetPipeline]]
#### diffusers.AnimateDiffControlNetPipeline[[diffusers.AnimateDiffControlNetPipeline]]
```python
diffusers.AnimateDiffControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: diffusers.models.controlnets.controlnet.ControlNetModel | list[diffusers.models.controlnets.controlnet.ControlNetModel] | tuple[diffusers.models.controlnets.controlnet.ControlNetModel] | diffusers.models.controlnets.multicontrolnet.MultiControlNetModel, scheduler: KarrasDiffusionSchedulers, feature_extractor: transformers.models.clip.image_processing_pil_clip.CLIPImageProcessorPil | None = None, image_encoder: transformers.models.clip.modeling_clip.CLIPVisionModelWithProjection | None = None)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L120)
**Parámetros:**
vae ([AutoencoderKL](/docs/diffusers/main/es/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Modelo de Variational Auto-Encoder (VAE) para codificar y decodificar imágenes hacia y desde representaciones latentes.
text_encoder (`CLIPTextModel`) : Codificador de texto congelado ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Un [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) para tokenizar texto.
unet ([UNet2DConditionModel](/docs/diffusers/main/es/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Un [UNet2DConditionModel](/docs/diffusers/main/es/api/models/unet2d-cond#diffusers.UNet2DConditionModel) utilizado para crear un UNetMotionModel que desruidice los latentes de video codificados.
motion_adapter (`MotionAdapter`) : Un `MotionAdapter` para usar en combinación con `unet` para desruidar los latentes de video codificados.
scheduler ([SchedulerMixin](/docs/diffusers/main/es/api/schedulers/overview#diffusers.SchedulerMixin)) : Un scheduler para usar en combinación con `unet` para desruidar los latentes de la imagen codificada. Puede ser uno de [DDIMScheduler](/docs/diffusers/main/es/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/es/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) o [PNDMScheduler](/docs/diffusers/main/es/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline para la generación de texto a video con guía de ControlNet.
Este modelo hereda de [DiffusionPipeline](/docs/diffusers/main/es/api/pipelines/overview#diffusers.DiffusionPipeline). Consulta la documentación de la clase superior para los métodos genéricos implementados en todas las tuberías (descarga, guardado, ejecución en un dispositivo específico, etc.).
El pipeline también hereda los siguientes métodos de carga:
- [load_textual_inversion()](/docs/diffusers/main/es/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) para cargar incrustaciones de inversión textual
- [load_lora_weights()](/docs/diffusers/main/es/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) para cargar los pesos de LoRA
- [save_lora_weights()](/docs/diffusers/main/es/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) para guardar los pesos de LoRA
- [load_ip_adapter()](/docs/diffusers/main/es/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) para cargar IP Adapters
#### __call__[[diffusers.AnimateDiffControlNetPipeline.__call__]]
```python
__call__(prompt: str | list[str] = None, num_frames: int | None = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, guess_mode: bool = False, control_guidance_start: float | list[float] = 0.0, control_guidance_end: float | list[float] = 1.0, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'], decode_chunk_size: int = 16)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L721)
**Parámetros:**
prompt (`str` o `list[str]`, *opcional*) : El prompt o los prompts para guiar la generación de imágenes. Si no se define, debe pasar `prompt_embeds`.
height (`int`, *opcional*, valor predeterminado `self.unet.config.sample_size * self.vae_scale_factor`) : La altura en píxeles del video generado.
width (`int`, *opcional*, valor predeterminado `self.unet.config.sample_size * self.vae_scale_factor`) : El ancho en píxeles del video generado.
num_frames (`int`, *opcional*, valor predeterminado 16) : El número de fotogramas de video que se generan. El valor predeterminado es de 16 fotogramas, lo que a 8 fotogramas por segundo equivale a 2 segundos de video.
num_inference_steps (`int`, *opcional*, valor predeterminado 50) : El número de pasos de desruido. Más pasos de desruido suelen conducir a videos de mayor calidad a costa de una inferencia más lenta.
guidance_scale (`float`, *opcional*, valor predeterminado 7.5) : Un valor más alto de la escala de guía anima al modelo a generar imágenes estrechamente vinculadas al `prompt` de texto a costa de una menor calidad de imagen. La escala de guía se habilita cuando `guidance_scale > 1`.
negative_prompt (`str` o `list[str]`, *opcional*) : El prompt o los prompts para guiar lo que no debe incluirse en la generación de la imagen. Si no se define, debe pasar `negative_prompt_embeds` en su lugar. Se ignora cuando no se usa guía (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opcional*, valor predeterminado 1) : El número de videos a generar por indicación.
eta (`float`, *opcional*, valor predeterminado 0.0) : Corresponde al parámetro eta (η) del artículo [DDIM](https://huggingface.co/papers/2010.02502). Solo se aplica al [DDIMScheduler](/docs/diffusers/main/es/api/schedulers/ddim#diffusers.DDIMScheduler) y se ignora en otros programadores.
generator (`torch.Generator` o `list[torch.Generator]`, *opcional*) : Un [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) para hacer la generación determinista.
latents (`torch.Tensor`, *opcional*) : Latentes ruidosos pregenerados muestreados de una distribución gaussiana, para usarse como entradas para la generación de video. Se pueden usar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se genera un tensor de latentes mediante muestreo usando el `generator` aleatorio suministrado. Los latentes deben tener la forma `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opcional*) : Incrustaciones de texto pregeneradas. Se pueden usar para ajustar fácilmente las entradas de texto (ponderación del prompt). Si no se proporcionan, las incrustaciones de texto se generan a partir del argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pregenerados. Se pueden usar para ajustar fácilmente las entradas de texto (ponderación del prompt). Si no se proporcionan, `negative_prompt_embeds` se generan a partir del argumento de entrada `negative_prompt`.
ip_adapter_image (`PipelineImageInput`, *opcional*) : Entrada de imagen opcional para trabajar con IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opcional*) : Incrustaciones de imagen pregeneradas para IP-Adapter. Debe ser una lista de la misma longitud que el número de IP-adapters. Cada elemento debe ser un tensor de forma `(batch_size, num_images, emb_dim)`. Debe contener la incrustación de imagen negativa si `do_classifier_free_guidance` está establecido en `True`. Si no se proporciona, las incrustaciones se calculan a partir del argumento de entrada `ip_adapter_image`.
conditioning_frames (`list[PipelineImageInput]`, *opcional*) : La condición de entrada de ControlNet para proporcionar orientación a la `unet` durante la generación. Si se especifican varios ControlNets, las imágenes deben pasarse como una lista para que cada elemento de la lista pueda agruparse correctamente como entrada para un solo ControlNet.
output_type (`str`, *opcional*, por defecto `"pil"`) : El formato de salida del video generado. Elija entre `torch.Tensor`, `PIL.Image` o `np.array`.
return_dict (`bool`, *opcional*, valor predeterminado `True`) : Indica si se debe devolver un `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` en lugar de una tupla simple.
cross_attention_kwargs (`dict`, *opcional*) : Un diccionario de kwargs que, si se especifica, se pasa al `AttentionProcessor` tal como se define en [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
controlnet_conditioning_scale (`float` o `list[float]`, *opcional*, valor predeterminado 1.0) : Las salidas del ControlNet se multiplican por `controlnet_conditioning_scale` antes de sumarse al residual en el `unet` original. Si se especifican varios ControlNets en `init`, puedes establecer la escala correspondiente como una lista.
guess_mode (`bool`, *opcional*, valor predeterminado `False`) : El codificador de ControlNet intenta reconocer el contenido de la imagen de entrada incluso si eliminas todos los prompts. Se recomienda un valor de `guidance_scale` entre 3.0 y 5.0.
control_guidance_start (`float` o `list[float]`, *opcional*, valor predeterminado 0.0) : El porcentaje de pasos totales en el que ControlNet comienza a aplicarse.
control_guidance_end (`float` o `list[float]`, *opcional*, valor predeterminado 1.0) : El porcentaje de pasos totales en el que ControlNet deja de aplicarse.
clip_skip (`int`, *opcional*) : Número de capas que se omitirán de CLIP al calcular los embeddings del prompt. Un valor de 1 significa que se utilizará la salida de la capa previa a la final para calcular los embeddings del prompt.
callback_on_step_end (`Callable`, *opcional*) : Una función que se llama al final de cada paso de desruido durante la inferencia. La función se llama con los siguientes argumentos: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` incluirá una lista de todos los tensores especificados por `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opcional*) : La lista de entradas de tensor para la función `callback_on_step_end`. Los tensores especificados en la lista se pasarán como argumento `callback_kwargs`. Solo podrá incluir variables enumeradas en el atributo `._callback_tensor_inputs` de su clase de pipeline.
decode_chunk_size (`int`, por defecto `16`) : El número de fotogramas a decodificar a la vez al llamar al método `decode_latents`.
**Devuelve:** [AnimateDiffPipelineOutput](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) o `tuple`
Si `return_dict` es `True`, se devuelve [AnimateDiffPipelineOutput](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput); en caso contrario, se devuelve una `tuple` cuyo primer elemento es una lista con los fotogramas generados.
La función de llamada para el pipeline de generación.
Ejemplos:
#### encode_prompt[[diffusers.AnimateDiffControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L199)
**Parámetros:**
prompt (`str` o `list[str]`, *opcional*) : prompt a codificar
device : (`torch.device`): dispositivo de torch
num_images_per_prompt (`int`) : número de imágenes que deben generarse por prompt
do_classifier_free_guidance (`bool`) : si se debe usar o no la guía libre de clasificador
negative_prompt (`str` o `list[str]`, *opcional*) : El prompt o prompts que no deben guiar la generación de la imagen. Si no se define, se debe pasar `negative_prompt_embeds` en su lugar. Se ignora cuando no se usa guía (es decir, se ignora si `guidance_scale` es menor que `1`).
prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto pregenerados. Se pueden usar para ajustar fácilmente las entradas de texto, *p. ej.* ponderación de prompts. Si no se proporcionan, los embeddings de texto se generarán a partir del argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pregenerados. Se pueden utilizar para ajustar fácilmente las entradas de texto, *p. ej.* el ponderado de prompts. Si no se proporcionan, negative_prompt_embeds se generará a partir del argumento de entrada `negative_prompt`.
lora_scale (`float`, *opcional*) : Una escala LoRA que se aplicará a todas las capas LoRA del codificador de texto si se cargan capas LoRA.
clip_skip (`int`, *opcional*) : Número de capas que se omitirán de CLIP al calcular los embeddings del prompt. Un valor de 1 significa que se utilizará la salida de la capa previa a la final para calcular los embeddings del prompt.
Codifica el prompt en estados ocultos del codificador de texto.
## AnimateDiffSparseControlNetPipeline[[diffusers.AnimateDiffSparseControlNetPipeline]]
#### diffusers.AnimateDiffSparseControlNetPipeline[[diffusers.AnimateDiffSparseControlNetPipeline]]
```python
diffusers.AnimateDiffSparseControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: SparseControlNetModel, scheduler: KarrasDiffusionSchedulers, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L132)
**Parámetros:**
vae ([AutoencoderKL](/docs/diffusers/main/es/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Modelo de Variational Auto-Encoder (VAE) para codificar y decodificar imágenes hacia y desde representaciones latentes.
text_encoder (`CLIPTextModel`) : Codificador de texto congelado ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Un [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) para tokenizar texto.
unet ([UNet2DConditionModel](/docs/diffusers/main/es/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Un [UNet2DConditionModel](/docs/diffusers/main/es/api/models/unet2d-cond#diffusers.UNet2DConditionModel) utilizado para crear un UNetMotionModel que desruidice los latentes de video codificados.
motion_adapter (`MotionAdapter`) : Un `MotionAdapter` para usar en combinación con `unet` para desruidar los latentes de video codificados.
scheduler ([SchedulerMixin](/docs/diffusers/main/es/api/schedulers/overview#diffusers.SchedulerMixin)) : Un scheduler para usar en combinación con `unet` para desruidar los latentes de la imagen codificada. Puede ser uno de [DDIMScheduler](/docs/diffusers/main/es/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/es/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) o [PNDMScheduler](/docs/diffusers/main/es/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline para la generación controlada de texto a video utilizando el método descrito en [SparseCtrl: Adding Sparse Controls to Text-to-Video Diffusion Models](https://huggingface.co/papers/2311.16933).
Este modelo hereda de [DiffusionPipeline](/docs/diffusers/main/es/api/pipelines/overview#diffusers.DiffusionPipeline). Consulta la documentación de la clase superior para los métodos genéricos implementados en todas las tuberías (descarga, guardado, ejecución en un dispositivo específico, etc.).
El pipeline también hereda los siguientes métodos de carga:
- [load_textual_inversion()](/docs/diffusers/main/es/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) para cargar incrustaciones de inversión textual
- [load_lora_weights()](/docs/diffusers/main/es/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) para cargar los pesos de LoRA
- [save_lora_weights()](/docs/diffusers/main/es/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) para guardar los pesos de LoRA
- [load_ip_adapter()](/docs/diffusers/main/es/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) para cargar IP Adapters
#### __call__[[diffusers.AnimateDiffSparseControlNetPipeline.__call__]]
```python
__call__(prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_frames: int = 16, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, controlnet_frame_indices: list = [0], guess_mode: bool = False, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'])
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L712)
**Parámetros:**
prompt (`str` o `list[str]`, *opcional*) : El prompt o los prompts para guiar la generación de imágenes. Si no se define, debe pasar `prompt_embeds`.
height (`int`, *opcional*, valor predeterminado `self.unet.config.sample_size * self.vae_scale_factor`) : La altura en píxeles del video generado.
width (`int`, *opcional*, valor predeterminado `self.unet.config.sample_size * self.vae_scale_factor`) : El ancho en píxeles del video generado.
num_frames (`int`, *opcional*, valor predeterminado 16) : El número de fotogramas de video que se generan. El valor predeterminado es de 16 fotogramas, lo que a 8 fotogramas por segundo equivale a 2 segundos de video.
num_inference_steps (`int`, *opcional*, valor predeterminado 50) : El número de pasos de desruido. Más pasos de desruido suelen conducir a videos de mayor calidad a costa de una inferencia más lenta.
guidance_scale (`float`, *opcional*, valor predeterminado 7.5) : Un valor más alto de la escala de guía anima al modelo a generar imágenes estrechamente vinculadas al `prompt` de texto a costa de una menor calidad de imagen. La escala de guía se habilita cuando `guidance_scale > 1`.
negative_prompt (`str` o `list[str]`, *opcional*) : El prompt o los prompts para guiar lo que no debe incluirse en la generación de la imagen. Si no se define, debe pasar `negative_prompt_embeds` en su lugar. Se ignora cuando no se usa guía (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opcional*, valor predeterminado 1) : El número de videos a generar por indicación.
eta (`float`, *opcional*, valor predeterminado 0.0) : Corresponde al parámetro eta (η) del artículo [DDIM](https://huggingface.co/papers/2010.02502). Solo se aplica al [DDIMScheduler](/docs/diffusers/main/es/api/schedulers/ddim#diffusers.DDIMScheduler) y se ignora en otros programadores.
generator (`torch.Generator` o `list[torch.Generator]`, *opcional*) : Un [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) para hacer la generación determinista.
latents (`torch.Tensor`, *opcional*) : Latentes ruidosos pregenerados muestreados de una distribución gaussiana, para usarse como entradas para la generación de video. Se pueden usar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se genera un tensor de latentes mediante muestreo usando el `generator` aleatorio suministrado. Los latentes deben tener la forma `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opcional*) : Incrustaciones de texto pregeneradas. Se pueden usar para ajustar fácilmente las entradas de texto (ponderación del prompt). Si no se proporcionan, las incrustaciones de texto se generan a partir del argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pregenerados. Se pueden usar para ajustar fácilmente las entradas de texto (ponderación del prompt). Si no se proporcionan, `negative_prompt_embeds` se generan a partir del argumento de entrada `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opcional*): Entrada de imagen opcional para trabajar con IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opcional*) : Incrustaciones de imagen pregeneradas para IP-Adapter. Debe ser una lista de la misma longitud que el número de IP-adapters. Cada elemento debe ser un tensor de forma `(batch_size, num_images, emb_dim)`. Debe contener la incrustación de imagen negativa si `do_classifier_free_guidance` está establecido en `True`. Si no se proporciona, las incrustaciones se calculan a partir del argumento de entrada `ip_adapter_image`.
conditioning_frames (`list[PipelineImageInput]`, *opcional*) : La entrada de SparseControlNet para proporcionar orientación a la `unet` para la generación.
output_type (`str`, *opcional*, por defecto `"pil"`) : El formato de salida del video generado. Elija entre `torch.Tensor`, `PIL.Image` o `np.array`.
return_dict (`bool`, *opcional*, valor predeterminado `True`) : Indica si se debe devolver un `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` en lugar de una tupla simple.
cross_attention_kwargs (`dict`, *opcional*) : Un diccionario de kwargs que, si se especifica, se pasa al `AttentionProcessor` tal como se define en [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
controlnet_conditioning_scale (`float` o `list[float]`, *opcional*, valor predeterminado 1.0) : Las salidas del ControlNet se multiplican por `controlnet_conditioning_scale` antes de sumarse al residual en el `unet` original. Si se especifican varios ControlNets en `init`, puedes establecer la escala correspondiente como una lista.
controlnet_frame_indices (`list[int]`) : Los índices donde deben aplicarse los fotogramas de condicionamiento para la generación. Se pueden proporcionar varios fotogramas para guiar al modelo a generar salidas con una estructura similar, donde el `unet` puede "rellenar los huecos" para videos de interpolación, o se puede proporcionar un solo fotograma para una estructura general esperada. Debe tener la misma longitud que `conditioning_frames`.
guess_mode (`bool`, *opcional*, valor predeterminado `False`) : El codificador de ControlNet intenta reconocer el contenido de la imagen de entrada incluso si eliminas todos los prompts. Se recomienda un valor de `guidance_scale` entre 3.0 y 5.0.
clip_skip (`int`, *opcional*) : Número de capas que se omitirán de CLIP al calcular los embeddings del prompt. Un valor de 1 significa que se utilizará la salida de la capa previa a la final para calcular los embeddings del prompt.
callback_on_step_end (`Callable`, *opcional*) : Una función que se llama al final de cada paso de desruido durante la inferencia. La función se llama con los siguientes argumentos: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` incluirá una lista de todos los tensores especificados por `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opcional*) : La lista de entradas de tensor para la función `callback_on_step_end`. Los tensores especificados en la lista se pasarán como argumento `callback_kwargs`. Solo podrá incluir variables enumeradas en el atributo `._callback_tensor_inputs` de su clase de pipeline.
**Devuelve:** [AnimateDiffPipelineOutput](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) o `tuple`
Si `return_dict` es `True`, se devuelve [AnimateDiffPipelineOutput](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput); en caso contrario, se devuelve una `tuple` cuyo primer elemento es una lista con los fotogramas generados.
La función de llamada para el pipeline de generación.
Ejemplos:
```python
>>> import torch
>>> from diffusers import AnimateDiffSparseControlNetPipeline
>>> from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
>>> from diffusers.schedulers import DPMSolverMultistepScheduler
>>> from diffusers.utils import export_to_gif, load_image
>>> model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
>>> motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
>>> controlnet_id = "guoyww/animatediff-sparsectrl-scribble"
>>> lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
>>> vae_id = "stabilityai/sd-vae-ft-mse"
>>> device = "cuda"
>>> motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, torch_dtype=torch.float16).to(device)
>>> controlnet = SparseControlNetModel.from_pretrained(controlnet_id, torch_dtype=torch.float16).to(device)
>>> vae = AutoencoderKL.from_pretrained(vae_id, torch_dtype=torch.float16).to(device)
>>> scheduler = DPMSolverMultistepScheduler.from_pretrained(
... model_id,
... subfolder="scheduler",
... beta_schedule="linear",
... algorithm_type="dpmsolver++",
... use_karras_sigmas=True,
... )
>>> pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
... model_id,
... motion_adapter=motion_adapter,
... controlnet=controlnet,
... vae=vae,
... scheduler=scheduler,
... torch_dtype=torch.float16,
... ).to(device)
>>> pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
>>> pipe.fuse_lora(lora_scale=1.0)
>>> prompt = "an aerial view of a cyberpunk city, night time, neon lights, masterpiece, high quality"
>>> negative_prompt = "low quality, worst quality, letterboxed"
>>> image_files = [
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-1.png",
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-2.png",
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-3.png",
... ]
>>> condition_frame_indices = [0, 8, 15]
>>> conditioning_frames = [load_image(img_file) for img_file in image_files]
>>> video = pipe(
... prompt=prompt,
... negative_prompt=negative_prompt,
... num_inference_steps=25,
... conditioning_frames=conditioning_frames,
... controlnet_conditioning_scale=1.0,
... controlnet_frame_indices=condition_frame_indices,
... generator=torch.Generator().manual_seed(1337),
... ).frames[0]
>>> export_to_gif(video, "output.gif")
```
#### encode_prompt[[diffusers.AnimateDiffSparseControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L208)
**Parámetros:**
prompt (`str` o `list[str]`, *opcional*) : prompt a codificar
device : (`torch.device`): dispositivo de torch
num_images_per_prompt (`int`) : número de imágenes que deben generarse por prompt
do_classifier_free_guidance (`bool`) : si se debe usar o no la guía libre de clasificador
negative_prompt (`str` o `list[str]`, *opcional*) : El prompt o prompts que no deben guiar la generación de la imagen. Si no se define, se debe pasar `negative_prompt_embeds` en su lugar. Se ignora cuando no se usa guía (es decir, se ignora si `guidance_scale` es menor que `1`).
prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto pregenerados. Se pueden usar para ajustar fácilmente las entradas de texto, *p. ej.* ponderación de prompts. Si no se proporcionan, los embeddings de texto se generarán a partir del argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pregenerados. Se pueden utilizar para ajustar fácilmente las entradas de texto, *p. ej.* el ponderado de prompts. Si no se proporcionan, negative_prompt_embeds se generará a partir del argumento de entrada `negative_prompt`.
lora_scale (`float`, *opcional*) : Una escala LoRA que se aplicará a todas las capas LoRA del codificador de texto si se cargan capas LoRA.
clip_skip (`int`, *opcional*) : Número de capas que se omitirán de CLIP al calcular los embeddings del prompt. Un valor de 1 significa que se utilizará la salida de la capa previa a la final para calcular los embeddings del prompt.
Codifica el prompt en estados ocultos del codificador de texto.
## AnimateDiffSDXLPipeline[[diffusers.AnimateDiffSDXLPipeline]]
#### diffusers.AnimateDiffSDXLPipeline[[diffusers.AnimateDiffSDXLPipeline]]
```python
diffusers.AnimateDiffSDXLPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, text_encoder_2: CLIPTextModelWithProjection, tokenizer: CLIPTokenizer, tokenizer_2: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, image_encoder: CLIPVisionModelWithProjection = None, feature_extractor: CLIPImageProcessorPil = None, force_zeros_for_empty_prompt: bool = True)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L210)
**Parámetros:**
vae ([AutoencoderKL](/docs/diffusers/main/es/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Modelo de Variational Auto-Encoder (VAE) para codificar y decodificar imágenes hacia y desde representaciones latentes.
text_encoder (`CLIPTextModel`) : Codificador de texto congelado. Stable Diffusion XL utiliza la parte de texto de [CLIP](https://huggingface.co/docs/transformers/model_doc/clip#transformers.CLIPTextModel), específicamente la variante [clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14).
text_encoder_2 (` CLIPTextModelWithProjection`) : Segundo codificador de texto congelado. Stable Diffusion XL utiliza la parte de texto y pool de [CLIP](https://huggingface.co/docs/transformers/model_doc/clip#transformers.CLIPTextModelWithProjection), específicamente la variante [laion/CLIP-ViT-bigG-14-laion2B-39B-b160k](https://huggingface.co/laion/CLIP-ViT-bigG-14-laion2B-39B-b160k).
tokenizer (`CLIPTokenizer`) : Tokenizador de la clase [CLIPTokenizer](https://huggingface.co/docs/transformers/v4.21.0/en/model_doc/clip#transformers.CLIPTokenizer).
tokenizer_2 (`CLIPTokenizer`) : Segundo Tokenizer de la clase [CLIPTokenizer](https://huggingface.co/docs/transformers/v4.21.0/en/model_doc/clip#transformers.CLIPTokenizer).
unet ([UNet2DConditionModel](/docs/diffusers/main/es/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Arquitectura de U-Net condicional para desruidar los latentes de imagen codificados.
scheduler ([SchedulerMixin](/docs/diffusers/main/es/api/schedulers/overview#diffusers.SchedulerMixin)) : Un scheduler para usar en combinación con `unet` para desruidar los latentes de la imagen codificada. Puede ser uno de [DDIMScheduler](/docs/diffusers/main/es/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/es/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) o [PNDMScheduler](/docs/diffusers/main/es/api/schedulers/pndm#diffusers.PNDMScheduler).
force_zeros_for_empty_prompt (`bool`, *opcional*, valor predeterminado `"True"`) : Si las incrustaciones del prompt negativo deben forzarse a establecerse siempre en 0. Consulte también la configuración de `stabilityai/stable-diffusion-xl-base-1-0`.
Pipeline para la generación de texto a video usando Stable Diffusion XL.
Este modelo hereda de [DiffusionPipeline](/docs/diffusers/main/es/api/pipelines/overview#diffusers.DiffusionPipeline). Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos los pipelines (como la descarga o el guardado, la ejecución en un dispositivo específico, etc.)
El pipeline también hereda los siguientes métodos de carga:
- [load_textual_inversion()](/docs/diffusers/main/es/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) para cargar incrustaciones de inversión textual
- [from_single_file()](/docs/diffusers/main/es/api/loaders/single_file#diffusers.loaders.FromSingleFileMixin.from_single_file) para la carga de archivos `.ckpt`
- [load_lora_weights()](/docs/diffusers/main/es/api/loaders/lora#diffusers.loaders.StableDiffusionXLLoraLoaderMixin.load_lora_weights) para cargar los pesos de LoRA
- [save_lora_weights()](/docs/diffusers/main/es/api/loaders/lora#diffusers.loaders.StableDiffusionXLLoraLoaderMixin.save_lora_weights) para guardar los pesos de LoRA
- [load_ip_adapter()](/docs/diffusers/main/es/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) para cargar IP Adapters
#### __call__[[diffusers.AnimateDiffSDXLPipeline.__call__]]
```python
__call__(prompt: str | list[str] = None, prompt_2: str | list[str] | None = None, num_frames: int = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, timesteps: list = None, sigmas: list = None, denoising_end: float | None = None, guidance_scale: float = 5.0, negative_prompt: str | list[str] | None = None, negative_prompt_2: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, negative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, guidance_rescale: float = 0.0, original_size: tuple[int, int] | None = None, crops_coords_top_left: tuple = (0, 0), target_size: tuple[int, int] | None = None, negative_original_size: tuple[int, int] | None = None, negative_crops_coords_top_left: tuple = (0, 0), negative_target_size: tuple[int, int] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'])
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L869)
**Parámetros:**
prompt (`str` o `list[str]`, *opcional*) : El prompt o los prompts para guiar la generación del video. Si no se define, se debe pasar `prompt_embeds` en su lugar.
prompt_2 (`str` o `list[str]`, *opcional*) : El prompt o los prompts que se enviarán al `tokenizer_2` y al `text_encoder_2`. Si no se define, se utiliza `prompt` en ambos text-encoders
num_frames : El número de fotogramas de video que se generan. El valor predeterminado es de 16 fotogramas, lo que a 8 fotogramas por segundo equivale a 2 segundos de video.
height (`int`, *opcional*, por defecto self.unet.config.sample_size * self.vae_scale_factor) : La altura en píxeles del video generado. Por defecto se establece en 1024 para obtener los mejores resultados. Cualquier valor inferior a 512 píxeles no funcionará bien con [stabilityai/stable-diffusion-xl-base-1.0](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0) ni con puntos de control que no estén específicamente afinados en resoluciones bajas.
width (`int`, *opcional*, por defecto self.unet.config.sample_size * self.vae_scale_factor) : El ancho en píxeles del video generado. Por defecto, se establece en 1024 para obtener los mejores resultados. Cualquier valor inferior a 512 píxeles no funcionará bien con [stabilityai/stable-diffusion-xl-base-1.0](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0) ni con puntos de control que no estén específicamente afinados en resoluciones bajas.
num_inference_steps (`int`, *opcional*, valor predeterminado 50) : El número de pasos de desruido. Más pasos de desruido suelen conducir a un video de mayor calidad a costa de una inferencia más lenta.
timesteps (`list[int]`, *opcional*) : Pasos de tiempo personalizados para usar en el proceso de desruido con programadores que admiten un argumento `timesteps` en su método `set_timesteps`. Si no se define, se usará el comportamiento predeterminado cuando se pase `num_inference_steps`. Debe estar en orden descendente.
sigmas (`list[float]`, *opcional*) : Sigmas personalizados para usar en el proceso de desruido con programadores que admiten un argumento `sigmas` en su método `set_timesteps`. Si no se define, se usará el comportamiento predeterminado cuando se pase `num_inference_steps`.
denoising_end (`float`, *opcional*) : Cuando se especifica, determina la fracción (entre 0.0 y 1.0) del proceso total de desruido que debe completarse antes de que se termine prematuramente de forma intencional. Como resultado, la muestra devuelta aún conservará una cantidad sustancial de ruido, tal como lo determinan los pasos discretos seleccionados por el programador. El parámetro denoising_end debería utilizarse idealmente cuando esta pipeline forma parte de una configuración multipipeline de "Mixture of Denoisers", como se detalla en [**Refining the Image Output**](https://huggingface.co/docs/diffusers/api/pipelines/stable_diffusion/stable_diffusion_xl#refining-the-image-output)
guidance_scale (`float`, *opcional*, valor predeterminado 5.0) : Escala de orientación definida en [Classifier-Free Diffusion Guidance](https://huggingface.co/papers/2207.12598). `guidance_scale` se define como `w` de la ecuación 2. de [Imagen Paper](https://huggingface.co/papers/2205.11487). La escala de orientación se habilita estableciendo `guidance_scale > 1`. Una escala de orientación más alta fomenta la generación de imágenes estrechamente vinculadas al `prompt` de texto, generalmente a costa de una menor calidad del video.
negative_prompt (`str` o `list[str]`, *opcional*) : El prompt o prompts que no deben guiar la generación del video. Si no se define, se debe pasar `negative_prompt_embeds` en su lugar. Se ignora cuando no se usa guía (es decir, se ignora si `guidance_scale` es menor que `1`).
negative_prompt_2 (`str` o `list[str]`, *opcional*) : El prompt o los prompts que no deben guiar la generación del video y que se enviarán a `tokenizer_2` y `text_encoder_2`. Si no se define, `negative_prompt` se utiliza en ambos text-encoders
num_videos_per_prompt (`int`, *opcional*, valor predeterminado 1) : El número de videos a generar por indicación.
eta (`float`, *opcional*, valor predeterminado 0.0) : Corresponde al parámetro eta (η) en el artículo de DDIM: https://huggingface.co/papers/2010.02502. Solo se aplica a [schedulers.DDIMScheduler](/docs/diffusers/main/es/api/schedulers/ddim#diffusers.DDIMScheduler), se ignorará en los demás.
generator (`torch.Generator` o `list[torch.Generator]`, *opcional*) : Uno o una lista de [generadores de torch](https://pytorch.org/docs/stable/generated/torch.Generator.html) para hacer la generación determinista.
latents (`torch.Tensor`, *opcional*) : Latentes ruidosos pregenerados, muestreados de una distribución gaussiana, que se utilizarán como entradas para la generación de video. Se pueden usar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se generará un tensor de latentes mediante muestreo usando el `generator` aleatorio suministrado.
prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto pregenerados. Se pueden usar para ajustar fácilmente las entradas de texto, *p. ej.* ponderación de prompts. Si no se proporcionan, los embeddings de texto se generarán a partir del argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pregenerados. Se pueden utilizar para ajustar fácilmente las entradas de texto, *p. ej.* el ponderado de prompts. Si no se proporcionan, negative_prompt_embeds se generará a partir del argumento de entrada `negative_prompt`.
pooled_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto agrupados pregenerados. Se pueden utilizar para ajustar fácilmente las entradas de texto, *p. ej.* el ponderado de prompts. Si no se proporcionan, los embeddings de texto agrupados se generarán a partir del argumento de entrada `prompt`.
negative_pooled_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativo agrupados pregenerados. Se pueden utilizar para ajustar fácilmente las entradas de texto, *p. ej.* el ponderado de prompts. Si no se proporcionan, los pooled negative_prompt_embeds se generarán a partir del argumento de entrada `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opcional*): Entrada de imagen opcional para trabajar con IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opcional*) : Incrustaciones de imagen pregeneradas para IP-Adapter. Si no se proporcionan, las incrustaciones se calculan a partir del argumento de entrada `ip_adapter_image`.
output_type (`str`, *opcional*, por defecto `"pil"`) : El formato de salida del video generado. Elija entre [PIL](https://pillow.readthedocs.io/en/stable/): `PIL.Image.Image` o `np.array`.
return_dict (`bool`, *opcional*, valor predeterminado `True`) : Indica si se debe devolver un `~pipelines.stable_diffusion_xl.AnimateDiffPipelineOutput` en lugar de una tupla simple.
cross_attention_kwargs (`dict`, *opcional*) : Un diccionario de kwargs que, si se especifica, se pasa al `AttentionProcessor` tal como se define bajo `self.processor` en [diffusers.models.attention_processor](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
guidance_rescale (`float`, *opcional*, valor predeterminado 0.0) : Factor de reescalado de guía propuesto por [Common Diffusion Noise Schedules and Sample Steps are Flawed](https://huggingface.co/papers/2305.08891) `guidance_scale` se define como `φ` en la ecuación 16. de [Common Diffusion Noise Schedules and Sample Steps are Flawed](https://huggingface.co/papers/2305.08891). El factor de reescalado de guía debe corregir la sobreexposición al usar SNR terminal cero.
original_size (`tuple[int]`, *opcional*, valor predeterminado (1024, 1024)) : Si `original_size` no es igual a `target_size`, la imagen parecerá haber sido reescalada hacia abajo o hacia arriba. `original_size` tiene como valor predeterminado `(height, width)` si no se especifica. Parte del micro-condicionamiento de SDXL, tal como se explica en la sección 2.2 de [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952).
crops_coords_top_left (`tuple[int]`, *opcional*, valor predeterminado (0, 0)) : `crops_coords_top_left` se puede utilizar para generar una imagen que parezca "recortada" desde la posición `crops_coords_top_left` hacia abajo. Generalmente, se logran imágenes favorables y bien centradas estableciendo `crops_coords_top_left` en (0, 0). Forma parte del micro-condicionamiento de SDXL, tal como se explica en la sección 2.2 de [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952).
target_size (`tuple[int]`, *opcional*, valor predeterminado (1024, 1024)) : En la mayoría de los casos, `target_size` debe establecerse en la altura y el ancho deseados de la imagen generada. Si no se especifica, el valor predeterminado será `(height, width)`. Forma parte del micro-condicionamiento de SDXL, tal como se explica en la sección 2.2 de [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952).
negative_original_size (`tuple[int]`, *opcional*, valor predeterminado (1024, 1024)) : Para condicionar negativamente el proceso de generación en función de una resolución de imagen específica. Forma parte del micro-condicionamiento de SDXL, tal como se explica en la sección 2.2 de [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952). Para obtener más información, consulte este hilo de problemas: https://github.com/huggingface/diffusers/issues/4208.
negative_crops_coords_top_left (`tuple[int]`, *opcional*, valor predeterminado (0, 0)) : Para condicionar negativamente el proceso de generación en función de unas coordenadas de recorte específicas. Forma parte del micro-condicionamiento de SDXL, tal como se explica en la sección 2.2 de [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952). Para obtener más información, consulte este hilo de problemas: https://github.com/huggingface/diffusers/issues/4208.
negative_target_size (`tuple[int]`, *opcional*, valor predeterminado (1024, 1024)) : Para condicionar negativamente el proceso de generación en función de la resolución de imagen objetivo. Debe ser igual que `target_size` en la mayoría de los casos. Forma parte del micro-condicionamiento de SDXL, tal como se explica en la sección 2.2 de [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952). Para obtener más información, consulte este hilo de problemas: https://github.com/huggingface/diffusers/issues/4208.
clip_skip (`int`, *opcional*) : Número de capas que se omitirán de CLIP al calcular los embeddings del prompt. Un valor de 1 significa que se utilizará la salida de la capa previa a la final para calcular los embeddings del prompt.
callback_on_step_end (`Callable`, *opcional*) : Una función que se llama al final de cada paso de desruido durante la inferencia. La función se llama con los siguientes argumentos: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` incluirá una lista de todos los tensores especificados por `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opcional*) : La lista de entradas de tensor para la función `callback_on_step_end`. Los tensores especificados en la lista se pasarán como argumento `callback_kwargs`. Solo podrá incluir variables enumeradas en el atributo `._callback_tensor_inputs` de su clase de pipeline.
**Devuelve:** [AnimateDiffPipelineOutput](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) o `tuple`
Si `return_dict` es `True`, se devuelve [AnimateDiffPipelineOutput](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput); en caso contrario, se devuelve una `tuple` cuyo primer elemento es una lista con los fotogramas generados.
Función invocada al llamar a la pipeline para la generación.
Ejemplos:
```py
>>> import torch
>>> from diffusers.models import MotionAdapter
>>> from diffusers import AnimateDiffSDXLPipeline, DDIMScheduler
>>> from diffusers.utils import export_to_gif
>>> adapter = MotionAdapter.from_pretrained(
... "a-r-r-o-w/animatediff-motion-adapter-sdxl-beta", torch_dtype=torch.float16
... )
>>> model_id = "stabilityai/stable-diffusion-xl-base-1.0"
>>> scheduler = DDIMScheduler.from_pretrained(
... model_id,
... subfolder="scheduler",
... clip_sample=False,
... timestep_spacing="linspace",
... beta_schedule="linear",
... steps_offset=1,
... )
>>> pipe = AnimateDiffSDXLPipeline.from_pretrained(
... model_id,
... motion_adapter=adapter,
... scheduler=scheduler,
... torch_dtype=torch.float16,
... variant="fp16",
... ).to("cuda")
>>> # enable memory savings
>>> pipe.vae.enable_slicing()
>>> pipe.vae.enable_tiling()
>>> output = pipe(
... prompt="a panda surfing in the ocean, realistic, high quality",
... negative_prompt="low quality, worst quality",
... num_inference_steps=20,
... guidance_scale=8,
... width=1024,
... height=1024,
... num_frames=16,
... )
>>> frames = output.frames[0]
>>> export_to_gif(frames, "animation.gif")
```
#### encode_prompt[[diffusers.AnimateDiffSDXLPipeline.encode_prompt]]
```python
encode_prompt(prompt: str, prompt_2: str | None = None, device: typing.Optional[torch.device] = None, num_videos_per_prompt: int = 1, do_classifier_free_guidance: bool = True, negative_prompt: str | None = None, negative_prompt_2: str | None = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, negative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L327)
**Parámetros:**
prompt (`str` o `list[str]`, *opcional*) : prompt a codificar
prompt_2 (`str` o `list[str]`, *opcional*) : El prompt o los prompts que se enviarán al `tokenizer_2` y al `text_encoder_2`. Si no se define, se utiliza `prompt` en ambos text-encoders
device : (`torch.device`): dispositivo de torch
num_videos_per_prompt (`int`) : número de imágenes que deben generarse por prompt
do_classifier_free_guidance (`bool`) : si se debe usar o no la guía libre de clasificador
negative_prompt (`str` o `list[str]`, *opcional*) : El prompt o prompts que no deben guiar la generación de la imagen. Si no se define, se debe pasar `negative_prompt_embeds` en su lugar. Se ignora cuando no se usa guía (es decir, se ignora si `guidance_scale` es menor que `1`).
negative_prompt_2 (`str` o `list[str]`, *opcional*) : El prompt o los prompts que no deben guiar la generación de la imagen y que se enviarán a `tokenizer_2` y `text_encoder_2`. Si no se define, `negative_prompt` se utiliza en ambos text-encoders
prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto pregenerados. Se pueden usar para ajustar fácilmente las entradas de texto, *p. ej.* ponderación de prompts. Si no se proporcionan, los embeddings de texto se generarán a partir del argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pregenerados. Se pueden utilizar para ajustar fácilmente las entradas de texto, *p. ej.* el ponderado de prompts. Si no se proporcionan, negative_prompt_embeds se generará a partir del argumento de entrada `negative_prompt`.
pooled_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto agrupados pregenerados. Se pueden utilizar para ajustar fácilmente las entradas de texto, *p. ej.* el ponderado de prompts. Si no se proporcionan, los embeddings de texto agrupados se generarán a partir del argumento de entrada `prompt`.
negative_pooled_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativo agrupados pregenerados. Se pueden utilizar para ajustar fácilmente las entradas de texto, *p. ej.* el ponderado de prompts. Si no se proporcionan, los pooled negative_prompt_embeds se generarán a partir del argumento de entrada `negative_prompt`.
lora_scale (`float`, *opcional*) : Una escala lora que se aplicará a todas las capas LoRA del codificador de texto si se cargan capas LoRA.
clip_skip (`int`, *opcional*) : Número de capas que se omitirán de CLIP al calcular los embeddings del prompt. Un valor de 1 significa que se utilizará la salida de la capa previa a la final para calcular los embeddings del prompt.
Codifica el prompt en estados ocultos del codificador de texto.
#### get_guidance_scale_embedding[[diffusers.AnimateDiffSDXLPipeline.get_guidance_scale_embedding]]
```python
get_guidance_scale_embedding(w: Tensor, embedding_dim: int = 512, dtype: dtype = torch.float32)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L804)
**Parámetros:**
w (`torch.Tensor`) : Genera vectores de incrustación con una escala de guía especificada para enriquecer posteriormente las incrustaciones de paso temporal.
embedding_dim (`int`, *opcional*, valor predeterminado 512) : Dimensión de las incrustaciones a generar.
dtype (`torch.dtype`, *opcional*, valor predeterminado `torch.float32`) : Tipo de datos de los embeddings generados.
**Devuelve:** `torch.Tensor`
Vectores de incrustación con forma `(len(w), embedding_dim)`.
Ver https://github.com/google-research/vdm/blob/dc27b98a554f65cdc654b800da5aa1846545d41b/model_vdm.py#L298
## AnimateDiffVideoToVideoPipeline[[diffusers.AnimateDiffVideoToVideoPipeline]]
#### diffusers.AnimateDiffVideoToVideoPipeline[[diffusers.AnimateDiffVideoToVideoPipeline]]
```python
diffusers.AnimateDiffVideoToVideoPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L181)
**Parámetros:**
vae ([AutoencoderKL](/docs/diffusers/main/es/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Modelo de Variational Auto-Encoder (VAE) para codificar y decodificar imágenes hacia y desde representaciones latentes.
text_encoder (`CLIPTextModel`) : Codificador de texto congelado ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Un [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) para tokenizar texto.
unet ([UNet2DConditionModel](/docs/diffusers/main/es/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Un [UNet2DConditionModel](/docs/diffusers/main/es/api/models/unet2d-cond#diffusers.UNet2DConditionModel) utilizado para crear un UNetMotionModel que desruidice los latentes de video codificados.
motion_adapter (`MotionAdapter`) : Un `MotionAdapter` para usar en combinación con `unet` para desruidar los latentes de video codificados.
scheduler ([SchedulerMixin](/docs/diffusers/main/es/api/schedulers/overview#diffusers.SchedulerMixin)) : Un scheduler para usar en combinación con `unet` para desruidar los latentes de la imagen codificada. Puede ser uno de [DDIMScheduler](/docs/diffusers/main/es/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/es/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) o [PNDMScheduler](/docs/diffusers/main/es/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline para la generación de video a video.
Este modelo hereda de [DiffusionPipeline](/docs/diffusers/main/es/api/pipelines/overview#diffusers.DiffusionPipeline). Consulta la documentación de la clase superior para los métodos genéricos implementados en todas las tuberías (descarga, guardado, ejecución en un dispositivo específico, etc.).
El pipeline también hereda los siguientes métodos de carga:
- [load_textual_inversion()](/docs/diffusers/main/es/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) para cargar incrustaciones de inversión textual
- [load_lora_weights()](/docs/diffusers/main/es/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) para cargar los pesos de LoRA
- [save_lora_weights()](/docs/diffusers/main/es/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) para guardar los pesos de LoRA
- [load_ip_adapter()](/docs/diffusers/main/es/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) para cargar IP Adapters
#### __call__[[diffusers.AnimateDiffVideoToVideoPipeline.__call__]]
```python
__call__(video: list = None, prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, enforce_inference_steps: bool = False, timesteps: list[int] | None = None, sigmas: list[float] | None = None, guidance_scale: float = 7.5, strength: float = 0.8, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'], decode_chunk_size: int = 16)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L744)
**Parámetros:**
video (`list[PipelineImageInput]`) : El video de entrada para condicionar la generación. Debe ser una lista de imágenes o fotogramas del video.
prompt (`str` o `list[str]`, *opcional*) : El prompt o los prompts para guiar la generación de imágenes. Si no se define, debe pasar `prompt_embeds`.
height (`int`, *opcional*, valor predeterminado `self.unet.config.sample_size * self.vae_scale_factor`) : La altura en píxeles del video generado.
width (`int`, *opcional*, valor predeterminado `self.unet.config.sample_size * self.vae_scale_factor`) : El ancho en píxeles del video generado.
num_inference_steps (`int`, *opcional*, valor predeterminado 50) : El número de pasos de desruido. Más pasos de desruido suelen conducir a videos de mayor calidad a costa de una inferencia más lenta.
enforce_inference_steps (`bool`, *opcional*, valor predeterminado `False`) : Si se debe aplicar el número de pasos de desruido `num_inference_steps` independientemente del parámetro `strength`. Cuando es `False`, el número efectivo de pasos de inferencia se reduce según `strength`.
timesteps (`list[int]`, *opcional*) : Pasos de tiempo personalizados para usar en el proceso de desruido con programadores que admiten un argumento `timesteps` en su método `set_timesteps`. Si no se define, se usará el comportamiento predeterminado cuando se pase `num_inference_steps`. Debe estar en orden descendente.
sigmas (`list[float]`, *opcional*) : Sigmas personalizados para usar en el proceso de desruido con programadores que admiten un argumento `sigmas` en su método `set_timesteps`. Si no se define, se usará el comportamiento predeterminado cuando se pase `num_inference_steps`.
strength (`float`, *opcional*, valor predeterminado 0.8) : Una mayor intensidad produce más diferencias entre el video original y el video generado.
guidance_scale (`float`, *opcional*, valor predeterminado 7.5) : Un valor más alto de la escala de guía anima al modelo a generar imágenes estrechamente vinculadas al `prompt` de texto a costa de una menor calidad de imagen. La escala de guía se habilita cuando `guidance_scale > 1`.
negative_prompt (`str` o `list[str]`, *opcional*) : El prompt o los prompts para guiar lo que no debe incluirse en la generación de la imagen. Si no se define, debe pasar `negative_prompt_embeds` en su lugar. Se ignora cuando no se usa guía (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opcional*, valor predeterminado 1) : El número de videos a generar por indicación.
eta (`float`, *opcional*, valor predeterminado 0.0) : Corresponde al parámetro eta (η) del artículo [DDIM](https://huggingface.co/papers/2010.02502). Solo se aplica al [DDIMScheduler](/docs/diffusers/main/es/api/schedulers/ddim#diffusers.DDIMScheduler) y se ignora en otros programadores.
generator (`torch.Generator` o `list[torch.Generator]`, *opcional*) : Un [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) para hacer la generación determinista.
latents (`torch.Tensor`, *opcional*) : Latentes ruidosos pregenerados muestreados de una distribución gaussiana, para usarse como entradas para la generación de video. Se pueden usar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se genera un tensor de latentes mediante muestreo usando el `generator` aleatorio suministrado. Los latentes deben tener la forma `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opcional*) : Incrustaciones de texto pregeneradas. Se pueden usar para ajustar fácilmente las entradas de texto (ponderación del prompt). Si no se proporcionan, las incrustaciones de texto se generan a partir del argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pregenerados. Se pueden usar para ajustar fácilmente las entradas de texto (ponderación del prompt). Si no se proporcionan, `negative_prompt_embeds` se generan a partir del argumento de entrada `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opcional*): Entrada de imagen opcional para trabajar con IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opcional*) : Incrustaciones de imagen pregeneradas para IP-Adapter. Debe ser una lista de la misma longitud que el número de IP-adapters. Cada elemento debe ser un tensor de forma `(batch_size, num_images, emb_dim)`. Debe contener la incrustación de imagen negativa si `do_classifier_free_guidance` está establecido en `True`. Si no se proporciona, las incrustaciones se calculan a partir del argumento de entrada `ip_adapter_image`.
output_type (`str`, *opcional*, por defecto `"pil"`) : El formato de salida del video generado. Elija entre `torch.Tensor`, `PIL.Image` o `np.array`.
return_dict (`bool`, *opcional*, por defecto `True`) : Si se devuelve un `AnimateDiffPipelineOutput` en lugar de una tupla simple.
cross_attention_kwargs (`dict`, *opcional*) : Un diccionario de kwargs que, si se especifica, se pasa al `AttentionProcessor` tal como se define en [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
clip_skip (`int`, *opcional*) : Número de capas que se omitirán de CLIP al calcular los embeddings del prompt. Un valor de 1 significa que se utilizará la salida de la capa previa a la final para calcular los embeddings del prompt.
callback_on_step_end (`Callable`, *opcional*) : Una función que se llama al final de cada paso de desruido durante la inferencia. La función se llama con los siguientes argumentos: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` incluirá una lista de todos los tensores especificados por `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opcional*) : La lista de entradas de tensor para la función `callback_on_step_end`. Los tensores especificados en la lista se pasarán como argumento `callback_kwargs`. Solo podrá incluir variables enumeradas en el atributo `._callback_tensor_inputs` de su clase de pipeline.
decode_chunk_size (`int`, por defecto `16`) : El número de fotogramas a decodificar a la vez al llamar al método `decode_latents`.
**Devuelve:** [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) o `tuple`
Si `return_dict` es `True`, se devuelve [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput); en caso contrario, se devuelve una `tuple` cuyo primer elemento es una lista con los fotogramas generados.
La función de llamada para el pipeline de generación.
Ejemplos:
#### encode_prompt[[diffusers.AnimateDiffVideoToVideoPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L256)
**Parámetros:**
prompt (`str` o `list[str]`, *opcional*) : prompt a codificar
device : (`torch.device`): dispositivo de torch
num_images_per_prompt (`int`) : número de imágenes que deben generarse por prompt
do_classifier_free_guidance (`bool`) : si se debe usar o no la guía libre de clasificador
negative_prompt (`str` o `list[str]`, *opcional*) : El prompt o prompts que no deben guiar la generación de la imagen. Si no se define, se debe pasar `negative_prompt_embeds` en su lugar. Se ignora cuando no se usa guía (es decir, se ignora si `guidance_scale` es menor que `1`).
prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto pregenerados. Se pueden usar para ajustar fácilmente las entradas de texto, *p. ej.* ponderación de prompts. Si no se proporcionan, los embeddings de texto se generarán a partir del argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pregenerados. Se pueden utilizar para ajustar fácilmente las entradas de texto, *p. ej.* el ponderado de prompts. Si no se proporcionan, negative_prompt_embeds se generará a partir del argumento de entrada `negative_prompt`.
lora_scale (`float`, *opcional*) : Una escala LoRA que se aplicará a todas las capas LoRA del codificador de texto si se cargan capas LoRA.
clip_skip (`int`, *opcional*) : Número de capas que se omitirán de CLIP al calcular los embeddings del prompt. Un valor de 1 significa que se utilizará la salida de la capa previa a la final para calcular los embeddings del prompt.
Codifica el prompt en estados ocultos del codificador de texto.
## AnimateDiffVideoToVideoControlNetPipeline[[diffusers.AnimateDiffVideoToVideoControlNetPipeline]]
#### diffusers.AnimateDiffVideoToVideoControlNetPipeline[[diffusers.AnimateDiffVideoToVideoControlNetPipeline]]
```python
diffusers.AnimateDiffVideoToVideoControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: diffusers.models.controlnets.controlnet.ControlNetModel | list[diffusers.models.controlnets.controlnet.ControlNetModel] | tuple[diffusers.models.controlnets.controlnet.ControlNetModel] | diffusers.models.controlnets.multicontrolnet.MultiControlNetModel, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L199)
**Parámetros:**
vae ([AutoencoderKL](/docs/diffusers/main/es/api/models/autoencoderkl#diffusers.AutoencoderKL)) : Modelo de Variational Auto-Encoder (VAE) para codificar y decodificar imágenes hacia y desde representaciones latentes.
text_encoder (`CLIPTextModel`) : Codificador de texto congelado ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : Un [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) para tokenizar texto.
unet ([UNet2DConditionModel](/docs/diffusers/main/es/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : Un [UNet2DConditionModel](/docs/diffusers/main/es/api/models/unet2d-cond#diffusers.UNet2DConditionModel) utilizado para crear un UNetMotionModel que desruidice los latentes de video codificados.
motion_adapter (`MotionAdapter`) : Un `MotionAdapter` para usar en combinación con `unet` para desruidar los latentes de video codificados.
controlnet ([ControlNetModel](/docs/diffusers/main/es/api/models/controlnet#diffusers.ControlNetModel) o `list[ControlNetModel]` o `tuple[ControlNetModel]` o `MultiControlNetModel`) : Proporciona una condición adicional al `unet` durante el proceso de desruido. Si configuras varios ControlNets como una lista, las salidas de cada ControlNet se suman para crear una condición adicional combinada.
scheduler ([SchedulerMixin](/docs/diffusers/main/es/api/schedulers/overview#diffusers.SchedulerMixin)) : Un scheduler para usar en combinación con `unet` para desruidar los latentes de la imagen codificada. Puede ser uno de [DDIMScheduler](/docs/diffusers/main/es/api/schedulers/ddim#diffusers.DDIMScheduler), [LMSDiscreteScheduler](/docs/diffusers/main/es/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) o [PNDMScheduler](/docs/diffusers/main/es/api/schedulers/pndm#diffusers.PNDMScheduler).
Pipeline para la generación de video a video con guía de ControlNet.
Este modelo hereda de [DiffusionPipeline](/docs/diffusers/main/es/api/pipelines/overview#diffusers.DiffusionPipeline). Consulta la documentación de la clase superior para los métodos genéricos implementados en todas las tuberías (descarga, guardado, ejecución en un dispositivo específico, etc.).
El pipeline también hereda los siguientes métodos de carga:
- [load_textual_inversion()](/docs/diffusers/main/es/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) para cargar incrustaciones de inversión textual
- [load_lora_weights()](/docs/diffusers/main/es/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) para cargar los pesos de LoRA
- [save_lora_weights()](/docs/diffusers/main/es/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) para guardar los pesos de LoRA
- [load_ip_adapter()](/docs/diffusers/main/es/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) para cargar IP Adapters
#### __call__[[diffusers.AnimateDiffVideoToVideoControlNetPipeline.__call__]]
```python
__call__(video: list = None, prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, enforce_inference_steps: bool = False, timesteps: list[int] | None = None, sigmas: list[float] | None = None, guidance_scale: float = 7.5, strength: float = 0.8, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, guess_mode: bool = False, control_guidance_start: float | list[float] = 0.0, control_guidance_end: float | list[float] = 1.0, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'], decode_chunk_size: int = 16)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L909)
**Parámetros:**
video (`list[PipelineImageInput]`) : El video de entrada para condicionar la generación. Debe ser una lista de imágenes o fotogramas del video.
prompt (`str` o `list[str]`, *opcional*) : El prompt o los prompts para guiar la generación de imágenes. Si no se define, debe pasar `prompt_embeds`.
height (`int`, *opcional*, valor predeterminado `self.unet.config.sample_size * self.vae_scale_factor`) : La altura en píxeles del video generado.
width (`int`, *opcional*, valor predeterminado `self.unet.config.sample_size * self.vae_scale_factor`) : El ancho en píxeles del video generado.
num_inference_steps (`int`, *opcional*, valor predeterminado 50) : El número de pasos de desruido. Más pasos de desruido suelen conducir a videos de mayor calidad a costa de una inferencia más lenta.
enforce_inference_steps (`bool`, *opcional*, valor predeterminado `False`) : Si se debe aplicar el número de pasos de desruido `num_inference_steps` independientemente del parámetro `strength`. Cuando es `False`, el número efectivo de pasos de inferencia se reduce según `strength`.
timesteps (`list[int]`, *opcional*) : Pasos de tiempo personalizados para usar en el proceso de desruido con programadores que admiten un argumento `timesteps` en su método `set_timesteps`. Si no se define, se usará el comportamiento predeterminado cuando se pase `num_inference_steps`. Debe estar en orden descendente.
sigmas (`list[float]`, *opcional*) : Sigmas personalizados para usar en el proceso de desruido con programadores que admiten un argumento `sigmas` en su método `set_timesteps`. Si no se define, se usará el comportamiento predeterminado cuando se pase `num_inference_steps`.
strength (`float`, *opcional*, valor predeterminado 0.8) : Una mayor intensidad produce más diferencias entre el video original y el video generado.
guidance_scale (`float`, *opcional*, valor predeterminado 7.5) : Un valor más alto de la escala de guía anima al modelo a generar imágenes estrechamente vinculadas al `prompt` de texto a costa de una menor calidad de imagen. La escala de guía se habilita cuando `guidance_scale > 1`.
negative_prompt (`str` o `list[str]`, *opcional*) : El prompt o los prompts para guiar lo que no debe incluirse en la generación de la imagen. Si no se define, debe pasar `negative_prompt_embeds` en su lugar. Se ignora cuando no se usa guía (`guidance_scale < 1`).
num_videos_per_prompt (`int`, *opcional*, valor predeterminado 1) : El número de videos a generar por indicación.
eta (`float`, *opcional*, valor predeterminado 0.0) : Corresponde al parámetro eta (η) del artículo [DDIM](https://huggingface.co/papers/2010.02502). Solo se aplica al [DDIMScheduler](/docs/diffusers/main/es/api/schedulers/ddim#diffusers.DDIMScheduler) y se ignora en otros programadores.
generator (`torch.Generator` o `list[torch.Generator]`, *opcional*) : Un [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) para hacer la generación determinista.
latents (`torch.Tensor`, *opcional*) : Latentes ruidosos pregenerados muestreados de una distribución gaussiana, para usarse como entradas para la generación de video. Se pueden usar para ajustar la misma generación con diferentes prompts. Si no se proporcionan, se genera un tensor de latentes mediante muestreo usando el `generator` aleatorio suministrado. Los latentes deben tener la forma `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`, *opcional*) : Incrustaciones de texto pregeneradas. Se pueden usar para ajustar fácilmente las entradas de texto (ponderación del prompt). Si no se proporcionan, las incrustaciones de texto se generan a partir del argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pregenerados. Se pueden usar para ajustar fácilmente las entradas de texto (ponderación del prompt). Si no se proporcionan, `negative_prompt_embeds` se generan a partir del argumento de entrada `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`, *opcional*): Entrada de imagen opcional para trabajar con IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *opcional*) : Incrustaciones de imagen pregeneradas para IP-Adapter. Debe ser una lista de la misma longitud que el número de IP-adapters. Cada elemento debe ser un tensor de forma `(batch_size, num_images, emb_dim)`. Debe contener la incrustación de imagen negativa si `do_classifier_free_guidance` está establecido en `True`. Si no se proporciona, las incrustaciones se calculan a partir del argumento de entrada `ip_adapter_image`.
conditioning_frames (`list[PipelineImageInput]`, *opcional*) : La condición de entrada de ControlNet para proporcionar orientación a la `unet` durante la generación. Si se especifican varios ControlNets, las imágenes deben pasarse como una lista para que cada elemento de la lista pueda agruparse correctamente como entrada para un solo ControlNet.
output_type (`str`, *opcional*, por defecto `"pil"`) : El formato de salida del video generado. Elija entre `torch.Tensor`, `PIL.Image` o `np.array`.
return_dict (`bool`, *opcional*, por defecto `True`) : Si se devuelve un `AnimateDiffPipelineOutput` en lugar de una tupla simple.
cross_attention_kwargs (`dict`, *opcional*) : Un diccionario de kwargs que, si se especifica, se pasa al `AttentionProcessor` tal como se define en [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
controlnet_conditioning_scale (`float` o `list[float]`, *opcional*, valor predeterminado 1.0) : Las salidas del ControlNet se multiplican por `controlnet_conditioning_scale` antes de sumarse al residual en el `unet` original. Si se especifican varios ControlNets en `init`, puedes establecer la escala correspondiente como una lista.
guess_mode (`bool`, *opcional*, valor predeterminado `False`) : El codificador de ControlNet intenta reconocer el contenido de la imagen de entrada incluso si eliminas todos los prompts. Se recomienda un valor de `guidance_scale` entre 3.0 y 5.0.
control_guidance_start (`float` o `list[float]`, *opcional*, valor predeterminado 0.0) : El porcentaje de pasos totales en el que ControlNet comienza a aplicarse.
control_guidance_end (`float` o `list[float]`, *opcional*, valor predeterminado 1.0) : El porcentaje de pasos totales en el que ControlNet deja de aplicarse.
clip_skip (`int`, *opcional*) : Número de capas que se omitirán de CLIP al calcular los embeddings del prompt. Un valor de 1 significa que se utilizará la salida de la capa previa a la final para calcular los embeddings del prompt.
callback_on_step_end (`Callable`, *opcional*) : Una función que se llama al final de cada paso de desruido durante la inferencia. La función se llama con los siguientes argumentos: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. `callback_kwargs` incluirá una lista de todos los tensores especificados por `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`, *opcional*) : La lista de entradas de tensor para la función `callback_on_step_end`. Los tensores especificados en la lista se pasarán como argumento `callback_kwargs`. Solo podrá incluir variables enumeradas en el atributo `._callback_tensor_inputs` de su clase de pipeline.
decode_chunk_size (`int`, por defecto `16`) : El número de fotogramas a decodificar a la vez al llamar al método `decode_latents`.
**Devuelve:** [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) o `tuple`
Si `return_dict` es `True`, se devuelve [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/es/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput); en caso contrario, se devuelve una `tuple` cuyo primer elemento es una lista con los fotogramas generados.
La función de llamada para el pipeline de generación.
Ejemplos:
#### encode_prompt[[diffusers.AnimateDiffVideoToVideoControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L287)
**Parámetros:**
prompt (`str` o `list[str]`, *opcional*) : prompt a codificar
device : (`torch.device`): dispositivo de torch
num_images_per_prompt (`int`) : número de imágenes que deben generarse por prompt
do_classifier_free_guidance (`bool`) : si se debe usar o no la guía libre de clasificador
negative_prompt (`str` o `list[str]`, *opcional*) : El prompt o prompts que no deben guiar la generación de la imagen. Si no se define, se debe pasar `negative_prompt_embeds` en su lugar. Se ignora cuando no se usa guía (es decir, se ignora si `guidance_scale` es menor que `1`).
prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto pregenerados. Se pueden usar para ajustar fácilmente las entradas de texto, *p. ej.* ponderación de prompts. Si no se proporcionan, los embeddings de texto se generarán a partir del argumento de entrada `prompt`.
negative_prompt_embeds (`torch.Tensor`, *opcional*) : Embeddings de texto negativos pregenerados. Se pueden utilizar para ajustar fácilmente las entradas de texto, *p. ej.* el ponderado de prompts. Si no se proporcionan, negative_prompt_embeds se generará a partir del argumento de entrada `negative_prompt`.
lora_scale (`float`, *opcional*) : Una escala LoRA que se aplicará a todas las capas LoRA del codificador de texto si se cargan capas LoRA.
clip_skip (`int`, *opcional*) : Número de capas que se omitirán de CLIP al calcular los embeddings del prompt. Un valor de 1 significa que se utilizará la salida de la capa previa a la final para calcular los embeddings del prompt.
Codifica el prompt en estados ocultos del codificador de texto.
## AnimateDiffPipelineOutput[[diffusers.pipelines.animatediff.AnimateDiffPipelineOutput]]
#### diffusers.pipelines.animatediff.AnimateDiffPipelineOutput[[diffusers.pipelines.animatediff.AnimateDiffPipelineOutput]]
```python
diffusers.pipelines.animatediff.AnimateDiffPipelineOutput(frames: typing.Union[torch.Tensor, numpy.ndarray, list[list[PIL.Image.Image]]])
```
[Fuente](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_output.py#L11)
**Parámetros:**
frames (`torch.Tensor`, `np.ndarray` o list[list[PIL.Image.Image]]) : lista de salidas de video - Puede ser una lista anidada de longitud `batch_size,` donde cada sublista contiene
Clase de salida para las tuberías de AnimateDiff.
Secuencias de imágenes PIL de longitud `num_frames.` También puede ser un array de NumPy o un tensor de Torch de forma `(batch_size, num_frames, channels, height, width)`