# توليد الفيديو من النص باستخدام AnimateDiff
## نظرة عامة
[AnimateDiff: تحريك نماذج الانتشار النصية إلى الصور الشخصية دون ضبط محدد](https://huggingface.co/papers/2307.04725) بقلم يووي غو، سيويان يانغ، أني راو، ياوهوي وانغ، يو تشياو، داهوا لين، بو داي.
ملخص الورقة البحثية هو كالتالي:
*مع تقدُّم نماذج النص إلى صورة (مثل Stable Diffusion) وتقنيات التخصيص المقابلة لها مثل DreamBooth وLoRA، أصبح بإمكان الجميع تجسيد خيالهم في صور عالية الجودة بتكلفة معقولة. ونتيجةً لذلك، نشأت حاجة كبيرة لتقنيات تحريك الصور لدمج الصور الثابتة المولَّدة مع ديناميكيات الحركة بشكل أكبر. في هذا التقرير، نقترح إطارًا عمليًا لتحريك معظم نماذج النص إلى الصورة الشخصية الموجودة حاليًا مرة واحدة وإلى الأبد، مما يوفر الجهد المبذول في الضبط المحدد لكل نموذج. جوهر الإطار المقترح هو إدراج وحدة نمذجة حركة جديدة مهيأة في نموذج النص إلى الصورة المجمَّد، وتدريبها على مقاطع فيديو لاستخلاص مسبقات حركة معقولة. بمجرد التدريب، يكفي حقن وحدة نمذجة الحركة هذه لتتحول جميع الإصدارات الشخصية المشتقة من نفس النموذج الأساسي T2I بسهولة إلى نماذج يقودها النص، وتنتج صورًا متحركة متنوعة وشخصية. أجرينا تقييمنا على عدة نماذج عامة تمثيلية لنماذج النص إلى الصورة الشخصية عبر صور الأنمي والصور الفوتوغرافية الواقعية، وأثبتنا أن إطارنا المقترح يساعد هذه النماذج على توليد مقاطع متحركة سلسة زمنيًا مع الحفاظ على مجال مخرجاتها وتنوعها. ستكون الأوزان المدربة مسبقًا متاحة للعامة في [هذا الرابط https](https://animatediff.github.io/).*
## الخطوط الأنابيب المتاحة
| خط الأنابيب | المهام | العرض
|---|---|:---:|
| [AnimateDiffPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py) | *توليد الفيديو من النص باستخدام AnimateDiff* |
| [AnimateDiffControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py) | *توليد فيديو من فيديو مُتحكَّم به باستخدام AnimateDiff مع ControlNet* |
| [AnimateDiffSparseControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py) | *توليد فيديو إلى فيديو مُتحكَّم به باستخدام AnimateDiff مع SparseCtrl* |
| [AnimateDiffSDXLPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py) | *توليد فيديو من فيديو باستخدام AnimateDiff* |
| [AnimateDiffVideoToVideoPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py) | *توليد فيديو من فيديو باستخدام AnimateDiff* |
| [AnimateDiffVideoToVideoControlNetPipeline](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py) | *توليد فيديو من فيديو باستخدام AnimateDiff مع ControlNet* |
## نقاط التفتيش المتاحة
يمكن العثور على نقاط التفتيش الخاصة بمحوّل الحركة (Motion Adapter) تحت [guoyww](https://huggingface.co/guoyww/). صُممت هذه النقاط التفتيشية للعمل مع أي نموذج مبني على Stable Diffusion 1.4/1.5.
## مثال على الاستخدام
### AnimateDiffPipeline
يعمل AnimateDiff مع نقطة تحقق MotionAdapter ونقطة تحقق لنموذج Stable Diffusion. يتكون MotionAdapter من مجموعة من وحدات الحركة Motion Modules المسؤولة عن إضافة حركة متماسكة عبر إطارات الصور. تُطبَّق هذه الوحدات بعد كتل Resnet وAttention في UNet الخاص بـ Stable Diffusion.
يُظهر المثال التالي كيفية استخدام نقطة تحقق *MotionAdapter* مع Diffusers للاستدلال بناءً على StableDiffusion-1.4/1.5.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
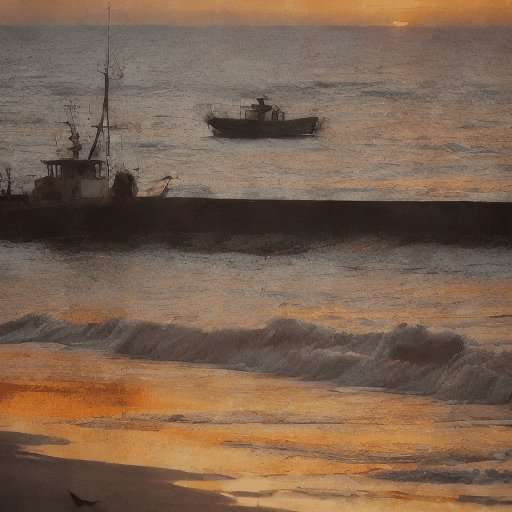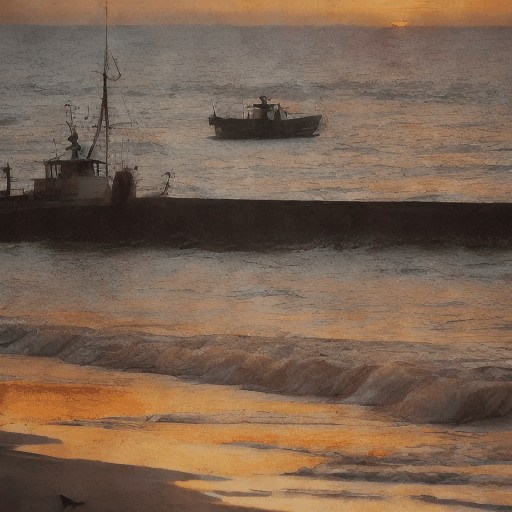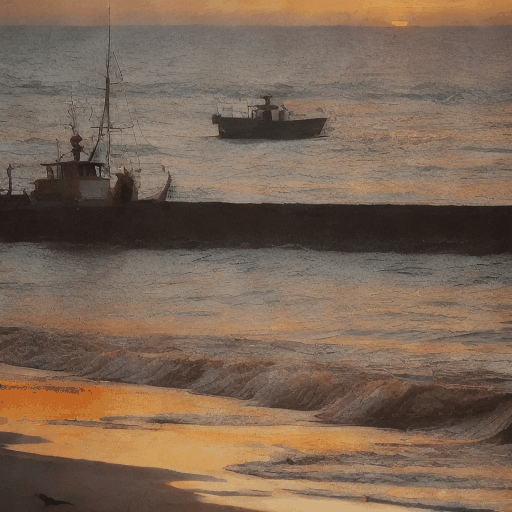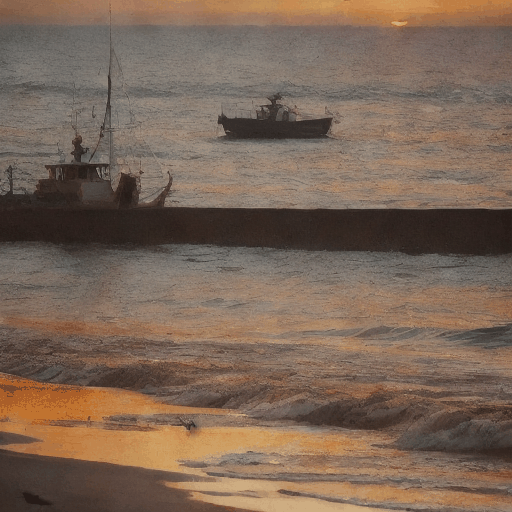
فيما يلي بعض المخرجات النموذجية:
تحفة فنية، أفضل جودة، غروب الشمس.
 > [!TIP]
> يميل AnimateDiff إلى العمل بشكل أفضل مع نماذج Stable Diffusion المُحسّنة. إذا كنت تخطط لاستخدام مُجدول (scheduler) قادر على قصّ العينات، فتأكد من تعطيله عن طريق تعيين `clip_sample=False` في المُجدول، لأن ذلك قد يؤثر سلبًا أيضًا على العينات المُولَّدة. بالإضافة إلى ذلك، قد تكون نقاط التفتيش (checkpoints) الخاصة بـ AnimateDiff حساسة لمخطط بيتا (beta schedule) الخاص بالمُجدول. ننصح بتعيينه إلى `linear`.
### AnimateDiffControlNetPipeline
يمكن أيضًا استخدام AnimateDiff مع ControlNets. تم تقديم ControlNet في [Adding Conditional Control to Text-to-Image Diffusion Models](https://huggingface.co/papers/2302.05543) بواسطة Lvmin Zhang وAnyi Rao وManeesh Agrawala. باستخدام نموذج ControlNet، يمكنك توفير صورة تحكم إضافية لتكييف وتحكم توليد Stable Diffusion. على سبيل المثال، إذا قمت بتوفير خرائط العمق، فإن نموذج ControlNet يولّد فيديو يحافظ على المعلومات المكانية من خرائط العمق. إنها طريقة أكثر مرونة ودقة للتحكم في عملية توليد الفيديو.
```python
import torch
from diffusers import AnimateDiffControlNetPipeline, AutoencoderKL, ControlNetModel, MotionAdapter, LCMScheduler
from diffusers.utils import export_to_gif, load_video
# Additionally, you will need a preprocess videos before they can be used with the ControlNet
# HF maintains just the right package for it: `pip install controlnet_aux`
from controlnet_aux.processor import ZoeDetector
# Download controlnets from https://huggingface.co/lllyasviel/ControlNet-v1-1 to use .from_single_file
# Download Diffusers-format controlnets, such as https://huggingface.co/lllyasviel/sd-controlnet-depth, to use .from_pretrained()
controlnet = ControlNetModel.from_single_file("control_v11f1p_sd15_depth.pth", dtype=torch.float16)
# We use AnimateLCM for this example but one can use the original motion adapters as well (for example, https://huggingface.co/guoyww/animatediff-motion-adapter-v1-5-3)
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=torch.float16)
pipe: AnimateDiffControlNetPipeline = AnimateDiffControlNetPipeline.from_pretrained(
"SG161222/Realistic_Vision_V5.1_noVAE",
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
).to(device="cuda", dtype=torch.float16) # or "mps", "xpu", "cpu"
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm-lora")
pipe.set_adapters(["lcm-lora"], [0.8])
depth_detector = ZoeDetector.from_pretrained("lllyasviel/Annotators").to("cuda")
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-vid2vid-input-1.gif")
conditioning_frames = []
with pipe.progress_bar(total=len(video)) as progress_bar:
for frame in video:
conditioning_frames.append(depth_detector(frame))
progress_bar.update()
prompt = "a panda, playing a guitar, sitting in a pink boat, in the ocean, mountains in background, realistic, high quality"
negative_prompt = "bad quality, worst quality"
video = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_frames=len(video),
num_inference_steps=10,
guidance_scale=2.0,
conditioning_frames=conditioning_frames,
generator=torch.Generator().manual_seed(42),
).frames[0]
export_to_gif(video, "animatediff_controlnet.gif", fps=8)
```
فيما يلي بعض المخرجات النموذجية:
فيديو المصدر
فيديو الإخراج
راكون يعزف على الغيتار
باندا، تعزف على الغيتار، جالسة في قارب وردي، في المحيط، جبال في الخلفية، واقعية، جودة عالية
### AnimateDiffSparseControlNetPipeline
[SparseCtrl: إضافة عناصر تحكم متناثرة إلى نماذج الانتشار من النص إلى الفيديو](https://huggingface.co/papers/2311.16933) لتحقيق التوليد المُتحكَّم به في نماذج الانتشار من النص إلى الفيديو، من إعداد يووي غو، وسيوان يانغ، أني راو، مانيش أغراوالا، داهوا لين، وبو داي.
ملخص الورقة البحثية هو:
*شهد تطوير النماذج التحويلية من النص إلى الفيديو (T2V)، أي توليد مقاطع فيديو بناءً على موجه نصي معيّن، تقدّمًا كبيرًا في السنوات الأخيرة. ومع ذلك، فإن الاعتماد حصريًا على الموجهات النصية غالبًا ما يؤدي إلى تكوين غامض للإطارات بسبب عدم اليقين المكاني. لذا، يستفيد مجتمع البحث من إشارات البنية الكثيفة، مثل تسلسلات العمق/الحواف لكل إطار، لتعزيز قابلية التحكم، مما يزيد بدوره من عبء الاستدلال. في هذا العمل، نقدّم SparseCtrl لتمكين التحكم المرن في البنية باستخدام إشارات متفرقة زمنيًا، حيث يتطلب الأمر إدخالًا واحدًا أو بضعة إدخالات فقط، كما هو موضح في الشكل 1. يتضمن هذا النموذج مشفّرًا إضافيًا للشروط لمعالجة هذه الإشارات المتفرقة مع إبقاء نموذج T2V المُدرَّب مسبقًا دون أي تعديل. يتوافق النهج المقترح مع أوضاع متعددة، بما في ذلك الرسومات التوضيحية، وخرائط العمق، والصور RGB، مما يوفر تحكمًا أكثر عملية في توليد الفيديو ويدفع تطبيقات مثل تخطيط اللوحات، وعرض العمق، وتحريك الإطارات المفتاحية، والاستيفاء. تُظهر التجارب الواسعة تعميم SparseCtrl على مولّدات T2V الأصلية والمخصصة على حد سواء. ستكون الأكواد والنماذج متاحة علنًا في [هذا الرابط](https://guoyww.github.io/projects/SparseCtrl).*
تُقدّم SparseCtrl نقاط التفتيش التالية لتوليد الفيديو من النص بشكل مُتحكَّم به:
- [SparseCtrl Scribble](https://huggingface.co/guoyww/animatediff-sparsectrl-scribble)
- [SparseCtrl RGB](https://huggingface.co/guoyww/animatediff-sparsectrl-rgb)
#### استخدام SparseCtrl Scribble
```python
import torch
from diffusers import AnimateDiffSparseControlNetPipeline
from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
from diffusers.schedulers import DPMSolverMultistepScheduler
from diffusers.utils import export_to_gif, load_image
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
controlnet_id = "guoyww/animatediff-sparsectrl-scribble"
lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
vae_id = "stabilityai/sd-vae-ft-mse"
device = "cuda" # or "mps", "xpu", "cpu"
motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, dtype=torch.float16).to(device)
controlnet = SparseControlNetModel.from_pretrained(controlnet_id, dtype=torch.float16).to(device)
vae = AutoencoderKL.from_pretrained(vae_id, dtype=torch.float16).to(device)
scheduler = DPMSolverMultistepScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
algorithm_type="dpmsolver++",
use_karras_sigmas=True,
)
pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
model_id,
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
scheduler=scheduler,
dtype=torch.float16,
).to(device)
pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
pipe.fuse_lora(lora_scale=1.0)
prompt = "an aerial view of a cyberpunk city, night time, neon lights, masterpiece, high quality"
negative_prompt = "low quality, worst quality, letterboxed"
image_files = [
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-1.png",
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-2.png",
"https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-3.png"
]
condition_frame_indices = [0, 8, 15]
conditioning_frames = [load_image(img_file) for img_file in image_files]
video = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_inference_steps=25,
conditioning_frames=conditioning_frames,
controlnet_conditioning_scale=1.0,
controlnet_frame_indices=condition_frame_indices,
generator=torch.Generator().manual_seed(1337),
).frames[0]
export_to_gif(video, "output.gif")
```
فيما يلي بعض المخرجات النموذجية:
منظر جوي لمدينة سايبربانك، وقت الليل، أضواء نيون، تحفة فنية، جودة عالية
#### استخدام SparseCtrl RGB
```python
import torch
from diffusers import AnimateDiffSparseControlNetPipeline
from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
from diffusers.schedulers import DPMSolverMultistepScheduler
from diffusers.utils import export_to_gif, load_image
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
controlnet_id = "guoyww/animatediff-sparsectrl-rgb"
lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
vae_id = "stabilityai/sd-vae-ft-mse"
device = "cuda" # or "mps", "xpu", "cpu"
motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, dtype=torch.float16).to(device)
controlnet = SparseControlNetModel.from_pretrained(controlnet_id, dtype=torch.float16).to(device)
vae = AutoencoderKL.from_pretrained(vae_id, dtype=torch.float16).to(device)
scheduler = DPMSolverMultistepScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
algorithm_type="dpmsolver++",
use_karras_sigmas=True,
)
pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
model_id,
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
scheduler=scheduler,
dtype=torch.float16,
).to(device)
pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-firework.png")
video = pipe(
prompt="closeup face photo of man in black clothes, night city street, bokeh, fireworks in background",
negative_prompt="low quality, worst quality",
num_inference_steps=25,
conditioning_frames=image,
controlnet_frame_indices=[0],
controlnet_conditioning_scale=1.0,
generator=torch.Generator().manual_seed(42),
).frames[0]
export_to_gif(video, "output.gif")
```
فيما يلي بعض المخرجات النموذجية:
لقطة قريبة لوجه رجل يرتدي ملابس سوداء، شارع مدينة ليلاً، تأثير ضبابي، ألعاب نارية في الخلفية
### AnimateDiffSDXLPipeline
يمكن أيضًا استخدام AnimateDiff مع نماذج SDXL. هذه ميزة تجريبية حاليًا حيث يتوفر إصدار بيتا فقط من نقطة التفتيش لمحوّك الحركة.
```python
import torch
from diffusers.models import MotionAdapter
from diffusers import AnimateDiffSDXLPipeline, DDIMScheduler
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-sdxl-beta", dtype=torch.float16)
model_id = "stabilityai/stable-diffusion-xl-base-1.0"
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe = AnimateDiffSDXLPipeline.from_pretrained(
model_id,
motion_adapter=adapter,
scheduler=scheduler,
dtype=torch.float16,
variant="fp16",
).to("cuda") # or "mps", "xpu", "cpu"
# enable memory savings
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()
output = pipe(
prompt="a panda surfing in the ocean, realistic, high quality",
negative_prompt="low quality, worst quality",
num_inference_steps=20,
guidance_scale=8,
width=1024,
height=1024,
num_frames=16,
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
### AnimateDiffVideoToVideoPipeline
يمكن أيضًا استخدام AnimateDiff لتوليد مقاطع فيديو متشابهة بصريًا أو لتفعيل تعديلات على الأسلوب أو الشخصية أو الخلفية أو غيرها انطلاقًا من مقطع فيديو أولي، مما يتيح لك استكشاف الإمكانات الإبداعية بسلاسة.
```python
import imageio
import requests
import torch
from diffusers import AnimateDiffVideoToVideoPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
from io import BytesIO
from PIL import Image
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffVideoToVideoPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
# helper function to load videos
def load_video(file_path: str):
images = []
if file_path.startswith(('http://', 'https://')):
# If the file_path is a URL
response = requests.get(file_path)
response.raise_for_status()
content = BytesIO(response.content)
vid = imageio.get_reader(content)
else:
# Assuming it's a local file path
vid = imageio.get_reader(file_path)
for frame in vid:
pil_image = Image.fromarray(frame)
images.append(pil_image)
return images
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-vid2vid-input-1.gif")
output = pipe(
video = video,
prompt="panda playing a guitar, on a boat, in the ocean, high quality",
negative_prompt="bad quality, worse quality",
guidance_scale=7.5,
num_inference_steps=25,
strength=0.5,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
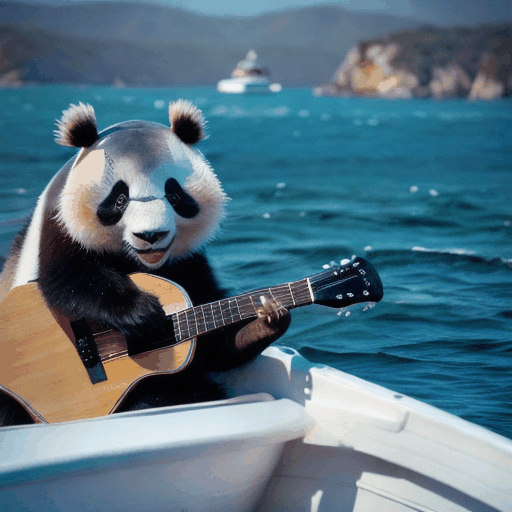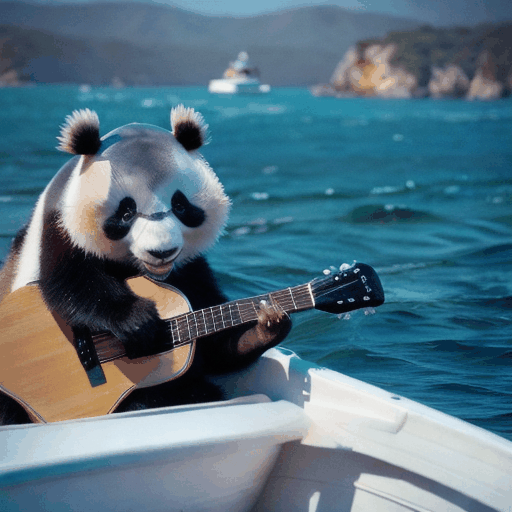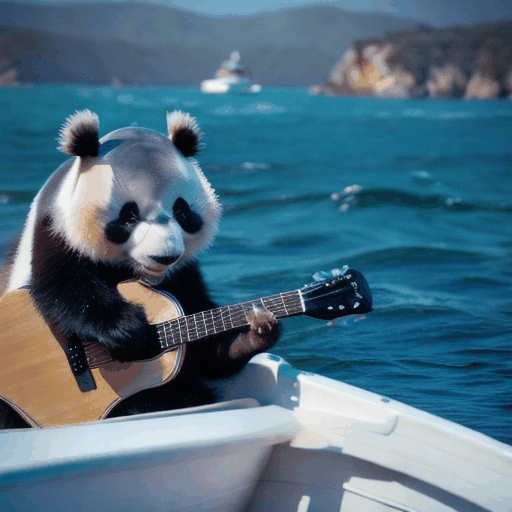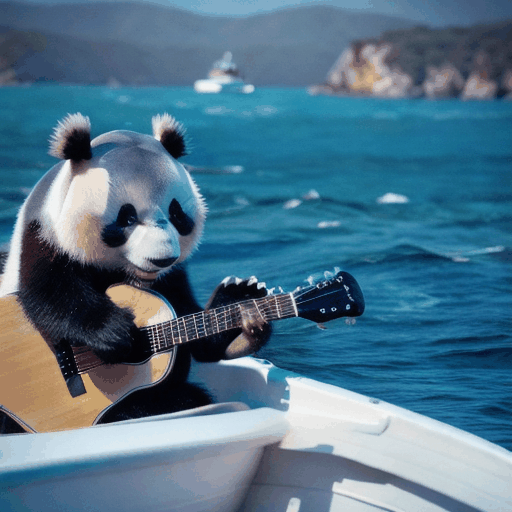
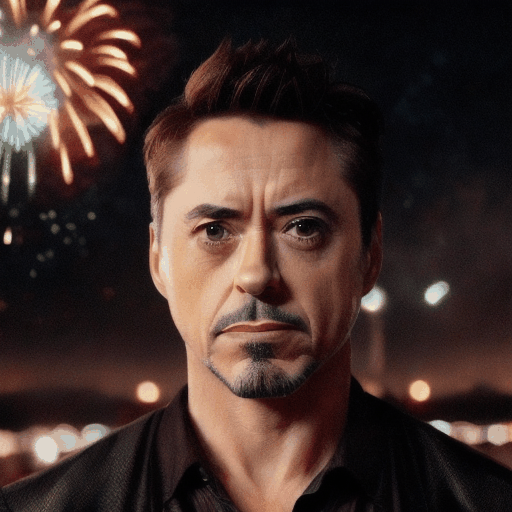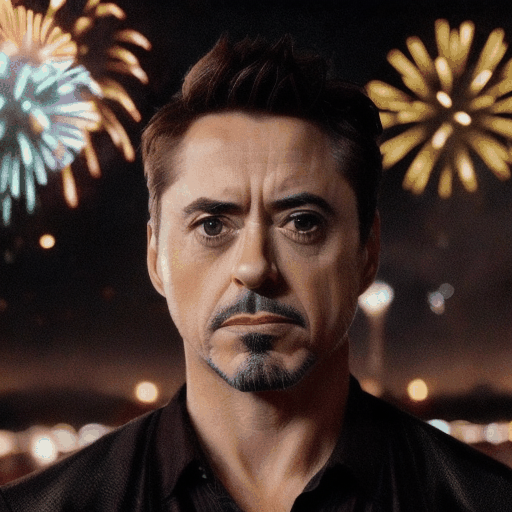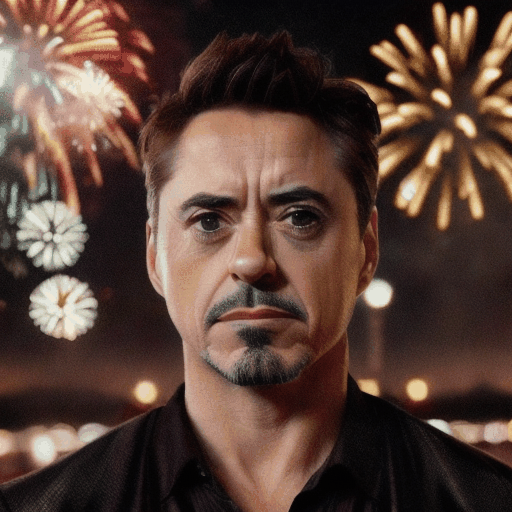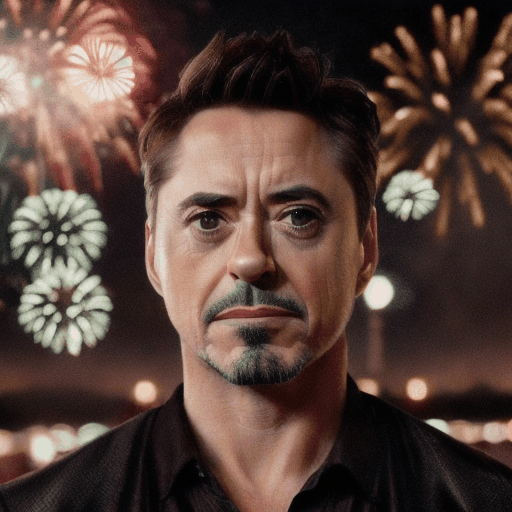
فيما يلي بعض المخرجات النموذجية:
فيديو المصدر
فيديو الإخراج
راكون يعزف على الغيتار
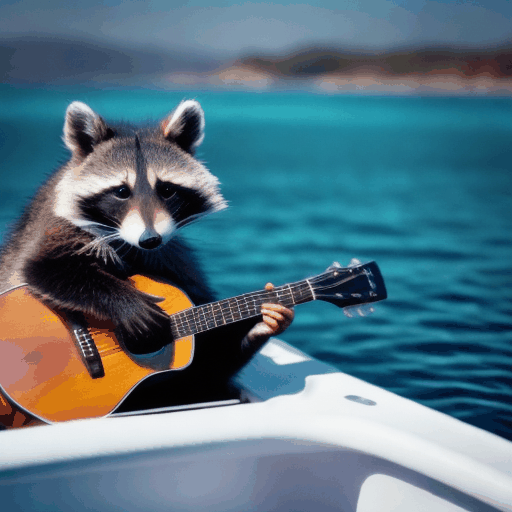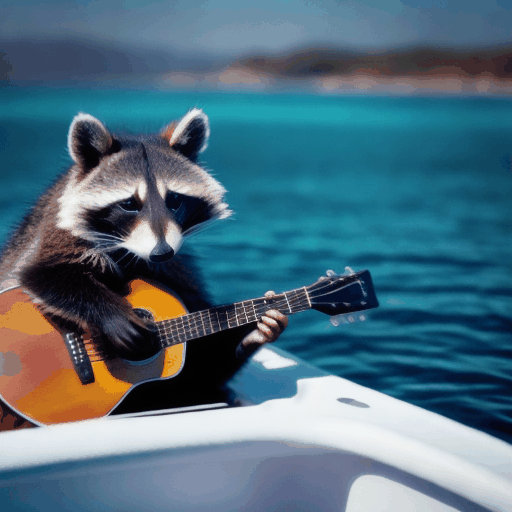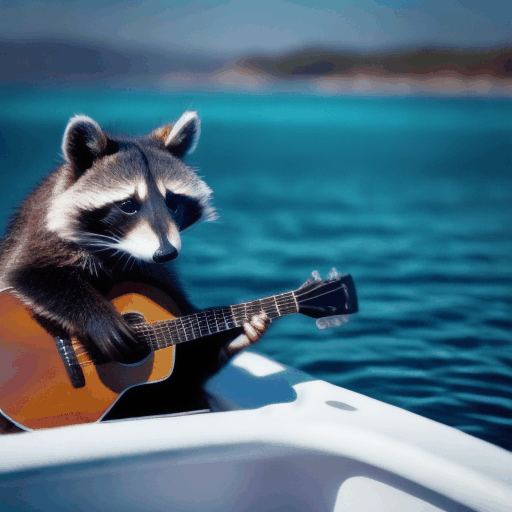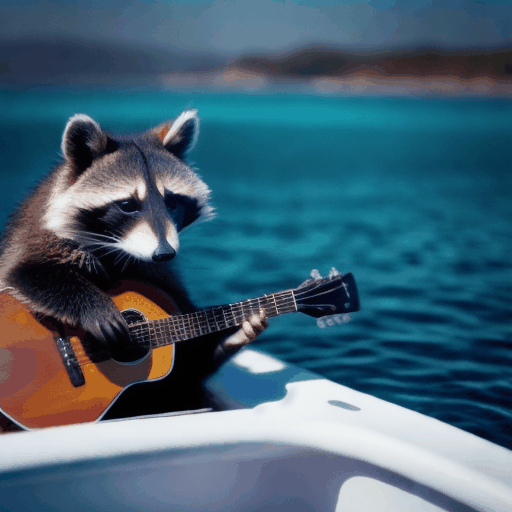 باندا تعزف على الغيتار
 لقطة مقرّبة لمارجوت روبي، ألعاب نارية في الخلفية، جودة عالية
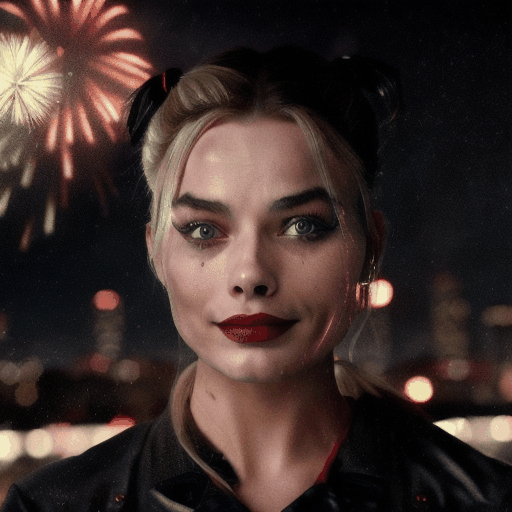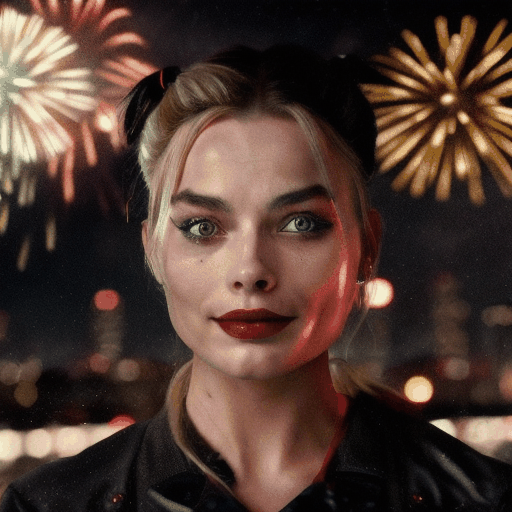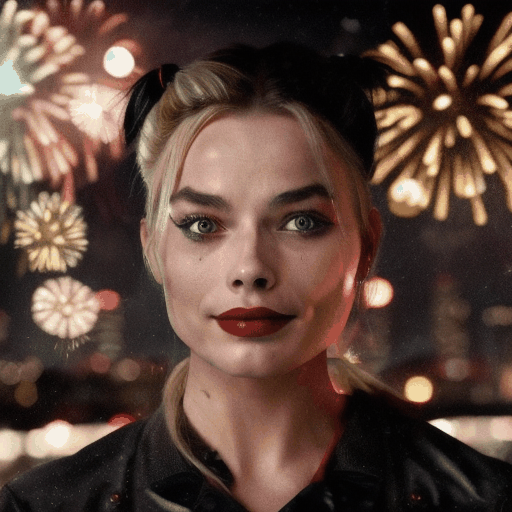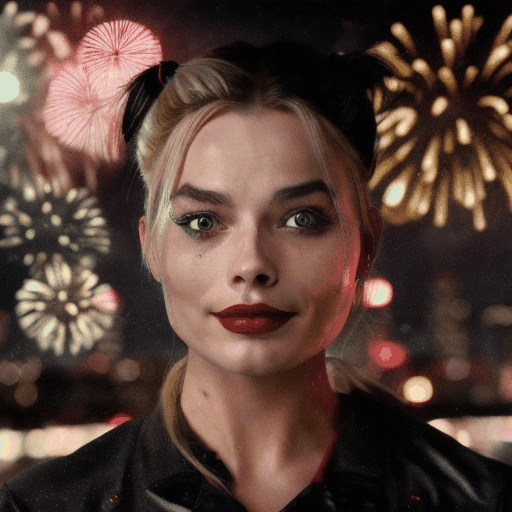 لقطة مقرّبة لـ توني ستارك، روبرت داوني جونيور، ألعاب نارية
 ### AnimateDiffVideoToVideoControlNetPipeline
يمكن استخدام AnimateDiff مع ControlNets لتعزيز توليد الفيديو من الفيديو من خلال السماح بالتحكم الدقيق في المخرجات. تم تقديم ControlNet في [Adding Conditional Control to Text-to-Image Diffusion Models](https://huggingface.co/papers/2302.05543) بواسطة Lvmin Zhang وAnyi Rao وManeesh Agrawala، ويتيح لك ضبط Stable Diffusion باستخدام صورة تحكم إضافية للتأكد من الحفاظ على المعلومات المكانية طوال الفيديو.
يتيح لك هذا الخط أن تشترط توليدك على الفيديو الأصلي وعلى تسلسل من صور التحكم.
```python
import torch
from PIL import Image
from tqdm.auto import tqdm
from controlnet_aux.processor import OpenposeDetector
from diffusers import AnimateDiffVideoToVideoControlNetPipeline
from diffusers.utils import export_to_gif, load_video
from diffusers import AutoencoderKL, ControlNetModel, MotionAdapter, LCMScheduler
# Load the ControlNet
controlnet = ControlNetModel.from_pretrained("lllyasviel/sd-controlnet-openpose", dtype=torch.float16)
# Load the motion adapter
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
# Load SD 1.5 based finetuned model
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=torch.float16)
pipe = AnimateDiffVideoToVideoControlNetPipeline.from_pretrained(
"SG161222/Realistic_Vision_V5.1_noVAE",
motion_adapter=motion_adapter,
controlnet=controlnet,
vae=vae,
).to(device="cuda", dtype=torch.float16) # or "mps", "xpu", "cpu"
# Enable LCM to speed up inference
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm-lora")
pipe.set_adapters(["lcm-lora"], [0.8])
video = load_video("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/dance.gif")
video = [frame.convert("RGB") for frame in video]
prompt = "astronaut in space, dancing"
negative_prompt = "bad quality, worst quality, jpeg artifacts, ugly"
# Create controlnet preprocessor
open_pose = OpenposeDetector.from_pretrained("lllyasviel/Annotators").to("cuda")
# Preprocess controlnet images
conditioning_frames = []
for frame in tqdm(video):
conditioning_frames.append(open_pose(frame))
strength = 0.8
with torch.inference_mode():
video = pipe(
video=video,
prompt=prompt,
negative_prompt=negative_prompt,
num_inference_steps=10,
guidance_scale=2.0,
controlnet_conditioning_scale=0.75,
conditioning_frames=conditioning_frames,
strength=strength,
generator=torch.Generator().manual_seed(42),
).frames[0]
video = [frame.resize(conditioning_frames[0].size) for frame in video]
export_to_gif(video, f"animatediff_vid2vid_controlnet.gif", fps=8)
```
فيما يلي بعض المخرجات النموذجية:
الفيديو المصدر
الفيديو الناتج
فتاة أنمي، ترقص
رائد فضاء في الفضاء، يرقص
**تم نقل الإضاءة والتكوين من الفيديو المصدر.**
## استخدام Motion LoRAs
تُعد LoRAs الحركية مجموعة من LoRAs تعمل مع نقطة الفحص `guoyww/animatediff-motion-adapter-v1-5-2`. وتتكفل هذه LoRAs بإضافة أنواع محددة من الحركة إلى الرسوم المتحركة.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
pipe.load_lora_weights(
"guoyww/animatediff-motion-lora-zoom-out", adapter_name="zoom-out"
)
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
beta_schedule="linear",
timestep_spacing="linspace",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
تحفة فنية، أفضل جودة، غروب الشمس.
 ## استخدام Motion LoRAs مع PEFT
يمكنك أيضًا الاستفادة من واجهة [PEFT](https://github.com/huggingface/peft) الخلفية لدمج Motion LoRA وإنشاء حركات أكثر تعقيدًا.
قم أولاً بتثبيت PEFT باستخدام
```shell
pip install peft
```
ثم يمكنك استخدام الكود التالي لدمج Motion LoRAs.
```python
import torch
from diffusers import AnimateDiffPipeline, DDIMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
# Load the motion adapter
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2", dtype=torch.float16)
# load SD 1.5 based finetuned model
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16)
pipe.load_lora_weights(
"diffusers/animatediff-motion-lora-zoom-out", adapter_name="zoom-out",
)
pipe.load_lora_weights(
"diffusers/animatediff-motion-lora-pan-left", adapter_name="pan-left",
)
pipe.set_adapters(["zoom-out", "pan-left"], adapter_weights=[1.0, 1.0])
scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
clip_sample=False,
timestep_spacing="linspace",
beta_schedule="linear",
steps_offset=1,
)
pipe.scheduler = scheduler
# enable memory savings
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt=(
"masterpiece, bestquality, highlydetailed, ultradetailed, sunset, "
"orange sky, warm lighting, fishing boats, ocean waves seagulls, "
"rippling water, wharf, silhouette, serene atmosphere, dusk, evening glow, "
"golden hour, coastal landscape, seaside scenery"
),
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=25,
generator=torch.Generator("cpu").manual_seed(42),
)
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
تحفة فنية، أفضل جودة، غروب الشمس.
 ## استخدام FreeInit
[FreeInit: سد فجوة التهيئة في نماذج الانتشار للفيديو](https://huggingface.co/papers/2312.07537) بقلم Tianxing Wu و Chenyang Si و Yuming Jiang و Ziqi Huang و Ziwei Liu.
تُعد FreeInit طريقة فعّالة تحسّن الاتساق الزمني والجودة الإجمالية للفيديوهات المولّدة باستخدام نماذج الانتشار للفيديو دون أي تدريب إضافي. يمكن تطبيقها بسلاسة في وقت الاستدلال على AnimateDiff وModelScope وVideoCrafter ونماذج توليد الفيديو الأخرى المختلفة، وتعمل من خلال تحسين ضوضاء تهيئة الكمون بشكل تكراري. يمكن العثور على مزيد من التفاصيل في الورقة البحثية.
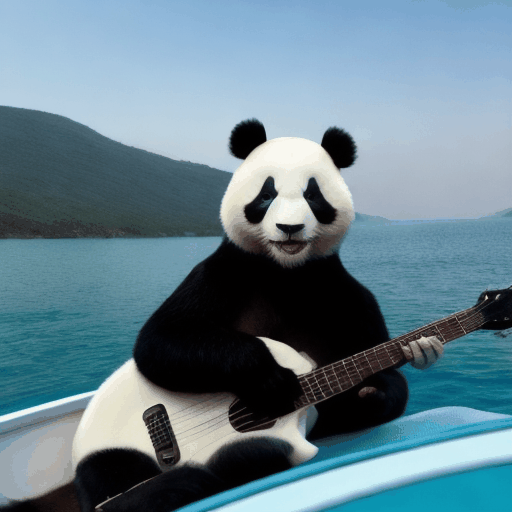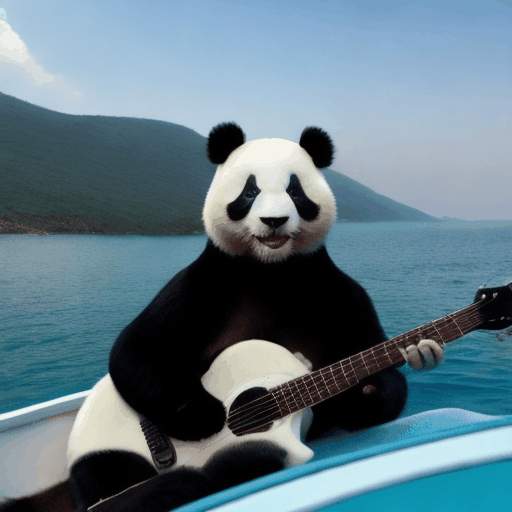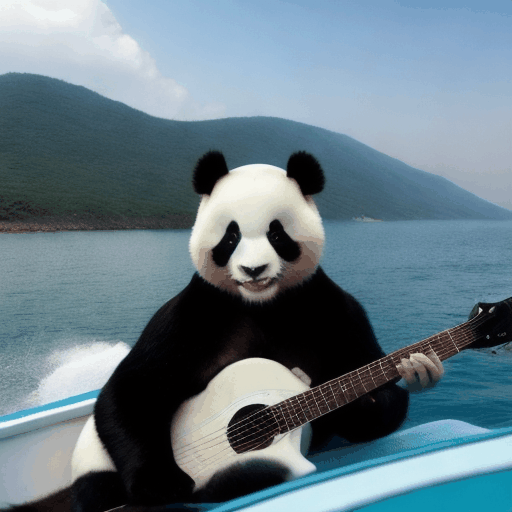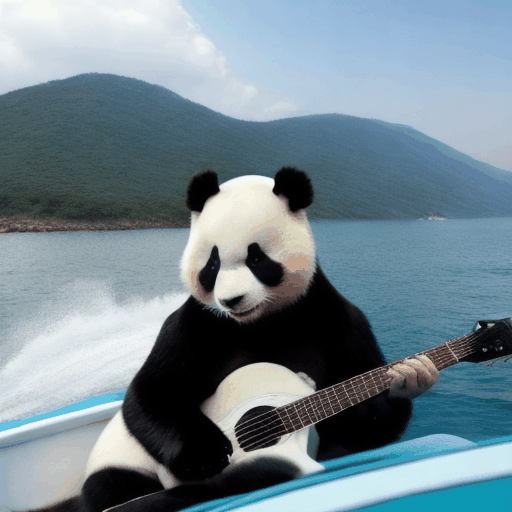
يُظهر المثال التالي طريقة استخدام FreeInit.
```python
import torch
from diffusers import MotionAdapter, AnimateDiffPipeline, DDIMScheduler
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2")
model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
pipe = AnimateDiffPipeline.from_pretrained(model_id, motion_adapter=adapter, dtype=torch.float16).to("cuda") # or "mps", "xpu", "cpu"
pipe.scheduler = DDIMScheduler.from_pretrained(
model_id,
subfolder="scheduler",
beta_schedule="linear",
clip_sample=False,
timestep_spacing="linspace",
steps_offset=1
)
# enable memory savings
pipe.vae.enable_slicing()
pipe.vae.enable_tiling()
# enable FreeInit
# Refer to the enable_free_init documentation for a full list of configurable parameters
pipe.enable_free_init(method="butterworth", use_fast_sampling=True)
# run inference
output = pipe(
prompt="a panda playing a guitar, on a boat, in the ocean, high quality",
negative_prompt="bad quality, worse quality",
num_frames=16,
guidance_scale=7.5,
num_inference_steps=20,
generator=torch.Generator("cpu").manual_seed(666),
)
# disable FreeInit
pipe.disable_free_init()
frames = output.frames[0]
export_to_gif(frames, "animation.gif")
```
> [!WARNING]
> FreeInit ليست مجانيةً بالمعنى الحرفي - فالجودة المحسّنة تأتي على حساب حسابات إضافية. فهي تتطلب أخذ عينات عدة مرات إضافية اعتمادًا على معامل `num_iters` الذي يتم ضبطه عند تفعيلها. يمكن أن يؤدي ضبط معامل `use_fast_sampling` على `True` إلى تحسين الأداء العام (على حساب جودة أقل مقارنةً بحالة `use_fast_sampling=False`، لكن النتائج لا تزال أفضل من نماذج توليد الفيديو العادية).
> [!TIP]
> تأكد من الاطلاع على [دليل المجدولين](../../using-diffusers/schedulers) لمعرفة كيفية استكشاف التوازن بين سرعة المجدول وجودة النتائج، واطّلع على قسم [إعادة استخدام المكونات عبر خطوط الأنابيب](../../using-diffusers/loading#reusing-models-in-multiple-pipelines) لمعرفة كيفية تحميل نفس المكونات بكفاءة في خطوط أنابيب متعددة.
بدون تفعيل FreeInit مع تفعيل FreeInit
باندا تعزف على الغيتار
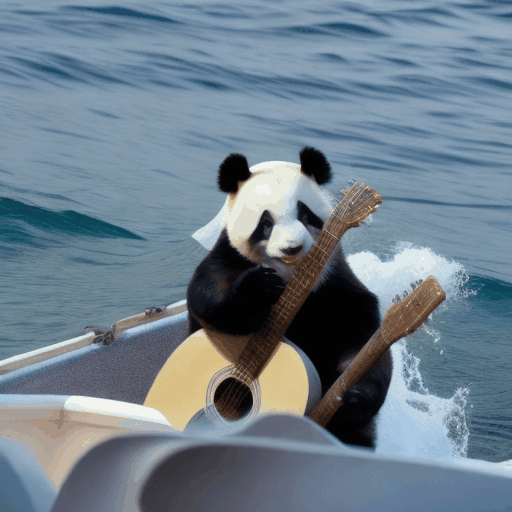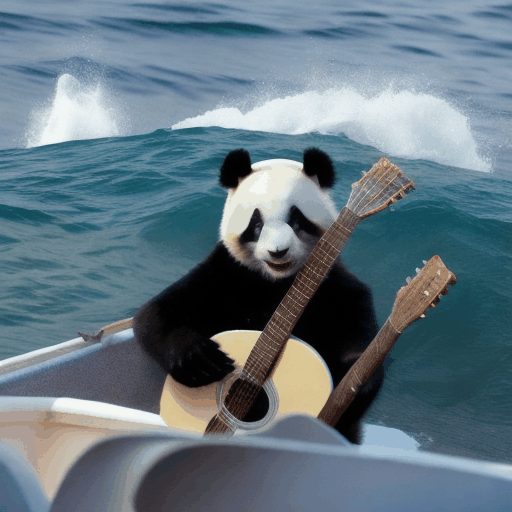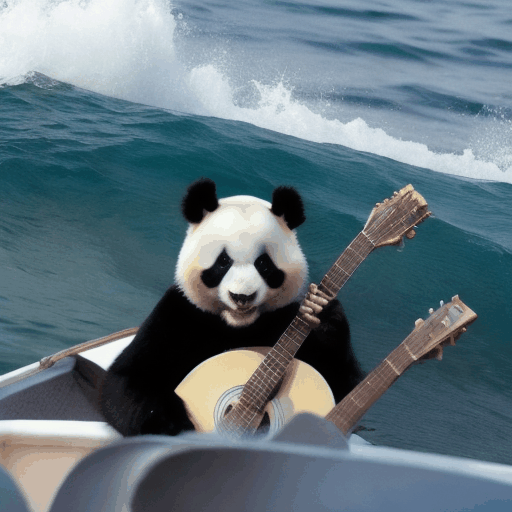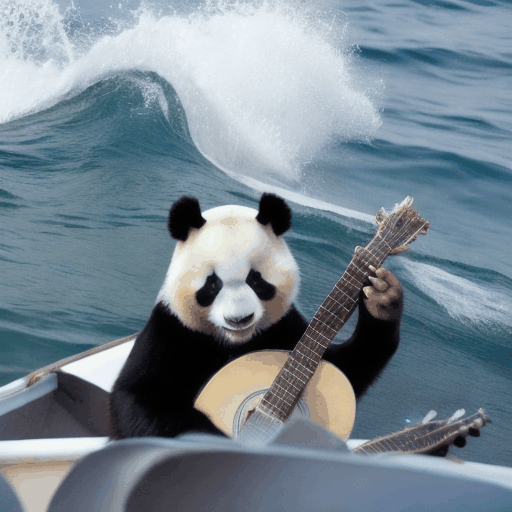 باندا تعزف على الغيتار
 ## استخدام AnimateLCM
[AnimateLCM](https://animatelcm.github.io/) هو نقطة تحقق (checkpoint) لنموذج الحركة و[LCM LoRA](https://huggingface.co/docs/diffusers/using-diffusers/inference_with_lcm_lora) تم إنشاؤهما باستخدام استراتيجية تعلّم الاتساق تفصل بين تقطير مسبق توليد الصور ومسبق توليد الحركة.
```python
import torch
from diffusers import AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="sd15_lora_beta.safetensors", adapter_name="lcm-lora")
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt="A space rocket with trails of smoke behind it launching into space from the desert, 4k, high resolution",
negative_prompt="bad quality, worse quality, low resolution",
num_frames=16,
guidance_scale=1.5,
num_inference_steps=6,
generator=torch.Generator("cpu").manual_seed(0),
)
frames = output.frames[0]
export_to_gif(frames, "animatelcm.gif")
```
صاروخ فضائي، بدقة 4K.
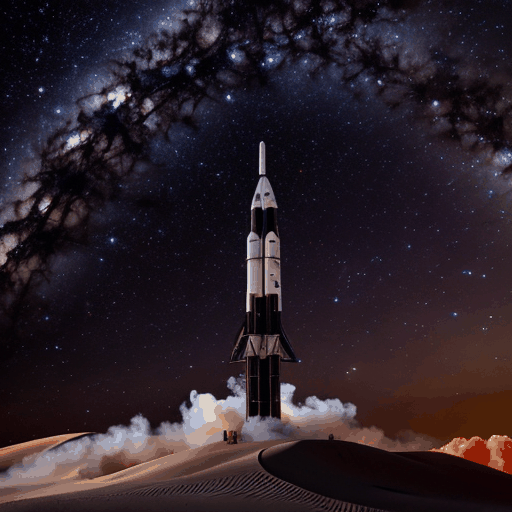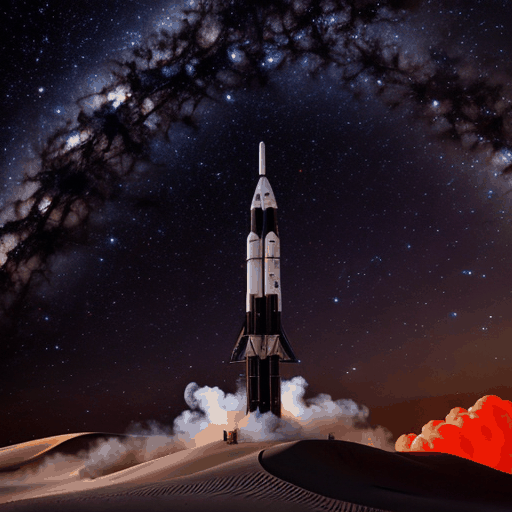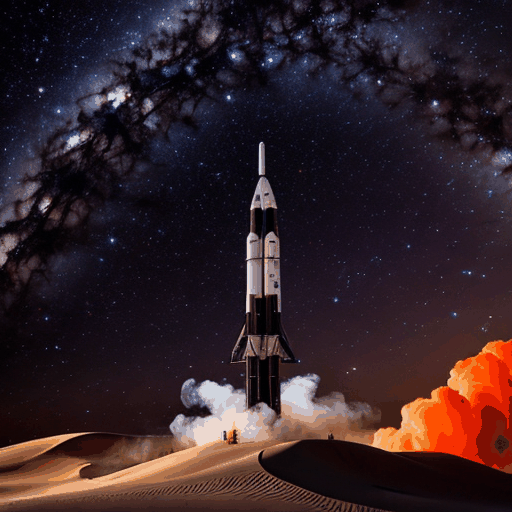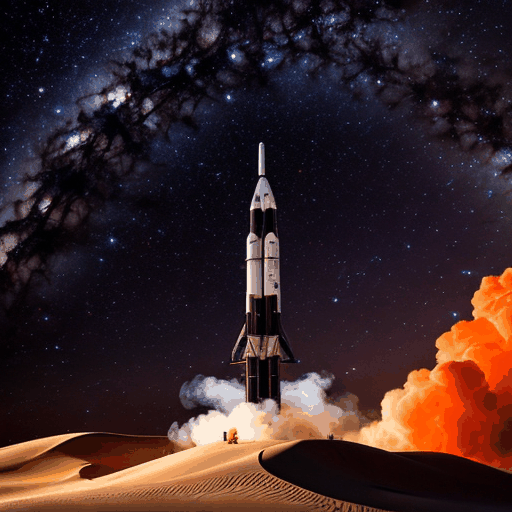 يتوافق AnimateLCM أيضًا مع [LoRAs الحركة](https://huggingface.co/collections/dn6/animatediff-motion-loras-654cb8ad732b9e3cf4d3c17e) الموجودة مسبقًا.
```python
import torch
from diffusers import AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_gif
adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM")
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights("wangfuyun/AnimateLCM", weight_name="sd15_lora_beta.safetensors", adapter_name="lcm-lora")
pipe.load_lora_weights("guoyww/animatediff-motion-lora-tilt-up", adapter_name="tilt-up")
pipe.set_adapters(["lcm-lora", "tilt-up"], [1.0, 0.8])
pipe.vae.enable_slicing()
pipe.enable_model_cpu_offload()
output = pipe(
prompt="A space rocket with trails of smoke behind it launching into space from the desert, 4k, high resolution",
negative_prompt="bad quality, worse quality, low resolution",
num_frames=16,
guidance_scale=1.5,
num_inference_steps=6,
generator=torch.Generator("cpu").manual_seed(0),
)
frames = output.frames[0]
export_to_gif(frames, "animatelcm-motion-lora.gif")
```
صاروخ فضائي، بدقة 4K.
 ## استخدام FreeNoise
[FreeNoise: توليف فيديو أطول بدون ضبط عبر إعادة جدولة الضوضاء](https://huggingface.co/papers/2310.15169) بقلم هاونان تشيو، منغهان شيا، يونغ تشانغ، ينغتشينغ هه، شينتاو وانغ، ينغ شان، زيوي ليو.
FreeNoise هو آلية أخذ عينات يمكنها توليد مقاطع فيديو أطول باستخدام نماذج توليد مقاطع الفيديو القصيرة، وذلك من خلال إعادة جدولة الضوضاء، والانتباه الزمني عبر النوافذ المنزلقة، والمتوسط المرجح للإطارات الكامنة. كما يمكن استخدامه مع عدة موجهات (prompts) للسماح بتوليد مقاطع فيديو مستوفاة (interpolated). تتوفر مزيد من التفاصيل في الورقة البحثية.
خطوط أنابيب AnimateDiff المدعومة حاليًا والتي يمكن استخدامها مع FreeNoise هي:
- [AnimateDiffPipeline](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.AnimateDiffPipeline)
- [AnimateDiffControlNetPipeline](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.AnimateDiffControlNetPipeline)
- [AnimateDiffVideoToVideoPipeline](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.AnimateDiffVideoToVideoPipeline)
- [AnimateDiffVideoToVideoControlNetPipeline](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.AnimateDiffVideoToVideoControlNetPipeline)
للاستفادة من FreeNoise، يجب إضافة سطر واحد إلى كود الاستدلال بعد تحميل خطوط الأنابيب الخاصة بك.
```diff
+ pipe.enable_free_noise()
```
بعد ذلك، يمكن استخدام موجه واحد، أو تمرير موجهات متعددة على شكل قاموس من أزواج عدد صحيح-نص. تتوافق مفاتيح العدد الصحيح في القاموس مع فهرس الإطار الذي تكون فيه تأثير ذلك الموجه في أقصى حالاته. يجب أن يتطابق كل فهرس إطار مع موجه نصي واحد. يتم إنشاء الموجهات لفهارس الإطارات الوسيطة، التي لم يتم تمريرها في القاموس، عن طريق الاستيفاء بين موجهات الإطارات التي تم تمريرها. افتراضيًا، يتم استخدام الاستيفاء الخطي البسيط. ومع ذلك، يمكنك تخصيص هذا السلوك باستخدام استدعاء غير متزامن (callback) إلى معامل `prompt_interpolation_callback` عند تفعيل FreeNoise.
مثال كامل:
```python
import torch
from diffusers import AutoencoderKL, AnimateDiffPipeline, LCMScheduler, MotionAdapter
from diffusers.utils import export_to_video, load_image
# Load pipeline
dtype = torch.float16
motion_adapter = MotionAdapter.from_pretrained("wangfuyun/AnimateLCM", dtype=dtype)
vae = AutoencoderKL.from_pretrained("stabilityai/sd-vae-ft-mse", dtype=dtype)
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=motion_adapter, vae=vae, dtype=dtype)
pipe.scheduler = LCMScheduler.from_config(pipe.scheduler.config, beta_schedule="linear")
pipe.load_lora_weights(
"wangfuyun/AnimateLCM", weight_name="AnimateLCM_sd15_t2v_lora.safetensors", adapter_name="lcm_lora"
)
pipe.set_adapters(["lcm_lora"], [0.8])
# Enable FreeNoise for long prompt generation
pipe.enable_free_noise(context_length=16, context_stride=4)
pipe.to("cuda") # or "mps", "xpu", "cpu"
# Can be a single prompt, or a dictionary with frame timesteps
prompt = {
0: "A caterpillar on a leaf, high quality, photorealistic",
40: "A caterpillar transforming into a cocoon, on a leaf, near flowers, photorealistic",
80: "A cocoon on a leaf, flowers in the background, photorealistic",
120: "A cocoon maturing and a butterfly being born, flowers and leaves visible in the background, photorealistic",
160: "A beautiful butterfly, vibrant colors, sitting on a leaf, flowers in the background, photorealistic",
200: "A beautiful butterfly, flying away in a forest, photorealistic",
240: "A cyberpunk butterfly, neon lights, glowing",
}
negative_prompt = "bad quality, worst quality, jpeg artifacts"
# Run inference
output = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
num_frames=256,
guidance_scale=2.5,
num_inference_steps=10,
generator=torch.Generator("cpu").manual_seed(0),
)
# Save video
frames = output.frames[0]
export_to_video(frames, "output.mp4", fps=16)
```
### توفيرات ذاكرة FreeNoise
بما أن FreeNoise يعالج عدة إطارات معًا، فهناك أجزاء في النموذج حيث يتجاوز الذاكرة المطلوبة ما هو متاح على وحدات معالجة الرسومات الاستهلاكية العادية. وقد حددنا أن الاختناقات الرئيسية في الذاكرة هي كتل الانتباه المكاني والزمني، وكتل رفع العينة وخفض العينة، وكتل resnet، وطبقات التغذية الأمامية. وبما أن معظم هذه الكتل تعمل بشكل فعال على بُعد القناة/التمثيل فقط، يمكن إجراء الاستدلال المقسّم عبر أبعاد الدفعة. بُعد الدفعة في AnimateDiff إما مكاني (`[B x F, H x W, C]`) أو زمني (`B x H x W, F, C`) بطبيعته (لاحظ أنه قد يبدو هذا عكس الحدس، لكن أبعاد الدفعة هنا صحيحة، لأن الكتل المكانية تعالج عبر بُعد `B x F` بينما تعالج الكتل الزمنية عبر بُعد `B x H x W`). نقدم `SplitInferenceModule` الذي يسهّل التقسيم عبر أي بُعد وإجراء الاستدلال. وهذا يوفر الكثير من الذاكرة، لكنه يأتي على حساب الحاجة إلى وقت أطول للاستدلال.
```diff
# Load pipeline and adapters
# ...
+ pipe.enable_free_noise_split_inference()
+ pipe.unet.enable_forward_chunking(16)
```
يقبل استدعاء طريقة `pipe.enable_free_noise_split_inference` معاملين: `spatial_split_size` (القيمة الافتراضية هي `256`) و`temporal_split_size` (القيمة الافتراضية هي `16`). يمكن ضبط هذه القيم بناءً على كمية ذاكرة VRAM المتاحة لديك. يؤدي حجم تقسيم أصغر إلى استخدام أقل للذاكرة ولكن إلى استنتاج أبطأ، في حين يؤدي حجم تقسيم أكبر إلى استنتاج أسرع على حساب استهلاك المزيد من الذاكرة.
## استخدام `from_single_file` مع MotionAdapter
يدعم `diffusers>=0.30.0` تحميل نقاط التفتيش الخاصة بـ AnimateDiff إلى `MotionAdapter` بصيغتها الأصلية عبر `from_single_file`
```python
from diffusers import MotionAdapter
ckpt_path = "https://huggingface.co/Lightricks/LongAnimateDiff/blob/main/lt_long_mm_32_frames.ckpt"
adapter = MotionAdapter.from_single_file(ckpt_path, dtype=torch.float16)
pipe = AnimateDiffPipeline.from_pretrained("emilianJR/epiCRealism", motion_adapter=adapter)
```
## AnimateDiffPipeline[[diffusers.AnimateDiffPipeline]]
#### diffusers.AnimateDiffPipeline[[diffusers.AnimateDiffPipeline]]
```python
diffusers.AnimateDiffPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L78)
**المعاملات:**
vae ([AutoencoderKL](/docs/diffusers/main/ar/api/models/autoencoderkl#diffusers.AutoencoderKL)) : نموذج الترميز التحويلي التبايني (VAE) لتشفير وفك تشفير الصور إلى تمثيلات كامنة ومنها.
text_encoder (`CLIPTextModel`) : مُشفِّر نص ثابت ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) لتجزئة النص.
unet ([UNet2DConditionModel](/docs/diffusers/main/ar/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : نموذج [UNet2DConditionModel](/docs/diffusers/main/ar/api/models/unet2d-cond#diffusers.UNet2DConditionModel) يُستخدم لإنشاء UNetMotionModel لإزالة الضوضاء من كائنات الفيديو المُرمّزة.
motion_adapter (`MotionAdapter`) : مُكيّف حركة `MotionAdapter` يُستخدم بالاقتران مع `unet` لإزالة الضوضاء من كامنات الفيديو المُرمّزة.
scheduler ([SchedulerMixin](/docs/diffusers/main/ar/api/schedulers/overview#diffusers.SchedulerMixin)) : مُجدول يُستخدم بالاقتران مع `unet` لإزالة الضوضاء من كائنات الصورة المُرمّزة. يمكن أن يكون أحد [DDIMScheduler](/docs/diffusers/main/ar/api/schedulers/ddim#diffusers.DDIMScheduler) أو [LMSDiscreteScheduler](/docs/diffusers/main/ar/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) أو [PNDMScheduler](/docs/diffusers/main/ar/api/schedulers/pndm#diffusers.PNDMScheduler).
خط أنابيب لتوليد الفيديو من النص.
يرث هذا النموذج من [DiffusionPipeline](/docs/diffusers/main/ar/api/pipelines/overview#diffusers.DiffusionPipeline). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة المُنفَّذة لجميع خطوط الأنابيب (التنزيل، الحفظ، التشغيل على جهاز معين، إلخ).
تورث خط الأنابيب أيضًا طرق التحميل التالية:
- [load_textual_inversion()](/docs/diffusers/main/ar/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) لتحميل تضمينات الانعكاس النصي
- [load_lora_weights()](/docs/diffusers/main/ar/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) لتحميل أوزان LoRA
- [save_lora_weights()](/docs/diffusers/main/ar/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) لحفظ أوزان LoRA
- [load_ip_adapter()](/docs/diffusers/main/ar/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) لتحميل وحدات IP Adapter
#### __call__[[diffusers.AnimateDiffPipeline.__call__]]
```python
__call__(prompt: str | list[str] | None = None, num_frames: int | None = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'], decode_chunk_size: int = 16, **kwargs)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L571)
**المعاملات:**
prompt (`str` أو `list[str]`، *اختياري*) : الأمر أو الأوامر التي تُوجّه توليد الصورة. إذا لم تُعرَّف، يجب عليك تمرير `prompt_embeds`.
height (`int`، *اختياري*، القيمة الافتراضية هي `self.unet.config.sample_size * self.vae_scale_factor`) : ارتفاع الفيديو المولّد بالبكسل.
width (`int`، *اختياري*، القيمة الافتراضية هي `self.unet.config.sample_size * self.vae_scale_factor`) : عرض الفيديو المولّد بالبكسل.
num_frames (`int`، *اختياري*، القيمة الافتراضية 16) : عدد إطارات الفيديو التي يتم توليدها. القيمة الافتراضية هي 16 إطارًا، والتي عند 8 إطارات في الثانية تعادل ثانيتين من الفيديو.
num_inference_steps (`int`، *اختياري*، القيمة الافتراضية 50) : عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى فيديوهات بجودة أعلى على حساب بطء الاستدلال.
guidance_scale (`float`, *اختياري*, القيمة الافتراضية 7.5) : كلما زادت قيمة مقياس التوجيه، شجّع النموذج على توليد صور مرتبطة ارتباطًا وثيقًا بنص `prompt` على حساب انخفاض جودة الصورة. يتم تفعيل مقياس التوجيه عندما يكون `guidance_scale > 1`.
negative_prompt (`str` أو `list[str]`، *اختياري*) : الأمر أو الأوامر التي توجّه ما يجب عدم تضمينه في توليد الصورة. إذا لم يُعرَّف، يجب عليك تمرير `negative_prompt_embeds` بدلاً من ذلك. يتم تجاهله عند عدم استخدام التوجيه (`guidance_scale < 1`).
num_videos_per_prompt (`int`، *اختياري*، القيمة الافتراضية 1) : عدد مقاطع الفيديو التي سيتم توليدها لكل موجه.
eta (`float`، *اختياري*، القيمة الافتراضية 0.0) : يتوافق مع المعامل eta (η) من ورقة [DDIM](https://huggingface.co/papers/2010.02502). ينطبق فقط على [DDIMScheduler](/docs/diffusers/main/ar/api/schedulers/ddim#diffusers.DDIMScheduler)، ويُتجاهل في جدولة أخرى.
generator (`torch.Generator` أو `list[torch.Generator]`، *اختياري*) : [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) لجعل التوليد حتميًا.
latents (`torch.Tensor`، *اختياري*) : كامنات ضجيج مُولّدة مسبقًا، مُستخرجة من توزيع غاوسي، تُستخدم كمدخلات لتوليد الفيديو. يمكن استخدامها لتعديل نفس التوليد باستخدام أوامر مختلفة. إذا لم تُقدَّم، يتم توليد كامنات عن طريق الاستخراج باستخدام `generator` العشوائي المُقدَّم. يجب أن تكون الكامنات على شكل `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة (وزن الأوامر). إذا لم تُقدَّم، يتم توليد تمثيلات النص من معامل الإدخال `prompt`.
negative_prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية سالبة مُولّدة مسبقًا. يمكن استخدامها لضبط مدخلات النص بسهولة (وزن الموجه). إذا لم تُقدَّم، يتم توليد `negative_prompt_embeds` من معامل الإدخال `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`، *اختياري*): إدخال صورة اختياري للعمل مع IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *اختياري*) : تمثيلات صور مُولّدة مسبقًا لـ IP-Adapter. يجب أن يكون قائمة بطول يساوي عدد وحدات IP-adapter. يجب أن يكون كل عنصر منها متجهًا (tensor) بشكل `(batch_size, num_images, emb_dim)`. يجب أن يحتوي على تمثيل الصورة السلبية إذا كان `do_classifier_free_guidance` مضبوطًا على `True`. إذا لم يُقدَّم، تُحسب التمثيلات من معامل الإدخال `ip_adapter_image`.
output_type (`str`، *اختياري*، الافتراضي `"pil"`) : صيغة مخرجات الفيديو المولّد. اختر بين `torch.Tensor` و`PIL.Image` أو `np.array`.
return_dict (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إرجاع `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` بدلاً من tuple عادي.
cross_attention_kwargs (`dict`، *اختياري*) : قاموس kwargs يُمرَّر إلى `AttentionProcessor` إذا تم تحديده، كما هو معرّف في [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
clip_skip (`int`, *اختياري*) : عدد الطبقات التي سيتم تجاوزها من CLIP أثناء حساب تمثيلات الموجه. القيمة 1 تعني أنه سيتم استخدام مخرجات الطبقة قبل الأخيرة لحساب تمثيلات الموجه.
callback_on_step_end (`Callable`، *اختياري*) : دالة تُستدعى في نهاية كل خطوة إزالة ضوضاء أثناء الاستدلال. تُستدعى الدالة بالحجج التالية: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. سيتضمن `callback_kwargs` قائمة بجميع المصفوفات كما حددتها `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`، *اختياري*) : قائمة مدخلات المصفوفات (tensors) لدالة `callback_on_step_end`. سيتم تمرير المصفوفات المحددة في القائمة كحجة `callback_kwargs`. لن تتمكن من تضمين سوى المتغيرات المدرجة في خاصية `._callback_tensor_inputs` لفئة خط الأنابيب (pipeline) الخاص بك.
decode_chunk_size (`int`، القيمة الافتراضية `16`) : عدد الإطارات التي يتم فك ترميزها في كل مرة عند استدعاء طريقة `decode_latents`.
**يعيد:** [AnimateDiffPipelineOutput](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) أو `tuple`
إذا كان `return_dict` هو `True`، يُعاد [AnimateDiffPipelineOutput](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput)، وإلا يُعاد `tuple` يكون عنصره الأول قائمة تحتوي على الإطارات المولّدة.
دالة الاستدعاء call لخط الأنابيب pipeline الخاص بالتوليد.
أمثلة:
```py
>>> import torch
>>> from diffusers import MotionAdapter, AnimateDiffPipeline, DDIMScheduler
>>> from diffusers.utils import export_to_gif
>>> adapter = MotionAdapter.from_pretrained("guoyww/animatediff-motion-adapter-v1-5-2")
>>> pipe = AnimateDiffPipeline.from_pretrained("frankjoshua/toonyou_beta6", motion_adapter=adapter)
>>> pipe.scheduler = DDIMScheduler(beta_schedule="linear", steps_offset=1, clip_sample=False)
>>> output = pipe(prompt="A corgi walking in the park")
>>> frames = output.frames[0]
>>> export_to_gif(frames, "animation.gif")
```
#### encode_prompt[[diffusers.AnimateDiffPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff.py#L154)
**المعاملات:**
prompt (`str` أو `list[str]`، *اختياري*) : النص الذي سيتم ترميزه
device : (`torch.device`): جهاز torch
num_images_per_prompt (`int`) : عدد الصور التي يجب توليدها لكل موجه
do_classifier_free_guidance (`bool`) : ما إذا كان سيتم استخدام التوجيه الحر للتصنيف أم لا
negative_prompt (`str` أو `list[str]`، *اختياري*) : الموجه أو الموجهات التي لا ينبغي توجيه توليد الصورة بها. إذا لم يُعرَّف، يجب تمرير `negative_prompt_embeds` بدلاً من ذلك. يتم تجاهله عند عدم استخدام التوجيه (أي يتم تجاهله إذا كان `guidance_scale` أقل من `1`).
prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد تمثيلات النص من معامل الإدخال `prompt`.
negative_prompt_embeds (`torch.Tensor`, *اختياري*) : تمثيلات نصية سالبة مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد negative_prompt_embeds من معامل الإدخال `negative_prompt`.
lora_scale (`float`، *اختياري*) : مقياس LoRA سيُطبَّق على جميع طبقات LoRA في مُشفِّر النص إذا كانت طبقات LoRA محمَّلة.
clip_skip (`int`, *اختياري*) : عدد الطبقات التي سيتم تجاوزها من CLIP أثناء حساب تمثيلات الموجه. القيمة 1 تعني أنه سيتم استخدام مخرجات الطبقة قبل الأخيرة لحساب تمثيلات الموجه.
يقوم بتشفير الموجه إلى حالات مخفية لمشفّر النص.
## AnimateDiffControlNetPipeline[[diffusers.AnimateDiffControlNetPipeline]]
#### diffusers.AnimateDiffControlNetPipeline[[diffusers.AnimateDiffControlNetPipeline]]
```python
diffusers.AnimateDiffControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: diffusers.models.controlnets.controlnet.ControlNetModel | list[diffusers.models.controlnets.controlnet.ControlNetModel] | tuple[diffusers.models.controlnets.controlnet.ControlNetModel] | diffusers.models.controlnets.multicontrolnet.MultiControlNetModel, scheduler: KarrasDiffusionSchedulers, feature_extractor: transformers.models.clip.image_processing_pil_clip.CLIPImageProcessorPil | None = None, image_encoder: transformers.models.clip.modeling_clip.CLIPVisionModelWithProjection | None = None)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L120)
**المعاملات:**
vae ([AutoencoderKL](/docs/diffusers/main/ar/api/models/autoencoderkl#diffusers.AutoencoderKL)) : نموذج الترميز التحويلي التبايني (VAE) لتشفير وفك تشفير الصور إلى تمثيلات كامنة ومنها.
text_encoder (`CLIPTextModel`) : مُشفِّر نص ثابت ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) لتجزئة النص.
unet ([UNet2DConditionModel](/docs/diffusers/main/ar/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : نموذج [UNet2DConditionModel](/docs/diffusers/main/ar/api/models/unet2d-cond#diffusers.UNet2DConditionModel) يُستخدم لإنشاء UNetMotionModel لإزالة الضوضاء من كائنات الفيديو المُرمّزة.
motion_adapter (`MotionAdapter`) : مُكيّف حركة `MotionAdapter` يُستخدم بالاقتران مع `unet` لإزالة الضوضاء من كامنات الفيديو المُرمّزة.
scheduler ([SchedulerMixin](/docs/diffusers/main/ar/api/schedulers/overview#diffusers.SchedulerMixin)) : مُجدول يُستخدم بالاقتران مع `unet` لإزالة الضوضاء من كائنات الصورة المُرمّزة. يمكن أن يكون أحد [DDIMScheduler](/docs/diffusers/main/ar/api/schedulers/ddim#diffusers.DDIMScheduler) أو [LMSDiscreteScheduler](/docs/diffusers/main/ar/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) أو [PNDMScheduler](/docs/diffusers/main/ar/api/schedulers/pndm#diffusers.PNDMScheduler).
خط أنابيب لتوليد الفيديو من النص مع توجيه ControlNet.
يرث هذا النموذج من [DiffusionPipeline](/docs/diffusers/main/ar/api/pipelines/overview#diffusers.DiffusionPipeline). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة المُنفَّذة لجميع خطوط الأنابيب (التنزيل، الحفظ، التشغيل على جهاز معين، إلخ).
تورث خط الأنابيب أيضًا طرق التحميل التالية:
- [load_textual_inversion()](/docs/diffusers/main/ar/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) لتحميل تضمينات الانعكاس النصي
- [load_lora_weights()](/docs/diffusers/main/ar/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) لتحميل أوزان LoRA
- [save_lora_weights()](/docs/diffusers/main/ar/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) لحفظ أوزان LoRA
- [load_ip_adapter()](/docs/diffusers/main/ar/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) لتحميل وحدات IP Adapter
#### __call__[[diffusers.AnimateDiffControlNetPipeline.__call__]]
```python
__call__(prompt: str | list[str] = None, num_frames: int | None = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, guess_mode: bool = False, control_guidance_start: float | list[float] = 0.0, control_guidance_end: float | list[float] = 1.0, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'], decode_chunk_size: int = 16)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L721)
**المعاملات:**
prompt (`str` أو `list[str]`، *اختياري*) : الأمر أو الأوامر التي تُوجّه توليد الصورة. إذا لم تُعرَّف، يجب عليك تمرير `prompt_embeds`.
height (`int`، *اختياري*، القيمة الافتراضية هي `self.unet.config.sample_size * self.vae_scale_factor`) : ارتفاع الفيديو المولّد بالبكسل.
width (`int`، *اختياري*، القيمة الافتراضية هي `self.unet.config.sample_size * self.vae_scale_factor`) : عرض الفيديو المولّد بالبكسل.
num_frames (`int`، *اختياري*، القيمة الافتراضية 16) : عدد إطارات الفيديو التي يتم توليدها. القيمة الافتراضية هي 16 إطارًا، والتي عند 8 إطارات في الثانية تعادل ثانيتين من الفيديو.
num_inference_steps (`int`، *اختياري*، القيمة الافتراضية 50) : عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى فيديوهات بجودة أعلى على حساب بطء الاستدلال.
guidance_scale (`float`, *اختياري*, القيمة الافتراضية 7.5) : كلما زادت قيمة مقياس التوجيه، شجّع النموذج على توليد صور مرتبطة ارتباطًا وثيقًا بنص `prompt` على حساب انخفاض جودة الصورة. يتم تفعيل مقياس التوجيه عندما يكون `guidance_scale > 1`.
negative_prompt (`str` أو `list[str]`، *اختياري*) : الأمر أو الأوامر التي توجّه ما يجب عدم تضمينه في توليد الصورة. إذا لم يُعرَّف، يجب عليك تمرير `negative_prompt_embeds` بدلاً من ذلك. يتم تجاهله عند عدم استخدام التوجيه (`guidance_scale < 1`).
num_videos_per_prompt (`int`، *اختياري*، القيمة الافتراضية 1) : عدد مقاطع الفيديو التي سيتم توليدها لكل موجه.
eta (`float`، *اختياري*، القيمة الافتراضية 0.0) : يتوافق مع المعامل eta (η) من ورقة [DDIM](https://huggingface.co/papers/2010.02502). ينطبق فقط على [DDIMScheduler](/docs/diffusers/main/ar/api/schedulers/ddim#diffusers.DDIMScheduler)، ويُتجاهل في جدولة أخرى.
generator (`torch.Generator` أو `list[torch.Generator]`، *اختياري*) : [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) لجعل التوليد حتميًا.
latents (`torch.Tensor`، *اختياري*) : كامنات ضجيج مُولّدة مسبقًا، مُستخرجة من توزيع غاوسي، تُستخدم كمدخلات لتوليد الفيديو. يمكن استخدامها لتعديل نفس التوليد باستخدام أوامر مختلفة. إذا لم تُقدَّم، يتم توليد كامنات عن طريق الاستخراج باستخدام `generator` العشوائي المُقدَّم. يجب أن تكون الكامنات على شكل `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة (وزن الأوامر). إذا لم تُقدَّم، يتم توليد تمثيلات النص من معامل الإدخال `prompt`.
negative_prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية سالبة مُولّدة مسبقًا. يمكن استخدامها لضبط مدخلات النص بسهولة (وزن الموجه). إذا لم تُقدَّم، يتم توليد `negative_prompt_embeds` من معامل الإدخال `negative_prompt`.
ip_adapter_image (`PipelineImageInput`، *اختياري*) : إدخال صورة اختياري للعمل مع IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *اختياري*) : تمثيلات صور مُولّدة مسبقًا لـ IP-Adapter. يجب أن يكون قائمة بطول يساوي عدد وحدات IP-adapter. يجب أن يكون كل عنصر منها متجهًا (tensor) بشكل `(batch_size, num_images, emb_dim)`. يجب أن يحتوي على تمثيل الصورة السلبية إذا كان `do_classifier_free_guidance` مضبوطًا على `True`. إذا لم يُقدَّم، تُحسب التمثيلات من معامل الإدخال `ip_adapter_image`.
conditioning_frames (`list[PipelineImageInput]`، *اختياري*) : شرط الإدخال الخاص بـ ControlNet لتوفير التوجيه إلى `unet` للتوليد. إذا تم تحديد عدة وحدات ControlNet، فيجب تمرير الصور كقائمة بحيث يمكن تجميع كل عنصر من عناصر القائمة بشكل صحيح للإدخال إلى وحدة ControlNet واحدة.
output_type (`str`، *اختياري*، الافتراضي `"pil"`) : صيغة مخرجات الفيديو المولّد. اختر بين `torch.Tensor` و`PIL.Image` أو `np.array`.
return_dict (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إرجاع `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` بدلاً من tuple عادي.
cross_attention_kwargs (`dict`، *اختياري*) : قاموس kwargs يُمرَّر إلى `AttentionProcessor` إذا تم تحديده، كما هو معرّف في [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
controlnet_conditioning_scale (`float` أو `list[float]`، *اختياري*، القيمة الافتراضية 1.0) : تُضرب مخرجات ControlNet في `controlnet_conditioning_scale` قبل إضافتها إلى الباقي في `unet` الأصلية. إذا تم تحديد عدة ControlNets في `init`، يمكنك تعيين المقياس المقابل كقائمة.
guess_mode (`bool`، *اختياري*، القيمة الافتراضية `False`) : يحاول مُشفِّر ControlNet التعرف على محتوى الصورة المُدخلة حتى إذا قمت بإزالة جميع الأوامر النصية. يُوصى بقيمة `guidance_scale` بين 3.0 و5.0.
control_guidance_start (`float` أو `list[float]`، *اختياري*، القيمة الافتراضية 0.0) : النسبة المئوية من إجمالي الخطوات التي يبدأ عندها ControlNet في التطبيق.
control_guidance_end (`float` أو `list[float]`، *اختياري*، القيمة الافتراضية 1.0) : النسبة المئوية من إجمالي الخطوات التي يتوقف عندها ControlNet عن التطبيق.
clip_skip (`int`, *اختياري*) : عدد الطبقات التي سيتم تجاوزها من CLIP أثناء حساب تمثيلات الموجه. القيمة 1 تعني أنه سيتم استخدام مخرجات الطبقة قبل الأخيرة لحساب تمثيلات الموجه.
callback_on_step_end (`Callable`، *اختياري*) : دالة تُستدعى في نهاية كل خطوة إزالة ضوضاء أثناء الاستدلال. تُستدعى الدالة بالحجج التالية: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. سيتضمن `callback_kwargs` قائمة بجميع المصفوفات كما حددتها `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`، *اختياري*) : قائمة مدخلات المصفوفات (tensors) لدالة `callback_on_step_end`. سيتم تمرير المصفوفات المحددة في القائمة كحجة `callback_kwargs`. لن تتمكن من تضمين سوى المتغيرات المدرجة في خاصية `._callback_tensor_inputs` لفئة خط الأنابيب (pipeline) الخاص بك.
decode_chunk_size (`int`، القيمة الافتراضية `16`) : عدد الإطارات التي يتم فك ترميزها في كل مرة عند استدعاء طريقة `decode_latents`.
**يعيد:** [AnimateDiffPipelineOutput](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) أو `tuple`
إذا كان `return_dict` هو `True`، يُعاد [AnimateDiffPipelineOutput](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput)، وإلا يُعاد `tuple` يكون عنصره الأول قائمة تحتوي على الإطارات المولّدة.
دالة الاستدعاء call لخط الأنابيب pipeline الخاص بالتوليد.
أمثلة:
#### encode_prompt[[diffusers.AnimateDiffControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_controlnet.py#L199)
**المعاملات:**
prompt (`str` أو `list[str]`، *اختياري*) : النص الذي سيتم ترميزه
device : (`torch.device`): جهاز torch
num_images_per_prompt (`int`) : عدد الصور التي يجب توليدها لكل موجه
do_classifier_free_guidance (`bool`) : ما إذا كان سيتم استخدام التوجيه الحر للتصنيف أم لا
negative_prompt (`str` أو `list[str]`، *اختياري*) : الموجه أو الموجهات التي لا ينبغي توجيه توليد الصورة بها. إذا لم يُعرَّف، يجب تمرير `negative_prompt_embeds` بدلاً من ذلك. يتم تجاهله عند عدم استخدام التوجيه (أي يتم تجاهله إذا كان `guidance_scale` أقل من `1`).
prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد تمثيلات النص من معامل الإدخال `prompt`.
negative_prompt_embeds (`torch.Tensor`, *اختياري*) : تمثيلات نصية سالبة مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد negative_prompt_embeds من معامل الإدخال `negative_prompt`.
lora_scale (`float`، *اختياري*) : مقياس LoRA سيُطبَّق على جميع طبقات LoRA في مُشفِّر النص إذا كانت طبقات LoRA محمَّلة.
clip_skip (`int`, *اختياري*) : عدد الطبقات التي سيتم تجاوزها من CLIP أثناء حساب تمثيلات الموجه. القيمة 1 تعني أنه سيتم استخدام مخرجات الطبقة قبل الأخيرة لحساب تمثيلات الموجه.
يقوم بتشفير الموجه إلى حالات مخفية لمشفّر النص.
## AnimateDiffSparseControlNetPipeline[[diffusers.AnimateDiffSparseControlNetPipeline]]
#### diffusers.AnimateDiffSparseControlNetPipeline[[diffusers.AnimateDiffSparseControlNetPipeline]]
```python
diffusers.AnimateDiffSparseControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: SparseControlNetModel, scheduler: KarrasDiffusionSchedulers, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L132)
**المعاملات:**
vae ([AutoencoderKL](/docs/diffusers/main/ar/api/models/autoencoderkl#diffusers.AutoencoderKL)) : نموذج الترميز التحويلي التبايني (VAE) لتشفير وفك تشفير الصور إلى تمثيلات كامنة ومنها.
text_encoder (`CLIPTextModel`) : مُشفِّر نص ثابت ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) لتجزئة النص.
unet ([UNet2DConditionModel](/docs/diffusers/main/ar/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : نموذج [UNet2DConditionModel](/docs/diffusers/main/ar/api/models/unet2d-cond#diffusers.UNet2DConditionModel) يُستخدم لإنشاء UNetMotionModel لإزالة الضوضاء من كائنات الفيديو المُرمّزة.
motion_adapter (`MotionAdapter`) : مُكيّف حركة `MotionAdapter` يُستخدم بالاقتران مع `unet` لإزالة الضوضاء من كامنات الفيديو المُرمّزة.
scheduler ([SchedulerMixin](/docs/diffusers/main/ar/api/schedulers/overview#diffusers.SchedulerMixin)) : مُجدول يُستخدم بالاقتران مع `unet` لإزالة الضوضاء من كائنات الصورة المُرمّزة. يمكن أن يكون أحد [DDIMScheduler](/docs/diffusers/main/ar/api/schedulers/ddim#diffusers.DDIMScheduler) أو [LMSDiscreteScheduler](/docs/diffusers/main/ar/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) أو [PNDMScheduler](/docs/diffusers/main/ar/api/schedulers/pndm#diffusers.PNDMScheduler).
خط أنابيب لتوليد فيديو من نص مُميَّز باستخدام الطريقة الموصوفة في [SparseCtrl: إضافة تحكيمات متناثرة إلى نماذج الانتشار لتحويل النص إلى فيديو](https://huggingface.co/papers/2311.16933).
يرث هذا النموذج من [DiffusionPipeline](/docs/diffusers/main/ar/api/pipelines/overview#diffusers.DiffusionPipeline). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة المُنفَّذة لجميع خطوط الأنابيب (التنزيل، الحفظ، التشغيل على جهاز معين، إلخ).
تورث خط الأنابيب أيضًا طرق التحميل التالية:
- [load_textual_inversion()](/docs/diffusers/main/ar/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) لتحميل تضمينات الانعكاس النصي
- [load_lora_weights()](/docs/diffusers/main/ar/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) لتحميل أوزان LoRA
- [save_lora_weights()](/docs/diffusers/main/ar/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) لحفظ أوزان LoRA
- [load_ip_adapter()](/docs/diffusers/main/ar/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) لتحميل وحدات IP Adapter
#### __call__[[diffusers.AnimateDiffSparseControlNetPipeline.__call__]]
```python
__call__(prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_frames: int = 16, num_inference_steps: int = 50, guidance_scale: float = 7.5, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, controlnet_frame_indices: list = [0], guess_mode: bool = False, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'])
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L712)
**المعاملات:**
prompt (`str` أو `list[str]`، *اختياري*) : الأمر أو الأوامر التي تُوجّه توليد الصورة. إذا لم تُعرَّف، يجب عليك تمرير `prompt_embeds`.
height (`int`، *اختياري*، القيمة الافتراضية هي `self.unet.config.sample_size * self.vae_scale_factor`) : ارتفاع الفيديو المولّد بالبكسل.
width (`int`، *اختياري*، القيمة الافتراضية هي `self.unet.config.sample_size * self.vae_scale_factor`) : عرض الفيديو المولّد بالبكسل.
num_frames (`int`، *اختياري*، القيمة الافتراضية 16) : عدد إطارات الفيديو التي يتم توليدها. القيمة الافتراضية هي 16 إطارًا، والتي عند 8 إطارات في الثانية تعادل ثانيتين من الفيديو.
num_inference_steps (`int`، *اختياري*، القيمة الافتراضية 50) : عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى فيديوهات بجودة أعلى على حساب بطء الاستدلال.
guidance_scale (`float`, *اختياري*, القيمة الافتراضية 7.5) : كلما زادت قيمة مقياس التوجيه، شجّع النموذج على توليد صور مرتبطة ارتباطًا وثيقًا بنص `prompt` على حساب انخفاض جودة الصورة. يتم تفعيل مقياس التوجيه عندما يكون `guidance_scale > 1`.
negative_prompt (`str` أو `list[str]`، *اختياري*) : الأمر أو الأوامر التي توجّه ما يجب عدم تضمينه في توليد الصورة. إذا لم يُعرَّف، يجب عليك تمرير `negative_prompt_embeds` بدلاً من ذلك. يتم تجاهله عند عدم استخدام التوجيه (`guidance_scale < 1`).
num_videos_per_prompt (`int`، *اختياري*، القيمة الافتراضية 1) : عدد مقاطع الفيديو التي سيتم توليدها لكل موجه.
eta (`float`، *اختياري*، القيمة الافتراضية 0.0) : يتوافق مع المعامل eta (η) من ورقة [DDIM](https://huggingface.co/papers/2010.02502). ينطبق فقط على [DDIMScheduler](/docs/diffusers/main/ar/api/schedulers/ddim#diffusers.DDIMScheduler)، ويُتجاهل في جدولة أخرى.
generator (`torch.Generator` أو `list[torch.Generator]`، *اختياري*) : [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) لجعل التوليد حتميًا.
latents (`torch.Tensor`، *اختياري*) : كامنات ضجيج مُولّدة مسبقًا، مُستخرجة من توزيع غاوسي، تُستخدم كمدخلات لتوليد الفيديو. يمكن استخدامها لتعديل نفس التوليد باستخدام أوامر مختلفة. إذا لم تُقدَّم، يتم توليد كامنات عن طريق الاستخراج باستخدام `generator` العشوائي المُقدَّم. يجب أن تكون الكامنات على شكل `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة (وزن الأوامر). إذا لم تُقدَّم، يتم توليد تمثيلات النص من معامل الإدخال `prompt`.
negative_prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية سالبة مُولّدة مسبقًا. يمكن استخدامها لضبط مدخلات النص بسهولة (وزن الموجه). إذا لم تُقدَّم، يتم توليد `negative_prompt_embeds` من معامل الإدخال `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`، *اختياري*): إدخال صورة اختياري للعمل مع IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *اختياري*) : تمثيلات صور مُولّدة مسبقًا لـ IP-Adapter. يجب أن يكون قائمة بطول يساوي عدد وحدات IP-adapter. يجب أن يكون كل عنصر منها متجهًا (tensor) بشكل `(batch_size, num_images, emb_dim)`. يجب أن يحتوي على تمثيل الصورة السلبية إذا كان `do_classifier_free_guidance` مضبوطًا على `True`. إذا لم يُقدَّم، تُحسب التمثيلات من معامل الإدخال `ip_adapter_image`.
conditioning_frames (`list[PipelineImageInput]`، *اختياري*) : مدخل SparseControlNet لتوفير التوجيه إلى `unet` للتوليد.
output_type (`str`، *اختياري*، الافتراضي `"pil"`) : صيغة مخرجات الفيديو المولّد. اختر بين `torch.Tensor` و`PIL.Image` أو `np.array`.
return_dict (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إرجاع `~pipelines.text_to_video_synthesis.TextToVideoSDPipelineOutput` بدلاً من tuple عادي.
cross_attention_kwargs (`dict`، *اختياري*) : قاموس kwargs يُمرَّر إلى `AttentionProcessor` إذا تم تحديده، كما هو معرّف في [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
controlnet_conditioning_scale (`float` أو `list[float]`، *اختياري*، القيمة الافتراضية 1.0) : تُضرب مخرجات ControlNet في `controlnet_conditioning_scale` قبل إضافتها إلى الباقي في `unet` الأصلية. إذا تم تحديد عدة ControlNets في `init`، يمكنك تعيين المقياس المقابل كقائمة.
controlnet_frame_indices (`list[int]`) : الفهارس التي يجب تطبيق إطارات التكييف عليها للتوليد. يمكن تقديم عدة إطارات لتوجيه النموذج لتوليد مخرجات ذات بنية مشابهة، حيث يمكن لـ`unet` أن "يملأ الفراغات" لفيديوهات الاستيفاء، أو يمكن تقديم إطار واحد للهيكل المتوقع بشكل عام. يجب أن يكون له نفس طول `conditioning_frames`.
guess_mode (`bool`، *اختياري*، القيمة الافتراضية `False`) : يحاول مُشفِّر ControlNet التعرف على محتوى الصورة المُدخلة حتى إذا قمت بإزالة جميع الأوامر النصية. يُوصى بقيمة `guidance_scale` بين 3.0 و5.0.
clip_skip (`int`, *اختياري*) : عدد الطبقات التي سيتم تجاوزها من CLIP أثناء حساب تمثيلات الموجه. القيمة 1 تعني أنه سيتم استخدام مخرجات الطبقة قبل الأخيرة لحساب تمثيلات الموجه.
callback_on_step_end (`Callable`، *اختياري*) : دالة تُستدعى في نهاية كل خطوة إزالة ضوضاء أثناء الاستدلال. تُستدعى الدالة بالحجج التالية: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. سيتضمن `callback_kwargs` قائمة بجميع المصفوفات كما حددتها `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`، *اختياري*) : قائمة مدخلات المصفوفات (tensors) لدالة `callback_on_step_end`. سيتم تمرير المصفوفات المحددة في القائمة كحجة `callback_kwargs`. لن تتمكن من تضمين سوى المتغيرات المدرجة في خاصية `._callback_tensor_inputs` لفئة خط الأنابيب (pipeline) الخاص بك.
**يعيد:** [AnimateDiffPipelineOutput](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) أو `tuple`
إذا كان `return_dict` هو `True`، يُعاد [AnimateDiffPipelineOutput](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput)، وإلا يُعاد `tuple` يكون عنصره الأول قائمة تحتوي على الإطارات المولّدة.
دالة الاستدعاء call لخط الأنابيب pipeline الخاص بالتوليد.
أمثلة:
```python
>>> import torch
>>> from diffusers import AnimateDiffSparseControlNetPipeline
>>> from diffusers.models import AutoencoderKL, MotionAdapter, SparseControlNetModel
>>> from diffusers.schedulers import DPMSolverMultistepScheduler
>>> from diffusers.utils import export_to_gif, load_image
>>> model_id = "SG161222/Realistic_Vision_V5.1_noVAE"
>>> motion_adapter_id = "guoyww/animatediff-motion-adapter-v1-5-3"
>>> controlnet_id = "guoyww/animatediff-sparsectrl-scribble"
>>> lora_adapter_id = "guoyww/animatediff-motion-lora-v1-5-3"
>>> vae_id = "stabilityai/sd-vae-ft-mse"
>>> device = "cuda"
>>> motion_adapter = MotionAdapter.from_pretrained(motion_adapter_id, torch_dtype=torch.float16).to(device)
>>> controlnet = SparseControlNetModel.from_pretrained(controlnet_id, torch_dtype=torch.float16).to(device)
>>> vae = AutoencoderKL.from_pretrained(vae_id, torch_dtype=torch.float16).to(device)
>>> scheduler = DPMSolverMultistepScheduler.from_pretrained(
... model_id,
... subfolder="scheduler",
... beta_schedule="linear",
... algorithm_type="dpmsolver++",
... use_karras_sigmas=True,
... )
>>> pipe = AnimateDiffSparseControlNetPipeline.from_pretrained(
... model_id,
... motion_adapter=motion_adapter,
... controlnet=controlnet,
... vae=vae,
... scheduler=scheduler,
... torch_dtype=torch.float16,
... ).to(device)
>>> pipe.load_lora_weights(lora_adapter_id, adapter_name="motion_lora")
>>> pipe.fuse_lora(lora_scale=1.0)
>>> prompt = "an aerial view of a cyberpunk city, night time, neon lights, masterpiece, high quality"
>>> negative_prompt = "low quality, worst quality, letterboxed"
>>> image_files = [
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-1.png",
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-2.png",
... "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/diffusers/animatediff-scribble-3.png",
... ]
>>> condition_frame_indices = [0, 8, 15]
>>> conditioning_frames = [load_image(img_file) for img_file in image_files]
>>> video = pipe(
... prompt=prompt,
... negative_prompt=negative_prompt,
... num_inference_steps=25,
... conditioning_frames=conditioning_frames,
... controlnet_conditioning_scale=1.0,
... controlnet_frame_indices=condition_frame_indices,
... generator=torch.Generator().manual_seed(1337),
... ).frames[0]
>>> export_to_gif(video, "output.gif")
```
#### encode_prompt[[diffusers.AnimateDiffSparseControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sparsectrl.py#L208)
**المعاملات:**
prompt (`str` أو `list[str]`، *اختياري*) : النص الذي سيتم ترميزه
device : (`torch.device`): جهاز torch
num_images_per_prompt (`int`) : عدد الصور التي يجب توليدها لكل موجه
do_classifier_free_guidance (`bool`) : ما إذا كان سيتم استخدام التوجيه الحر للتصنيف أم لا
negative_prompt (`str` أو `list[str]`، *اختياري*) : الموجه أو الموجهات التي لا ينبغي توجيه توليد الصورة بها. إذا لم يُعرَّف، يجب تمرير `negative_prompt_embeds` بدلاً من ذلك. يتم تجاهله عند عدم استخدام التوجيه (أي يتم تجاهله إذا كان `guidance_scale` أقل من `1`).
prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد تمثيلات النص من معامل الإدخال `prompt`.
negative_prompt_embeds (`torch.Tensor`, *اختياري*) : تمثيلات نصية سالبة مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد negative_prompt_embeds من معامل الإدخال `negative_prompt`.
lora_scale (`float`، *اختياري*) : مقياس LoRA سيُطبَّق على جميع طبقات LoRA في مُشفِّر النص إذا كانت طبقات LoRA محمَّلة.
clip_skip (`int`, *اختياري*) : عدد الطبقات التي سيتم تجاوزها من CLIP أثناء حساب تمثيلات الموجه. القيمة 1 تعني أنه سيتم استخدام مخرجات الطبقة قبل الأخيرة لحساب تمثيلات الموجه.
يقوم بتشفير الموجه إلى حالات مخفية لمشفّر النص.
## AnimateDiffSDXLPipeline[[diffusers.AnimateDiffSDXLPipeline]]
#### diffusers.AnimateDiffSDXLPipeline[[diffusers.AnimateDiffSDXLPipeline]]
```python
diffusers.AnimateDiffSDXLPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, text_encoder_2: CLIPTextModelWithProjection, tokenizer: CLIPTokenizer, tokenizer_2: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, image_encoder: CLIPVisionModelWithProjection = None, feature_extractor: CLIPImageProcessorPil = None, force_zeros_for_empty_prompt: bool = True)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L210)
**المعاملات:**
vae ([AutoencoderKL](/docs/diffusers/main/ar/api/models/autoencoderkl#diffusers.AutoencoderKL)) : نموذج الترميز التحويلي التبايني (VAE) لتشفير وفك تشفير الصور إلى تمثيلات كامنة ومنها.
text_encoder (`CLIPTextModel`) : مُشفِّر نص ثابت. يستخدم Stable Diffusion XL الجزء النصي من [CLIP](https://huggingface.co/docs/transformers/model_doc/clip#transformers.CLIPTextModel)، وتحديداً النسخة [clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14).
text_encoder_2 (` CLIPTextModelWithProjection`) : مُشفِّر نصي مجمّد ثانٍ. يستخدم Stable Diffusion XL جزء النص والجزء المُجمَّع (pool) من [CLIP](https://huggingface.co/docs/transformers/model_doc/clip#transformers.CLIPTextModelWithProjection)، وتحديداً النسخة [laion/CLIP-ViT-bigG-14-laion2B-39B-b160k](https://huggingface.co/laion/CLIP-ViT-bigG-14-laion2B-39B-b160k).
tokenizer (`CLIPTokenizer`) : مُقسِّم من الفئة [CLIPTokenizer](https://huggingface.co/docs/transformers/v4.21.0/en/model_doc/clip#transformers.CLIPTokenizer).
tokenizer_2 (`CLIPTokenizer`) : مُقسِّم ثانٍ من الفئة [CLIPTokenizer](https://huggingface.co/docs/transformers/v4.21.0/en/model_doc/clip#transformers.CLIPTokenizer).
unet ([UNet2DConditionModel](/docs/diffusers/main/ar/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : بنية U-Net الشرطية لفك تشويش كامن الصورة المُرمّزة.
scheduler ([SchedulerMixin](/docs/diffusers/main/ar/api/schedulers/overview#diffusers.SchedulerMixin)) : مُجدول يُستخدم بالاقتران مع `unet` لإزالة الضوضاء من كائنات الصورة المُرمّزة. يمكن أن يكون أحد [DDIMScheduler](/docs/diffusers/main/ar/api/schedulers/ddim#diffusers.DDIMScheduler) أو [LMSDiscreteScheduler](/docs/diffusers/main/ar/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) أو [PNDMScheduler](/docs/diffusers/main/ar/api/schedulers/pndm#diffusers.PNDMScheduler).
force_zeros_for_empty_prompt (`bool`، *اختياري*، القيمة الافتراضية `"True"`) : ما إذا كان يجب إجبار تضمينات الموجه السلبي على أن تكون دائمًا 0. راجع أيضًا إعدادات `stabilityai/stable-diffusion-xl-base-1-0`.
خط أنابيب لتوليد الفيديو من النص باستخدام Stable Diffusion XL.
يرث هذا النموذج من [DiffusionPipeline](/docs/diffusers/main/ar/api/pipelines/overview#diffusers.DiffusionPipeline). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع خطوط الأنابيب (مثل التنزيل أو الحفظ، أو التشغيل على جهاز معين، وما إلى ذلك).
تورث خط الأنابيب أيضًا طرق التحميل التالية:
- [load_textual_inversion()](/docs/diffusers/main/ar/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) لتحميل تضمينات الانعكاس النصي
- [from_single_file()](/docs/diffusers/main/ar/api/loaders/single_file#diffusers.loaders.FromSingleFileMixin.from_single_file) لتحميل ملفات `.ckpt`
- [load_lora_weights()](/docs/diffusers/main/ar/api/loaders/lora#diffusers.loaders.StableDiffusionXLLoraLoaderMixin.load_lora_weights) لتحميل أوزان LoRA
- [save_lora_weights()](/docs/diffusers/main/ar/api/loaders/lora#diffusers.loaders.StableDiffusionXLLoraLoaderMixin.save_lora_weights) لحفظ أوزان LoRA
- [load_ip_adapter()](/docs/diffusers/main/ar/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) لتحميل وحدات IP Adapter
#### __call__[[diffusers.AnimateDiffSDXLPipeline.__call__]]
```python
__call__(prompt: str | list[str] = None, prompt_2: str | list[str] | None = None, num_frames: int = 16, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, timesteps: list = None, sigmas: list = None, denoising_end: float | None = None, guidance_scale: float = 5.0, negative_prompt: str | list[str] | None = None, negative_prompt_2: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, negative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, guidance_rescale: float = 0.0, original_size: tuple[int, int] | None = None, crops_coords_top_left: tuple = (0, 0), target_size: tuple[int, int] | None = None, negative_original_size: tuple[int, int] | None = None, negative_crops_coords_top_left: tuple = (0, 0), negative_target_size: tuple[int, int] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'])
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L869)
**المعاملات:**
prompt (`str` أو `list[str]`، *اختياري*) : الأمر أو الأوامر التي تُوجّه توليد الفيديو. إذا لم يُعرَّف، يجب تمرير `prompt_embeds` بدلاً من ذلك.
prompt_2 (`str` أو `list[str]`، *اختياري*) : الموجه أو الموجهات المرسل إلى `tokenizer_2` و`text_encoder_2`. إذا لم يُعرَّف، يُستخدم `prompt` في كلا مشفّري النص
num_frames : عدد إطارات الفيديو التي يتم توليدها. القيمة الافتراضية هي 16 إطارًا، والتي عند 8 إطارات في الثانية تعادل ثانيتين من الفيديو.
height (`int`، *اختياري*، القيمة الافتراضية هي self.unet.config.sample_size * self.vae_scale_factor) : ارتفاع الفيديو المولّد بالبكسلات. يتم ضبطه على 1024 افتراضيًا للحصول على أفضل النتائج. أي قيمة أقل من 512 بكسل لن تعمل بشكل جيد مع [stabilityai/stable-diffusion-xl-base-1.0](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0) ونقاط التفتيش التي لم يتم ضبطها بدقة خصيصًا على الدقات المنخفضة.
width (`int`، *اختياري*، القيمة الافتراضية هي self.unet.config.sample_size * self.vae_scale_factor) : عرض الفيديو المولّد بالبكسلات. يتم ضبطه على 1024 افتراضيًا للحصول على أفضل النتائج. أي قيمة أقل من 512 بكسل لن تعمل بشكل جيد مع [stabilityai/stable-diffusion-xl-base-1.0](https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0) ونقاط التفتيش التي لم يتم ضبطها بدقة خصيصًا على الدقات المنخفضة.
num_inference_steps (`int`، *اختياري*، القيمة الافتراضية 50) : عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى فيديو بجودة أعلى على حساب بطء الاستدلال.
timesteps (`list[int]`، *اختياري*) : خطوات زمنية مخصصة لاستخدامها في عملية إزالة الضوضاء مع المجدولين الذين يدعمون معامل `timesteps` في طريقة `set_timesteps` الخاصة بهم. إذا لم يُعرَّف، فسيتم استخدام السلوك الافتراضي عند تمرير `num_inference_steps`. يجب أن تكون بترتيب تنازلي.
sigmas (`list[float]`، *اختياري*) : قيم `sigmas` مخصصة لاستخدامها في عملية إزالة الضوضاء مع المجدولين الذين يدعمون معامل `sigmas` في طريقة `set_timesteps` الخاصة بهم. إذا لم تُعرَّف، فسيتم استخدام السلوك الافتراضي عند تمرير `num_inference_steps`.
denoising_end (`float`، *اختياري*) : عند تحديده، يحدد نسبة (بين 0.0 و 1.0) من إجمالي عملية إزالة الضوضاء التي يجب إكمالها قبل إنهائها مبكرًا عمدًا. ونتيجةً لذلك، سيحتفظ العينة المُعاد بها بكمية كبيرة من الضوضاء كما تحددها الخطوات الزمنية المنفصلة التي يختارها المجدول. ينبغي استخدام معامل denoising_end بشكل مثالي عندما يشكل هذا الخط الأنابيب جزءًا من إعداد متعدد الخطوط الأنابيب "خليط من مُزيلات الضوضاء"، كما هو موضح في [**تحسين مخرجات الصورة**](https://huggingface.co/docs/diffusers/api/pipelines/stable_diffusion/stable_diffusion_xl#refining-the-image-output)
guidance_scale (`float`، *اختياري*، القيمة الافتراضية 5.0) : مقياس التوجيه كما هو مُعرَّف في [Classifier-Free Diffusion Guidance](https://huggingface.co/papers/2207.12598). يُعرَّف `guidance_scale` على أنه `w` من المعادلة 2. في [Imagen Paper](https://huggingface.co/papers/2205.11487). يتم تفعيل مقياس التوجيه عن طريق تعيين `guidance_scale > 1`. يشجع مقياس التوجيه الأعلى على توليد صور مرتبطة ارتباطًا وثيقًا بنص `prompt`، وعادةً على حساب انخفاض جودة الفيديو.
negative_prompt (`str` أو `list[str]`، *اختياري*) : الأمر أو الأوامر التي لا ينبغي أن توجه توليد الفيديو. إذا لم يُعرَّف، يجب تمرير `negative_prompt_embeds` بدلاً من ذلك. يتم تجاهله عند عدم استخدام التوجيه (أي يتم تجاهله إذا كان `guidance_scale` أقل من `1`).
negative_prompt_2 (`str` أو `list[str]`، *اختياري*) : الموجه أو الموجهات التي لا ينبغي توجيه توليد الفيديو إليها، والتي سيتم إرسالها إلى `tokenizer_2` و`text_encoder_2`. إذا لم يُعرَّف، يُستخدم `negative_prompt` في كلا مشفري النص
num_videos_per_prompt (`int`، *اختياري*، القيمة الافتراضية 1) : عدد مقاطع الفيديو التي سيتم توليدها لكل موجه.
eta (`float`، *اختياري*، القيمة الافتراضية 0.0) : يتوافق مع المعامل eta (η) في ورقة DDIM: https://huggingface.co/papers/2010.02502. ينطبق فقط على [schedulers.DDIMScheduler](/docs/diffusers/main/ar/api/schedulers/ddim#diffusers.DDIMScheduler)، وسيتم تجاهله في الحالات الأخرى.
generator (`torch.Generator` أو `list[torch.Generator]`، *اختياري*) : مولّد واحد أو قائمة من [مولّدات torch](https://pytorch.org/docs/stable/generated/torch.Generator.html) لجعل التوليد حتميًا.
latents (`torch.Tensor`، *اختياري*) : كامنات ضجيج مُولّدة مسبقًا، مُستخرجة من توزيع غاوسي، تُستخدم كمدخلات لتوليد الفيديو. يمكن استخدامها لتعديل نفس التوليد باستخدام أوامر مختلفة. إذا لم تُقدَّم، سيتم توليد كامنات من خلال الاستخراج باستخدام `generator` العشوائي المُقدَّم.
prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد تمثيلات النص من معامل الإدخال `prompt`.
negative_prompt_embeds (`torch.Tensor`, *اختياري*) : تمثيلات نصية سالبة مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد negative_prompt_embeds من معامل الإدخال `negative_prompt`.
pooled_prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية مجمّعة مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد تمثيلات نصية مجمّعة من معامل الإدخال `prompt`.
negative_pooled_prompt_embeds (`torch.Tensor`, *اختياري*) : تمثيلات نصية مجمعة سالبة مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد pooled negative_prompt_embeds من معامل الإدخال `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`، *اختياري*): إدخال صورة اختياري للعمل مع IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`، *اختياري*) : تمثيلات صور مُولّدة مسبقًا لـ IP-Adapter. إذا لم تُقدَّم، تُحسب التمثيلات من معامل الإدخال `ip_adapter_image`.
output_type (`str`، *اختياري*، القيمة الافتراضية `"pil"`) : صيغة مخرجات الفيديو المولّد. اختر بين [PIL](https://pillow.readthedocs.io/en/stable/): `PIL.Image.Image` أو `np.array`.
return_dict (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إرجاع `~pipelines.stable_diffusion_xl.AnimateDiffPipelineOutput` بدلاً من tuple عادي.
cross_attention_kwargs (`dict`، *اختياري*) : قاموس kwargs يُمرَّر إلى `AttentionProcessor` إذا تم تحديده، كما هو معرَّف تحت `self.processor` في [diffusers.models.attention_processor](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
guidance_rescale (`float`, *optional*, defaults to 0.0) : Guidance rescale factor proposed by [Common Diffusion Noise Schedules and Sample Steps are Flawed](https://huggingface.co/papers/2305.08891) `guidance_scale` is defined as `φ` in equation 16. of [Common Diffusion Noise Schedules and Sample Steps are Flawed](https://huggingface.co/papers/2305.08891). Guidance rescale factor should fix overexposure when using zero terminal SNR.
original_size (`tuple[int]`، *اختياري*، القيمة الافتراضية (1024, 1024)) : إذا لم تكن `original_size` مطابقة لـ `target_size`، فسيبدو أن الصورة قد خضعت لتقليل أو زيادة حجمها. القيمة الافتراضية لـ `original_size` هي `(height, width)` إذا لم تُحدد. جزء من التكييف الدقيق (micro-conditioning) الخاص بـ SDXL كما هو موضح في القسم 2.2 من [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952).
crops_coords_top_left (`tuple[int]`، *اختياري*، القيمة الافتراضية (0, 0)) : يمكن استخدام `crops_coords_top_left` لتوليد صورة تبدو وكأنها "مقتطعة" من الموضع `crops_coords_top_left` إلى الأسفل. عادةً ما يتم تحقيق صور مفضلة ومركزة جيدًا عن طريق تعيين `crops_coords_top_left` إلى (0, 0). جزء من micro-conditioning الخاص بـ SDXL كما هو موضح في القسم 2.2 من [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952).
target_size (`tuple[int]`، *اختياري*، القيمة الافتراضية (1024, 1024)) : في معظم الحالات، يجب ضبط `target_size` على الارتفاع والعرض المطلوبين للصورة المولّدة. إذا لم يُحدد، فسيكون الافتراضي `(height, width)`. جزء من التكييف الدقيق (micro-conditioning) في SDXL كما هو موضح في القسم 2.2 من [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952).
negative_original_size (`tuple[int]`، *اختياري*، القيمة الافتراضية (1024, 1024)) : يُستخدم لتقييد عملية التوليد سلبياً بناءً على دقة صورة محددة. وهو جزء من التكييف الدقيق (micro-conditioning) في SDXL كما هو موضح في القسم 2.2 من [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952). لمزيد من المعلومات، راجع موضوع هذا المسألة: https://github.com/huggingface/diffusers/issues/4208.
negative_crops_coords_top_left (`tuple[int]`، *اختياري*، القيمة الافتراضية (0, 0)) : يُستخدم لتوجيه عملية التوليد سلبياً بناءً على إحداثيات قصّ محددة. وهو جزء من التكييف الدقيق (micro-conditioning) في SDXL كما هو موضح في القسم 2.2 من [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952). لمزيد من المعلومات، راجع موضوع هذا الإشكال: https://github.com/huggingface/diffusers/issues/4208.
negative_target_size (`tuple[int]`، *اختياري*، القيمة الافتراضية (1024, 1024)) : يُستخدم لتقييد عملية التوليد سلبياً بناءً على دقة الصورة المستهدفة. يجب أن تكون مطابقة لـ `target_size` في معظم الحالات. وهو جزء من التكييف الدقيق (micro-conditioning) في SDXL كما هو موضح في القسم 2.2 من [https://huggingface.co/papers/2307.01952](https://huggingface.co/papers/2307.01952). لمزيد من المعلومات، راجع موضوع هذا الإشكال: https://github.com/huggingface/diffusers/issues/4208.
clip_skip (`int`, *اختياري*) : عدد الطبقات التي سيتم تجاوزها من CLIP أثناء حساب تمثيلات الموجه. القيمة 1 تعني أنه سيتم استخدام مخرجات الطبقة قبل الأخيرة لحساب تمثيلات الموجه.
callback_on_step_end (`Callable`، *اختياري*) : دالة تُستدعى في نهاية كل خطوة إزالة ضوضاء أثناء الاستدلال. تُستدعى الدالة بالحجج التالية: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. سيتضمن `callback_kwargs` قائمة بجميع المصفوفات كما حددتها `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`، *اختياري*) : قائمة مدخلات المصفوفات (tensors) لدالة `callback_on_step_end`. سيتم تمرير المصفوفات المحددة في القائمة كحجة `callback_kwargs`. لن تتمكن من تضمين سوى المتغيرات المدرجة في خاصية `._callback_tensor_inputs` لفئة خط الأنابيب (pipeline) الخاص بك.
**يعيد:** [AnimateDiffPipelineOutput](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) أو `tuple`
إذا كان `return_dict` هو `True`، يُعاد [AnimateDiffPipelineOutput](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput)، وإلا يُعاد `tuple` يكون عنصره الأول قائمة تحتوي على الإطارات المولّدة.
الدالة التي تُستدعى عند استدعاء خط الأنابيب للتوليد.
أمثلة:
```py
>>> import torch
>>> from diffusers.models import MotionAdapter
>>> from diffusers import AnimateDiffSDXLPipeline, DDIMScheduler
>>> from diffusers.utils import export_to_gif
>>> adapter = MotionAdapter.from_pretrained(
... "a-r-r-o-w/animatediff-motion-adapter-sdxl-beta", torch_dtype=torch.float16
... )
>>> model_id = "stabilityai/stable-diffusion-xl-base-1.0"
>>> scheduler = DDIMScheduler.from_pretrained(
... model_id,
... subfolder="scheduler",
... clip_sample=False,
... timestep_spacing="linspace",
... beta_schedule="linear",
... steps_offset=1,
... )
>>> pipe = AnimateDiffSDXLPipeline.from_pretrained(
... model_id,
... motion_adapter=adapter,
... scheduler=scheduler,
... torch_dtype=torch.float16,
... variant="fp16",
... ).to("cuda")
>>> # enable memory savings
>>> pipe.vae.enable_slicing()
>>> pipe.vae.enable_tiling()
>>> output = pipe(
... prompt="a panda surfing in the ocean, realistic, high quality",
... negative_prompt="low quality, worst quality",
... num_inference_steps=20,
... guidance_scale=8,
... width=1024,
... height=1024,
... num_frames=16,
... )
>>> frames = output.frames[0]
>>> export_to_gif(frames, "animation.gif")
```
#### encode_prompt[[diffusers.AnimateDiffSDXLPipeline.encode_prompt]]
```python
encode_prompt(prompt: str, prompt_2: str | None = None, device: typing.Optional[torch.device] = None, num_videos_per_prompt: int = 1, do_classifier_free_guidance: bool = True, negative_prompt: str | None = None, negative_prompt_2: str | None = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, negative_pooled_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L327)
**المعاملات:**
prompt (`str` أو `list[str]`، *اختياري*) : النص الذي سيتم ترميزه
prompt_2 (`str` أو `list[str]`، *اختياري*) : الموجه أو الموجهات المرسل إلى `tokenizer_2` و`text_encoder_2`. إذا لم يُعرَّف، يُستخدم `prompt` في كلا مشفّري النص
device : (`torch.device`): جهاز torch
num_videos_per_prompt (`int`) : عدد الصور التي يجب توليدها لكل موجه
do_classifier_free_guidance (`bool`) : ما إذا كان سيتم استخدام التوجيه الحر للتصنيف أم لا
negative_prompt (`str` أو `list[str]`، *اختياري*) : الموجه أو الموجهات التي لا ينبغي توجيه توليد الصورة بها. إذا لم يُعرَّف، يجب تمرير `negative_prompt_embeds` بدلاً من ذلك. يتم تجاهله عند عدم استخدام التوجيه (أي يتم تجاهله إذا كان `guidance_scale` أقل من `1`).
negative_prompt_2 (`str` أو `list[str]`، *اختياري*) : الموجه أو الموجهات التي لا ينبغي توجيه توليد الصورة إليها، والتي سيتم إرسالها إلى `tokenizer_2` و`text_encoder_2`. إذا لم يُعرَّف، يُستخدم `negative_prompt` في كلا مشفري النص
prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد تمثيلات النص من معامل الإدخال `prompt`.
negative_prompt_embeds (`torch.Tensor`, *اختياري*) : تمثيلات نصية سالبة مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد negative_prompt_embeds من معامل الإدخال `negative_prompt`.
pooled_prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية مجمّعة مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد تمثيلات نصية مجمّعة من معامل الإدخال `prompt`.
negative_pooled_prompt_embeds (`torch.Tensor`, *اختياري*) : تمثيلات نصية مجمعة سالبة مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد pooled negative_prompt_embeds من معامل الإدخال `negative_prompt`.
lora_scale (`float`، *اختياري*) : مقياس lora سيُطبَّق على جميع طبقات LoRA في مُشفِّر النص إذا كانت طبقات LoRA محمَّلة.
clip_skip (`int`, *اختياري*) : عدد الطبقات التي سيتم تجاوزها من CLIP أثناء حساب تمثيلات الموجه. القيمة 1 تعني أنه سيتم استخدام مخرجات الطبقة قبل الأخيرة لحساب تمثيلات الموجه.
يقوم بتشفير الموجه إلى حالات مخفية لمشفّر النص.
#### get_guidance_scale_embedding[[diffusers.AnimateDiffSDXLPipeline.get_guidance_scale_embedding]]
```python
get_guidance_scale_embedding(w: Tensor, embedding_dim: int = 512, dtype: dtype = torch.float32)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_sdxl.py#L804)
**المعاملات:**
w (`torch.Tensor`) : توليد متجهات تضمين بمقياس توجيه محدد لتُثري متضمينات خطوات الزمن اللاحقة.
embedding_dim (`int`، *اختياري*، القيمة الافتراضية 512) : بُعد التضمينات (embeddings) التي سيتم توليدها.
dtype (`torch.dtype`، *اختياري*، الافتراضي `torch.float32`) : نوع البيانات للتضمينات المولّدة.
**يعيد:** `torch.Tensor`
متجهات تضمين بشكل `(len(w), embedding_dim)`.
انظر إلى https://github.com/google-research/vdm/blob/dc27b98a554f65cdc654b800da5aa1846545d41b/model_vdm.py#L298
## AnimateDiffVideoToVideoPipeline[[diffusers.AnimateDiffVideoToVideoPipeline]]
#### diffusers.AnimateDiffVideoToVideoPipeline[[diffusers.AnimateDiffVideoToVideoPipeline]]
```python
diffusers.AnimateDiffVideoToVideoPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L181)
**المعاملات:**
vae ([AutoencoderKL](/docs/diffusers/main/ar/api/models/autoencoderkl#diffusers.AutoencoderKL)) : نموذج الترميز التحويلي التبايني (VAE) لتشفير وفك تشفير الصور إلى تمثيلات كامنة ومنها.
text_encoder (`CLIPTextModel`) : مُشفِّر نص ثابت ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) لتجزئة النص.
unet ([UNet2DConditionModel](/docs/diffusers/main/ar/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : نموذج [UNet2DConditionModel](/docs/diffusers/main/ar/api/models/unet2d-cond#diffusers.UNet2DConditionModel) يُستخدم لإنشاء UNetMotionModel لإزالة الضوضاء من كائنات الفيديو المُرمّزة.
motion_adapter (`MotionAdapter`) : مُكيّف حركة `MotionAdapter` يُستخدم بالاقتران مع `unet` لإزالة الضوضاء من كامنات الفيديو المُرمّزة.
scheduler ([SchedulerMixin](/docs/diffusers/main/ar/api/schedulers/overview#diffusers.SchedulerMixin)) : مُجدول يُستخدم بالاقتران مع `unet` لإزالة الضوضاء من كائنات الصورة المُرمّزة. يمكن أن يكون أحد [DDIMScheduler](/docs/diffusers/main/ar/api/schedulers/ddim#diffusers.DDIMScheduler) أو [LMSDiscreteScheduler](/docs/diffusers/main/ar/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) أو [PNDMScheduler](/docs/diffusers/main/ar/api/schedulers/pndm#diffusers.PNDMScheduler).
خط أنابيب لتوليد فيديو من فيديو.
يرث هذا النموذج من [DiffusionPipeline](/docs/diffusers/main/ar/api/pipelines/overview#diffusers.DiffusionPipeline). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة المُنفَّذة لجميع خطوط الأنابيب (التنزيل، الحفظ، التشغيل على جهاز معين، إلخ).
تورث خط الأنابيب أيضًا طرق التحميل التالية:
- [load_textual_inversion()](/docs/diffusers/main/ar/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) لتحميل تضمينات الانعكاس النصي
- [load_lora_weights()](/docs/diffusers/main/ar/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) لتحميل أوزان LoRA
- [save_lora_weights()](/docs/diffusers/main/ar/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) لحفظ أوزان LoRA
- [load_ip_adapter()](/docs/diffusers/main/ar/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) لتحميل وحدات IP Adapter
#### __call__[[diffusers.AnimateDiffVideoToVideoPipeline.__call__]]
```python
__call__(video: list = None, prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, enforce_inference_steps: bool = False, timesteps: list[int] | None = None, sigmas: list[float] | None = None, guidance_scale: float = 7.5, strength: float = 0.8, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'], decode_chunk_size: int = 16)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L744)
**المعاملات:**
video (`list[PipelineImageInput]`) : الفيديو المُدخل الذي تُشترط عليه عملية التوليد. يجب أن يكون قائمةً من الصور/الإطارات الخاصة بالفيديو.
prompt (`str` أو `list[str]`، *اختياري*) : الأمر أو الأوامر التي تُوجّه توليد الصورة. إذا لم تُعرَّف، يجب عليك تمرير `prompt_embeds`.
height (`int`، *اختياري*، القيمة الافتراضية هي `self.unet.config.sample_size * self.vae_scale_factor`) : ارتفاع الفيديو المولّد بالبكسل.
width (`int`، *اختياري*، القيمة الافتراضية هي `self.unet.config.sample_size * self.vae_scale_factor`) : عرض الفيديو المولّد بالبكسل.
num_inference_steps (`int`، *اختياري*، القيمة الافتراضية 50) : عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى فيديوهات بجودة أعلى على حساب بطء الاستدلال.
enforce_inference_steps (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان يجب فرض خطوات إزالة الضوضاء `num_inference_steps` بغض النظر عن معامل `strength`. عند تعيين `False`، يتم تقليل عدد خطوات الاستدلال الفعلي وفقاً لقيمة `strength`.
timesteps (`list[int]`، *اختياري*) : خطوات زمنية مخصصة لاستخدامها في عملية إزالة الضوضاء مع المجدولين الذين يدعمون معامل `timesteps` في طريقة `set_timesteps` الخاصة بهم. إذا لم يُعرَّف، فسيتم استخدام السلوك الافتراضي عند تمرير `num_inference_steps`. يجب أن تكون بترتيب تنازلي.
sigmas (`list[float]`، *اختياري*) : قيم `sigmas` مخصصة لاستخدامها في عملية إزالة الضوضاء مع المجدولين الذين يدعمون معامل `sigmas` في طريقة `set_timesteps` الخاصة بهم. إذا لم تُعرَّف، فسيتم استخدام السلوك الافتراضي عند تمرير `num_inference_steps`.
strength (`float`، *اختياري*، القيمة الافتراضية 0.8) : كلما زادت القوة، زادت الفروق بين الفيديو الأصلي والفيديو المولّد.
guidance_scale (`float`, *اختياري*, القيمة الافتراضية 7.5) : كلما زادت قيمة مقياس التوجيه، شجّع النموذج على توليد صور مرتبطة ارتباطًا وثيقًا بنص `prompt` على حساب انخفاض جودة الصورة. يتم تفعيل مقياس التوجيه عندما يكون `guidance_scale > 1`.
negative_prompt (`str` أو `list[str]`، *اختياري*) : الأمر أو الأوامر التي توجّه ما يجب عدم تضمينه في توليد الصورة. إذا لم يُعرَّف، يجب عليك تمرير `negative_prompt_embeds` بدلاً من ذلك. يتم تجاهله عند عدم استخدام التوجيه (`guidance_scale < 1`).
num_videos_per_prompt (`int`، *اختياري*، القيمة الافتراضية 1) : عدد مقاطع الفيديو التي سيتم توليدها لكل موجه.
eta (`float`، *اختياري*، القيمة الافتراضية 0.0) : يتوافق مع المعامل eta (η) من ورقة [DDIM](https://huggingface.co/papers/2010.02502). ينطبق فقط على [DDIMScheduler](/docs/diffusers/main/ar/api/schedulers/ddim#diffusers.DDIMScheduler)، ويُتجاهل في جدولة أخرى.
generator (`torch.Generator` أو `list[torch.Generator]`، *اختياري*) : [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) لجعل التوليد حتميًا.
latents (`torch.Tensor`، *اختياري*) : كامنات ضجيج مُولّدة مسبقًا، مُستخرجة من توزيع غاوسي، تُستخدم كمدخلات لتوليد الفيديو. يمكن استخدامها لتعديل نفس التوليد باستخدام أوامر مختلفة. إذا لم تُقدَّم، يتم توليد كامنات عن طريق الاستخراج باستخدام `generator` العشوائي المُقدَّم. يجب أن تكون الكامنات على شكل `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة (وزن الأوامر). إذا لم تُقدَّم، يتم توليد تمثيلات النص من معامل الإدخال `prompt`.
negative_prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية سالبة مُولّدة مسبقًا. يمكن استخدامها لضبط مدخلات النص بسهولة (وزن الموجه). إذا لم تُقدَّم، يتم توليد `negative_prompt_embeds` من معامل الإدخال `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`، *اختياري*): إدخال صورة اختياري للعمل مع IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *اختياري*) : تمثيلات صور مُولّدة مسبقًا لـ IP-Adapter. يجب أن يكون قائمة بطول يساوي عدد وحدات IP-adapter. يجب أن يكون كل عنصر منها متجهًا (tensor) بشكل `(batch_size, num_images, emb_dim)`. يجب أن يحتوي على تمثيل الصورة السلبية إذا كان `do_classifier_free_guidance` مضبوطًا على `True`. إذا لم يُقدَّم، تُحسب التمثيلات من معامل الإدخال `ip_adapter_image`.
output_type (`str`، *اختياري*، الافتراضي `"pil"`) : صيغة مخرجات الفيديو المولّد. اختر بين `torch.Tensor` و`PIL.Image` أو `np.array`.
return_dict (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إرجاع `AnimateDiffPipelineOutput` بدلاً من tuple عادي.
cross_attention_kwargs (`dict`، *اختياري*) : قاموس kwargs يُمرَّر إلى `AttentionProcessor` إذا تم تحديده، كما هو معرّف في [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
clip_skip (`int`, *اختياري*) : عدد الطبقات التي سيتم تجاوزها من CLIP أثناء حساب تمثيلات الموجه. القيمة 1 تعني أنه سيتم استخدام مخرجات الطبقة قبل الأخيرة لحساب تمثيلات الموجه.
callback_on_step_end (`Callable`، *اختياري*) : دالة تُستدعى في نهاية كل خطوة إزالة ضوضاء أثناء الاستدلال. تُستدعى الدالة بالحجج التالية: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. سيتضمن `callback_kwargs` قائمة بجميع المصفوفات كما حددتها `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`، *اختياري*) : قائمة مدخلات المصفوفات (tensors) لدالة `callback_on_step_end`. سيتم تمرير المصفوفات المحددة في القائمة كحجة `callback_kwargs`. لن تتمكن من تضمين سوى المتغيرات المدرجة في خاصية `._callback_tensor_inputs` لفئة خط الأنابيب (pipeline) الخاص بك.
decode_chunk_size (`int`، القيمة الافتراضية `16`) : عدد الإطارات التي يتم فك ترميزها في كل مرة عند استدعاء طريقة `decode_latents`.
**يعيد:** [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) أو `tuple`
إذا كان `return_dict` هو `True`، يُعاد [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput)، وإلا يُعاد `tuple` حيث يكون العنصر الأول قائمة تحتوي على الإطارات المولّدة.
دالة الاستدعاء call لخط الأنابيب pipeline الخاص بالتوليد.
أمثلة:
#### encode_prompt[[diffusers.AnimateDiffVideoToVideoPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video.py#L256)
**المعاملات:**
prompt (`str` أو `list[str]`، *اختياري*) : النص الذي سيتم ترميزه
device : (`torch.device`): جهاز torch
num_images_per_prompt (`int`) : عدد الصور التي يجب توليدها لكل موجه
do_classifier_free_guidance (`bool`) : ما إذا كان سيتم استخدام التوجيه الحر للتصنيف أم لا
negative_prompt (`str` أو `list[str]`، *اختياري*) : الموجه أو الموجهات التي لا ينبغي توجيه توليد الصورة بها. إذا لم يُعرَّف، يجب تمرير `negative_prompt_embeds` بدلاً من ذلك. يتم تجاهله عند عدم استخدام التوجيه (أي يتم تجاهله إذا كان `guidance_scale` أقل من `1`).
prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد تمثيلات النص من معامل الإدخال `prompt`.
negative_prompt_embeds (`torch.Tensor`, *اختياري*) : تمثيلات نصية سالبة مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد negative_prompt_embeds من معامل الإدخال `negative_prompt`.
lora_scale (`float`، *اختياري*) : مقياس LoRA سيُطبَّق على جميع طبقات LoRA في مُشفِّر النص إذا كانت طبقات LoRA محمَّلة.
clip_skip (`int`, *اختياري*) : عدد الطبقات التي سيتم تجاوزها من CLIP أثناء حساب تمثيلات الموجه. القيمة 1 تعني أنه سيتم استخدام مخرجات الطبقة قبل الأخيرة لحساب تمثيلات الموجه.
يقوم بتشفير الموجه إلى حالات مخفية لمشفّر النص.
## AnimateDiffVideoToVideoControlNetPipeline[[diffusers.AnimateDiffVideoToVideoControlNetPipeline]]
#### diffusers.AnimateDiffVideoToVideoControlNetPipeline[[diffusers.AnimateDiffVideoToVideoControlNetPipeline]]
```python
diffusers.AnimateDiffVideoToVideoControlNetPipeline(vae: AutoencoderKL, text_encoder: CLIPTextModel, tokenizer: CLIPTokenizer, unet: diffusers.models.unets.unet_2d_condition.UNet2DConditionModel | diffusers.models.unets.unet_motion_model.UNetMotionModel, motion_adapter: MotionAdapter, controlnet: diffusers.models.controlnets.controlnet.ControlNetModel | list[diffusers.models.controlnets.controlnet.ControlNetModel] | tuple[diffusers.models.controlnets.controlnet.ControlNetModel] | diffusers.models.controlnets.multicontrolnet.MultiControlNetModel, scheduler: diffusers.schedulers.scheduling_ddim.DDIMScheduler | diffusers.schedulers.scheduling_pndm.PNDMScheduler | diffusers.utils.dummy_torch_and_scipy_objects.LMSDiscreteScheduler | diffusers.schedulers.scheduling_euler_discrete.EulerDiscreteScheduler | diffusers.schedulers.scheduling_euler_ancestral_discrete.EulerAncestralDiscreteScheduler | diffusers.schedulers.scheduling_dpmsolver_multistep.DPMSolverMultistepScheduler, feature_extractor: CLIPImageProcessorPil = None, image_encoder: CLIPVisionModelWithProjection = None)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L199)
**المعاملات:**
vae ([AutoencoderKL](/docs/diffusers/main/ar/api/models/autoencoderkl#diffusers.AutoencoderKL)) : نموذج الترميز التحويلي التبايني (VAE) لتشفير وفك تشفير الصور إلى تمثيلات كامنة ومنها.
text_encoder (`CLIPTextModel`) : مُشفِّر نص ثابت ([clip-vit-large-patch14](https://huggingface.co/openai/clip-vit-large-patch14)).
tokenizer (`CLIPTokenizer`) : [CLIPTokenizer](https://huggingface.co/docs/transformers/main/en/model_doc/clip#transformers.CLIPTokenizer) لتجزئة النص.
unet ([UNet2DConditionModel](/docs/diffusers/main/ar/api/models/unet2d-cond#diffusers.UNet2DConditionModel)) : نموذج [UNet2DConditionModel](/docs/diffusers/main/ar/api/models/unet2d-cond#diffusers.UNet2DConditionModel) يُستخدم لإنشاء UNetMotionModel لإزالة الضوضاء من كائنات الفيديو المُرمّزة.
motion_adapter (`MotionAdapter`) : مُكيّف حركة `MotionAdapter` يُستخدم بالاقتران مع `unet` لإزالة الضوضاء من كامنات الفيديو المُرمّزة.
controlnet ([ControlNetModel](/docs/diffusers/main/ar/api/models/controlnet#diffusers.ControlNetModel) أو `list[ControlNetModel]` أو `tuple[ControlNetModel]` أو `MultiControlNetModel`) : يوفر شروطًا إضافية لـ `unet` أثناء عملية إزالة الضوضاء. إذا قمت بتعيين عدة وحدات ControlNet كقائمة، فإن المخرجات من كل وحدة ControlNet تُجمع معًا لإنشاء شرط إضافي واحد موحّد.
scheduler ([SchedulerMixin](/docs/diffusers/main/ar/api/schedulers/overview#diffusers.SchedulerMixin)) : مُجدول يُستخدم بالاقتران مع `unet` لإزالة الضوضاء من كائنات الصورة المُرمّزة. يمكن أن يكون أحد [DDIMScheduler](/docs/diffusers/main/ar/api/schedulers/ddim#diffusers.DDIMScheduler) أو [LMSDiscreteScheduler](/docs/diffusers/main/ar/api/schedulers/lms_discrete#diffusers.LMSDiscreteScheduler) أو [PNDMScheduler](/docs/diffusers/main/ar/api/schedulers/pndm#diffusers.PNDMScheduler).
خط أنابيب لتوليد فيديو من فيديو مع توجيه ControlNet.
يرث هذا النموذج من [DiffusionPipeline](/docs/diffusers/main/ar/api/pipelines/overview#diffusers.DiffusionPipeline). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة المُنفَّذة لجميع خطوط الأنابيب (التنزيل، الحفظ، التشغيل على جهاز معين، إلخ).
تورث خط الأنابيب أيضًا طرق التحميل التالية:
- [load_textual_inversion()](/docs/diffusers/main/ar/api/loaders/textual_inversion#diffusers.loaders.TextualInversionLoaderMixin.load_textual_inversion) لتحميل تضمينات الانعكاس النصي
- [load_lora_weights()](/docs/diffusers/main/ar/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.load_lora_weights) لتحميل أوزان LoRA
- [save_lora_weights()](/docs/diffusers/main/ar/api/loaders/lora#diffusers.loaders.StableDiffusionLoraLoaderMixin.save_lora_weights) لحفظ أوزان LoRA
- [load_ip_adapter()](/docs/diffusers/main/ar/api/loaders/ip_adapter#diffusers.loaders.IPAdapterMixin.load_ip_adapter) لتحميل وحدات IP Adapter
#### __call__[[diffusers.AnimateDiffVideoToVideoControlNetPipeline.__call__]]
```python
__call__(video: list = None, prompt: str | list[str] | None = None, height: int | None = None, width: int | None = None, num_inference_steps: int = 50, enforce_inference_steps: bool = False, timesteps: list[int] | None = None, sigmas: list[float] | None = None, guidance_scale: float = 7.5, strength: float = 0.8, negative_prompt: str | list[str] | None = None, num_videos_per_prompt: int | None = 1, eta: float = 0.0, generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = None, latents: typing.Optional[torch.Tensor] = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, ip_adapter_image: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], NoneType] = None, ip_adapter_image_embeds: list[torch.Tensor] | None = None, conditioning_frames: list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]] | None = None, output_type: str | None = 'pil', return_dict: bool = True, cross_attention_kwargs: dict[str, typing.Any] | None = None, controlnet_conditioning_scale: float | list[float] = 1.0, guess_mode: bool = False, control_guidance_start: float | list[float] = 0.0, control_guidance_end: float | list[float] = 1.0, clip_skip: int | None = None, callback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = None, callback_on_step_end_tensor_inputs: list = ['latents'], decode_chunk_size: int = 16)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L909)
**المعاملات:**
video (`list[PipelineImageInput]`) : الفيديو المُدخل الذي تُشترط عليه عملية التوليد. يجب أن يكون قائمةً من الصور/الإطارات الخاصة بالفيديو.
prompt (`str` أو `list[str]`، *اختياري*) : الأمر أو الأوامر التي تُوجّه توليد الصورة. إذا لم تُعرَّف، يجب عليك تمرير `prompt_embeds`.
height (`int`، *اختياري*، القيمة الافتراضية هي `self.unet.config.sample_size * self.vae_scale_factor`) : ارتفاع الفيديو المولّد بالبكسل.
width (`int`، *اختياري*، القيمة الافتراضية هي `self.unet.config.sample_size * self.vae_scale_factor`) : عرض الفيديو المولّد بالبكسل.
num_inference_steps (`int`، *اختياري*، القيمة الافتراضية 50) : عدد خطوات إزالة الضوضاء. تؤدي زيادة عدد خطوات إزالة الضوضاء عادةً إلى فيديوهات بجودة أعلى على حساب بطء الاستدلال.
enforce_inference_steps (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان يجب فرض خطوات إزالة الضوضاء `num_inference_steps` بغض النظر عن معامل `strength`. عند تعيين `False`، يتم تقليل عدد خطوات الاستدلال الفعلي وفقاً لقيمة `strength`.
timesteps (`list[int]`، *اختياري*) : خطوات زمنية مخصصة لاستخدامها في عملية إزالة الضوضاء مع المجدولين الذين يدعمون معامل `timesteps` في طريقة `set_timesteps` الخاصة بهم. إذا لم يُعرَّف، فسيتم استخدام السلوك الافتراضي عند تمرير `num_inference_steps`. يجب أن تكون بترتيب تنازلي.
sigmas (`list[float]`، *اختياري*) : قيم `sigmas` مخصصة لاستخدامها في عملية إزالة الضوضاء مع المجدولين الذين يدعمون معامل `sigmas` في طريقة `set_timesteps` الخاصة بهم. إذا لم تُعرَّف، فسيتم استخدام السلوك الافتراضي عند تمرير `num_inference_steps`.
strength (`float`، *اختياري*، القيمة الافتراضية 0.8) : كلما زادت القوة، زادت الفروق بين الفيديو الأصلي والفيديو المولّد.
guidance_scale (`float`, *اختياري*, القيمة الافتراضية 7.5) : كلما زادت قيمة مقياس التوجيه، شجّع النموذج على توليد صور مرتبطة ارتباطًا وثيقًا بنص `prompt` على حساب انخفاض جودة الصورة. يتم تفعيل مقياس التوجيه عندما يكون `guidance_scale > 1`.
negative_prompt (`str` أو `list[str]`، *اختياري*) : الأمر أو الأوامر التي توجّه ما يجب عدم تضمينه في توليد الصورة. إذا لم يُعرَّف، يجب عليك تمرير `negative_prompt_embeds` بدلاً من ذلك. يتم تجاهله عند عدم استخدام التوجيه (`guidance_scale < 1`).
num_videos_per_prompt (`int`، *اختياري*، القيمة الافتراضية 1) : عدد مقاطع الفيديو التي سيتم توليدها لكل موجه.
eta (`float`، *اختياري*، القيمة الافتراضية 0.0) : يتوافق مع المعامل eta (η) من ورقة [DDIM](https://huggingface.co/papers/2010.02502). ينطبق فقط على [DDIMScheduler](/docs/diffusers/main/ar/api/schedulers/ddim#diffusers.DDIMScheduler)، ويُتجاهل في جدولة أخرى.
generator (`torch.Generator` أو `list[torch.Generator]`، *اختياري*) : [`torch.Generator`](https://pytorch.org/docs/stable/generated/torch.Generator.html) لجعل التوليد حتميًا.
latents (`torch.Tensor`، *اختياري*) : كامنات ضجيج مُولّدة مسبقًا، مُستخرجة من توزيع غاوسي، تُستخدم كمدخلات لتوليد الفيديو. يمكن استخدامها لتعديل نفس التوليد باستخدام أوامر مختلفة. إذا لم تُقدَّم، يتم توليد كامنات عن طريق الاستخراج باستخدام `generator` العشوائي المُقدَّم. يجب أن تكون الكامنات على شكل `(batch_size, num_channel, num_frames, height, width)`.
prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة (وزن الأوامر). إذا لم تُقدَّم، يتم توليد تمثيلات النص من معامل الإدخال `prompt`.
negative_prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية سالبة مُولّدة مسبقًا. يمكن استخدامها لضبط مدخلات النص بسهولة (وزن الموجه). إذا لم تُقدَّم، يتم توليد `negative_prompt_embeds` من معامل الإدخال `negative_prompt`.
ip_adapter_image : (`PipelineImageInput`، *اختياري*): إدخال صورة اختياري للعمل مع IP Adapters.
ip_adapter_image_embeds (`list[torch.Tensor]`, *اختياري*) : تمثيلات صور مُولّدة مسبقًا لـ IP-Adapter. يجب أن يكون قائمة بطول يساوي عدد وحدات IP-adapter. يجب أن يكون كل عنصر منها متجهًا (tensor) بشكل `(batch_size, num_images, emb_dim)`. يجب أن يحتوي على تمثيل الصورة السلبية إذا كان `do_classifier_free_guidance` مضبوطًا على `True`. إذا لم يُقدَّم، تُحسب التمثيلات من معامل الإدخال `ip_adapter_image`.
conditioning_frames (`list[PipelineImageInput]`، *اختياري*) : شرط الإدخال الخاص بـ ControlNet لتوفير التوجيه إلى `unet` للتوليد. إذا تم تحديد عدة وحدات ControlNet، فيجب تمرير الصور كقائمة بحيث يمكن تجميع كل عنصر من عناصر القائمة بشكل صحيح للإدخال إلى وحدة ControlNet واحدة.
output_type (`str`، *اختياري*، الافتراضي `"pil"`) : صيغة مخرجات الفيديو المولّد. اختر بين `torch.Tensor` و`PIL.Image` أو `np.array`.
return_dict (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إرجاع `AnimateDiffPipelineOutput` بدلاً من tuple عادي.
cross_attention_kwargs (`dict`، *اختياري*) : قاموس kwargs يُمرَّر إلى `AttentionProcessor` إذا تم تحديده، كما هو معرّف في [`self.processor`](https://github.com/huggingface/diffusers/blob/main/src/diffusers/models/attention_processor.py).
controlnet_conditioning_scale (`float` أو `list[float]`، *اختياري*، القيمة الافتراضية 1.0) : تُضرب مخرجات ControlNet في `controlnet_conditioning_scale` قبل إضافتها إلى الباقي في `unet` الأصلية. إذا تم تحديد عدة ControlNets في `init`، يمكنك تعيين المقياس المقابل كقائمة.
guess_mode (`bool`، *اختياري*، القيمة الافتراضية `False`) : يحاول مُشفِّر ControlNet التعرف على محتوى الصورة المُدخلة حتى إذا قمت بإزالة جميع الأوامر النصية. يُوصى بقيمة `guidance_scale` بين 3.0 و5.0.
control_guidance_start (`float` أو `list[float]`، *اختياري*، القيمة الافتراضية 0.0) : النسبة المئوية من إجمالي الخطوات التي يبدأ عندها ControlNet في التطبيق.
control_guidance_end (`float` أو `list[float]`، *اختياري*، القيمة الافتراضية 1.0) : النسبة المئوية من إجمالي الخطوات التي يتوقف عندها ControlNet عن التطبيق.
clip_skip (`int`, *اختياري*) : عدد الطبقات التي سيتم تجاوزها من CLIP أثناء حساب تمثيلات الموجه. القيمة 1 تعني أنه سيتم استخدام مخرجات الطبقة قبل الأخيرة لحساب تمثيلات الموجه.
callback_on_step_end (`Callable`، *اختياري*) : دالة تُستدعى في نهاية كل خطوة إزالة ضوضاء أثناء الاستدلال. تُستدعى الدالة بالحجج التالية: `callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict)`. سيتضمن `callback_kwargs` قائمة بجميع المصفوفات كما حددتها `callback_on_step_end_tensor_inputs`.
callback_on_step_end_tensor_inputs (`list`، *اختياري*) : قائمة مدخلات المصفوفات (tensors) لدالة `callback_on_step_end`. سيتم تمرير المصفوفات المحددة في القائمة كحجة `callback_kwargs`. لن تتمكن من تضمين سوى المتغيرات المدرجة في خاصية `._callback_tensor_inputs` لفئة خط الأنابيب (pipeline) الخاص بك.
decode_chunk_size (`int`، القيمة الافتراضية `16`) : عدد الإطارات التي يتم فك ترميزها في كل مرة عند استدعاء طريقة `decode_latents`.
**يعيد:** [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput) أو `tuple`
إذا كان `return_dict` هو `True`، يُعاد [pipelines.animatediff.pipeline_output.AnimateDiffPipelineOutput](/docs/diffusers/main/ar/api/pipelines/animatediff#diffusers.pipelines.animatediff.AnimateDiffPipelineOutput)، وإلا يُعاد `tuple` حيث يكون العنصر الأول قائمة تحتوي على الإطارات المولّدة.
دالة الاستدعاء call لخط الأنابيب pipeline الخاص بالتوليد.
أمثلة:
#### encode_prompt[[diffusers.AnimateDiffVideoToVideoControlNetPipeline.encode_prompt]]
```python
encode_prompt(prompt, device, num_images_per_prompt, do_classifier_free_guidance, negative_prompt = None, prompt_embeds: typing.Optional[torch.Tensor] = None, negative_prompt_embeds: typing.Optional[torch.Tensor] = None, lora_scale: float | None = None, clip_skip: int | None = None)
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_animatediff_video2video_controlnet.py#L287)
**المعاملات:**
prompt (`str` أو `list[str]`، *اختياري*) : النص الذي سيتم ترميزه
device : (`torch.device`): جهاز torch
num_images_per_prompt (`int`) : عدد الصور التي يجب توليدها لكل موجه
do_classifier_free_guidance (`bool`) : ما إذا كان سيتم استخدام التوجيه الحر للتصنيف أم لا
negative_prompt (`str` أو `list[str]`، *اختياري*) : الموجه أو الموجهات التي لا ينبغي توجيه توليد الصورة بها. إذا لم يُعرَّف، يجب تمرير `negative_prompt_embeds` بدلاً من ذلك. يتم تجاهله عند عدم استخدام التوجيه (أي يتم تجاهله إذا كان `guidance_scale` أقل من `1`).
prompt_embeds (`torch.Tensor`، *اختياري*) : تمثيلات نصية مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد تمثيلات النص من معامل الإدخال `prompt`.
negative_prompt_embeds (`torch.Tensor`, *اختياري*) : تمثيلات نصية سالبة مُولّدة مسبقًا. يمكن استخدامها لتعديل مدخلات النص بسهولة، *مثلًا* وزن الأوامر. إذا لم تُقدَّم، فسيتم توليد negative_prompt_embeds من معامل الإدخال `negative_prompt`.
lora_scale (`float`، *اختياري*) : مقياس LoRA سيُطبَّق على جميع طبقات LoRA في مُشفِّر النص إذا كانت طبقات LoRA محمَّلة.
clip_skip (`int`, *اختياري*) : عدد الطبقات التي سيتم تجاوزها من CLIP أثناء حساب تمثيلات الموجه. القيمة 1 تعني أنه سيتم استخدام مخرجات الطبقة قبل الأخيرة لحساب تمثيلات الموجه.
يقوم بتشفير الموجه إلى حالات مخفية لمشفّر النص.
## AnimateDiffPipelineOutput[[diffusers.pipelines.animatediff.AnimateDiffPipelineOutput]]
#### diffusers.pipelines.animatediff.AnimateDiffPipelineOutput[[diffusers.pipelines.animatediff.AnimateDiffPipelineOutput]]
```python
diffusers.pipelines.animatediff.AnimateDiffPipelineOutput(frames: typing.Union[torch.Tensor, numpy.ndarray, list[list[PIL.Image.Image]]])
```
[المصدر](https://github.com/huggingface/diffusers/blob/main/src/diffusers/pipelines/animatediff/pipeline_output.py#L11)
**المعاملات:**
frames (`torch.Tensor` أو `np.ndarray` أو list[list[PIL.Image.Image]]) : قائمة من مخرجات الفيديو - يمكن أن تكون قائمة متداخلة بطول `batch_size,` حيث تحتوي كل قائمة فرعية على
فئة الإخراج لخطوط أنابيب AnimateDiff.
تسلسلات صور PIL بطول `num_frames.` كما يمكن أن تكون مصفوفة NumPy أو متجه Torch من الشكل `(batch_size, num_frames, channels, height, width)`